8Modèles additifs et modèles additifs généralisés (GAM)
Dernière modification
9 octobre 2026
8.1 Motivation
Les méthodes non-paramétriques des Chapitre 6 et Chapitre 7 fonctionnent bien avec une ou deux variables explicatives, mais se heurtent au fléau de la dimension lorsque \(p\) est grand : les voisinages deviennent vides et le nombre de fonctions de base explose. Les modèles additifs offrent un compromis entre la flexibilité des méthodes non-paramétriques et l’interprétabilité des modèles linéaires : on remplace la partie linéaire par une somme de fonctions univariées, \[Y_i = \alpha + f_1(X_{i1}) + f_2(X_{i2}) + \cdots + f_p(X_{ip}) + \epsilon_i,\] où chaque \(f_j\) est une fonction lisse inconnue.
Laissons les données nous montrer la forme fonctionnelle appropriée.
Chaque \(f_j\) est représentée par une base de splines (Chapitre 7) : \(f_j(x) = \sum_{k=1}^{K_j} b_{jk}(x)\,\beta_{jk}\). Pour assurer l’identifiabilité (une constante peut être transférée entre \(\alpha\) et les \(f_j\)), on impose la contrainte de centrage \[\sum_{i=1}^n f_j(X_{ij}) = 0, \qquad j = 1,\ldots,p.\]
8.2 Estimation par moindres carrés pénalisés
Plutôt que de choisir soigneusement le nombre de nœuds de chaque base, on prend des bases « suffisamment riches » et on pénalise la rugosité de chaque fonction : on minimise \[\left\|\boldsymbol Y - \boldsymbol X\boldsymbol\beta\right\|^2 + \sum_{j=1}^p\lambda_j\,\boldsymbol\beta^\top \boldsymbol S_j\,\boldsymbol\beta,\] où \(\boldsymbol X\) regroupe toutes les fonctions de base évaluées aux observations, et \(\boldsymbol S_j\) est la matrice de pénalité de la \(j^{\text{ème}}\) fonction (\(\boldsymbol\beta^\top \boldsymbol S_j\boldsymbol\beta = \int f_j''(t)^2dt\)). La solution est explicite : \[\hat{\boldsymbol\beta} = \Bigl(\boldsymbol X^\top \boldsymbol X + \sum_{j=1}^p\lambda_j \boldsymbol S_j\Bigr)^{-1}\boldsymbol X^\top \boldsymbol Y.\] Chaque paramètre de lissage \(\lambda_j\) contrôle le compromis régularité/fidélité de la fonction \(f_j\) : \(\lambda_j\to\infty\) force \(f_j\) à être linéaire, \(\lambda_j = 0\) laisse \(f_j\) libre (risque de surajustement).
8.2.1 Matrice d’influence et degrés de liberté effectifs
Les valeurs ajustées s’écrivent \(\hat{\boldsymbol Y} = \boldsymbol A\boldsymbol Y\) avec \(\boldsymbol A = \boldsymbol X(\boldsymbol X^\top \boldsymbol X + \sum_j\lambda_j \boldsymbol S_j)^{-1}\boldsymbol X^\top\). Les degrés de liberté effectifs du modèle sont \(\mathrm{Tr}(\boldsymbol A)\) ; on peut les décomposer par fonction \(f_j\), ce qui donne une mesure interprétable de la complexité de chaque effet. La pénalisation induit un biais : \(E(\hat{\boldsymbol\beta})\neq\boldsymbol\beta\), exactement comme pour ridge.
8.2.2 Choix des paramètres de lissage
Les \(\lambda_j\) sont choisis en minimisant un estimateur de l’erreur de prédiction :
Validation croisée généralisée (GCV), qui remplace les \(A_{ii}\) par leur moyenne : \[GCV(\lambda) = \frac{n\sum_i(y_i - \hat f_\lambda(x_i))^2}{\left(n - \mathrm{Tr}(\boldsymbol A)\right)^2}.\]
8.2.3 Inférence
De la forme ridge de l’estimateur, on tire \(\hat{\boldsymbol\beta}\sim\mathcal{N}(E(\hat{\boldsymbol\beta}),\, \boldsymbol V_\beta)\) avec \(\boldsymbol V_\beta = \sigma^2(\boldsymbol X^\top \boldsymbol X + \sum_j\lambda_j \boldsymbol S_j)^{-1}\boldsymbol X^\top \boldsymbol X(\boldsymbol X^\top \boldsymbol X + \sum_j\lambda_j \boldsymbol S_j)^{-1}\) ; l’approche bayésienne (pénalité = loi a priori gaussienne sur \(\boldsymbol\beta\)) donne la forme plus simple \(\boldsymbol V_\beta = \sigma^2(\boldsymbol X^\top \boldsymbol X + \sum_j\lambda_j \boldsymbol S_j)^{-1}\), dont les intervalles de crédibilité \[\hat f_j(x) \pm z_{\alpha/2}\sqrt{\widehat{Var}[\hat f_j(x)]}\] possèdent de bonnes propriétés de couverture fréquentistes. Pour tester \(H_0: f_j = 0\), on utilise des statistiques de type Wald basées sur \(\hat{\boldsymbol\beta}_j^\top \boldsymbol V_{\beta_j}^{-1}\hat{\boldsymbol\beta}_j\), référées à une \(\chi^2\) (\(\phi\) connu) ou une \(F\) (\(\phi\) inconnu).
8.3 Modèles additifs généralisés
Comme pour les MLG, on combine la structure additive avec les distributions de la famille exponentielle : \(Y_i\) suit une loi de la famille exponentielle avec \(E[Y_i] = \mu_i\) et \[g(\mu_i) = \alpha + f_1(X_{i1}) + \cdots + f_p(X_{ip}),\] où \(g\) est une fonction de lien. Cas particuliers : GAM logistique (réponse binaire), GAM Poisson (dénombrements, avec offset au besoin).
L’estimation se fait en minimisant la déviance pénalisée : \[\hat{\boldsymbol\beta} = \arg\min_{\boldsymbol\beta}\left\{D(\boldsymbol y,\boldsymbol\mu) + \sum_{j=1}^p\lambda_j\,\boldsymbol\beta^\top \boldsymbol S_j\,\boldsymbol\beta\right\},\] où \(D(\boldsymbol y,\boldsymbol\mu)\) est la déviance du Chapitre 3.
construire les poids \[w_i^{(m)} = \frac{1}{V(\mu_i^{(m)})}\left(\frac{\partial\mu_i}{\partial\eta_i}\right)^2_{(m)}\,;\]
ajuster un modèle additif pénalisé pondéré à \(\boldsymbol z^{(m)}\) ;
répéter jusqu’à convergence.
8.3.2 Choix des paramètres de lissage et comparaison de modèles
Si \(\phi\) est connu (logistique, Poisson) : critère UBRE (équivalent au \(C_p\) de Mallows) \[UBRE(\lambda) = \frac{D(\boldsymbol y,\hat{\boldsymbol\mu})}{n} + \frac{2\phi\,\mathrm{Tr}(\boldsymbol A)}{n}\,;\]
si \(\phi\) est inconnu : GCV\[GCV(\lambda) = \frac{n\,D(\boldsymbol y,\hat{\boldsymbol\mu})}{\left(n - \mathrm{Tr}(\boldsymbol A)\right)^2}.\]
Pour comparer des modèles : \(AIC = -2\,l(\hat{\boldsymbol\beta};\boldsymbol y) + 2\,\mathrm{Tr}(\boldsymbol A)\) (les degrés de liberté effectifs remplacent le nombre de paramètres), GCV, ou proportion de déviance expliquée \((D_{null} - D)/D_{null}\). Plus petit \(AIC\) ou \(GCV\) = meilleur modèle.
8.3.3 En pratique avec R
La librairie mgcv ajuste les GAM avec sélection automatique des paramètres de lissage : s(x) déclare une fonction lisse de x (par défaut une spline de régression à k = 10 fonctions de base, pénalisée), les termes sans s() restent paramétriques, et family joue le même rôle que dans glm.
Exemple — Modèle additif gaussien : cycles journalier et saisonnier de l’ozone sur qualite_air
Au Chapitre 7, on a modélisé la concentration d’ozone à Longueuil en fonction de l’heure, pour les seuls mois d’été. On reprend ici l’année entière (\(n = 8\,727\) heures) avec deux variables explicatives : l’heure et le jour de l’année. Le modèle additif \[O_3 = \alpha + f_1(\mbox{heure}) + f_2(\mbox{jour}) + \epsilon\] suppose que le cycle journalier a la même forme toute l’année et que le cycle saisonnier est le même à toute heure.
library(mgcv)air <-read.csv("Jeux de données/qualite_air.csv", fileEncoding ="UTF-8-BOM")air$heure <-as.integer(substr(air$Date_Heure, 12, 13))air$jour <-as.integer(format(as.Date(substr(air$Date_Heure, 1, 10)), "%j"))longueuil <-subset(air, Station =="06600 - Longueuil"&!is.na(O3))mod1 <-gam(O3 ~s(heure) +s(jour), data = longueuil)summary(mod1)
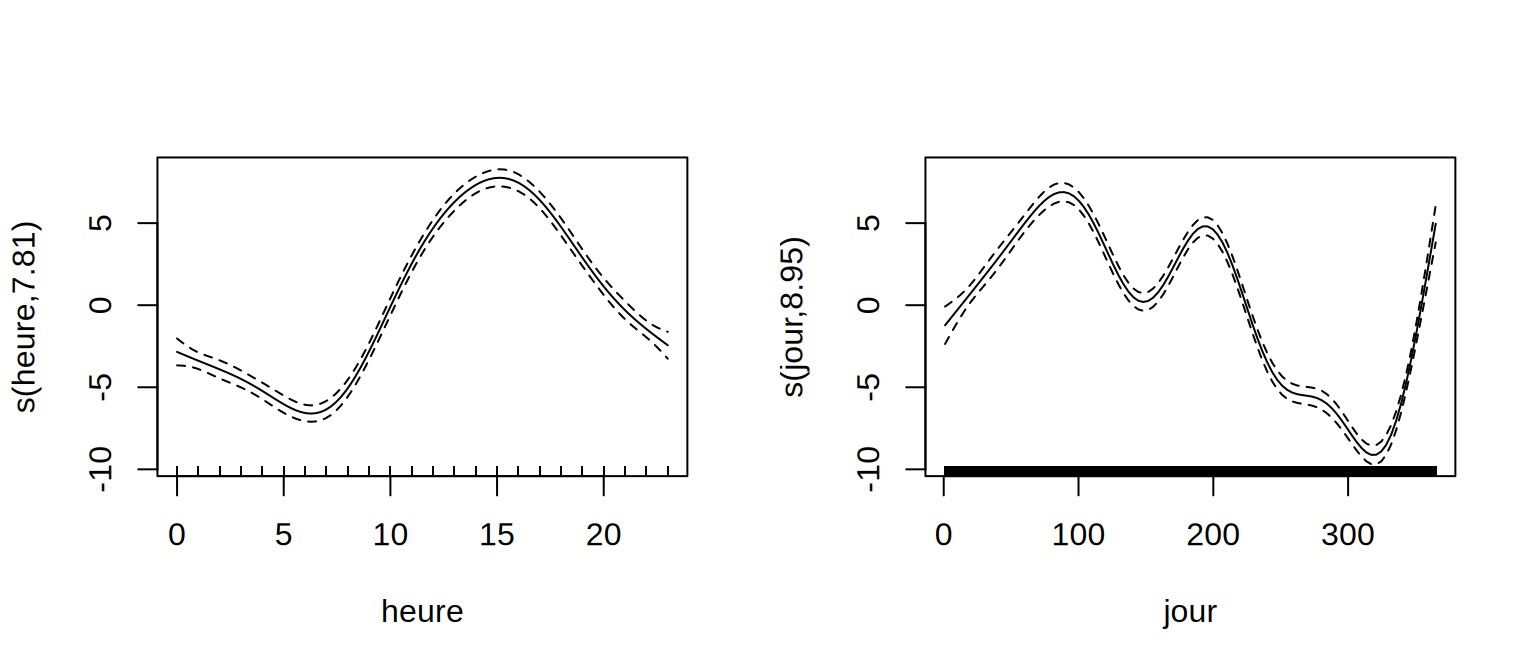
Figure 8.1: Fonctions \(\hat f_1\) (heure) et \(\hat f_2\) (jour de l’année) du modèle additif pour l’ozone à Longueuil, avec bandes de confiance à 95 %. Chaque fonction est centrée : elle représente l’écart à la moyenne \(\hat\alpha\).
La sortie de summary donne, pour chaque fonction lisse, ses degrés de liberté effectifs (edf) et un test approximatif de \(H_0 : f_j = 0\). Les deux fonctions sont clairement non nulles et non linéaires : \(\hat f_1\) reproduit la bosse journalière du Chapitre 7 (minimum vers 6 h, maximum vers 15 h) et \(\hat f_2\) montre le maximum printanier de l’ozone (vers le jour 90, en avril), un second sommet en juillet et un creux en novembre. Le modèle explique 35 % de la variance, contre 14 % pour le modèle linéaire en heure et jour.
Deux remarques. D’abord, s(jour) utilise presque tous ses 9 degrés de liberté disponibles ; en augmentant k, la courbe se met à suivre les épisodes météorologiques de quelques jours, parce que les heures consécutives sont corrélées et que la GCV sous-lisse alors (voir la remarque du Chapitre 7). Ensuite, l’hypothèse d’additivité est discutable, puisque l’amplitude du cycle journalier est plus grande en été qu’en hiver ; mgcv permet d’ajuster une surface \(f(\mbox{heure}, \mbox{jour})\) avec te(heure, jour), au prix de l’interprétation séparée des deux effets.
Exemple — GAM logistique : strate du couvert sur arbres
Au Chapitre 6, on a estimé par \(k\)NN la probabilité qu’un arbre soit dans la strate inférieure du couvert en fonction de son diamètre, sans forme paramétrique. Le GAM logistique fait de même, en ajoutant l’espèce comme terme paramétrique. Pour l’arbre \(i\), on note \(Y_i = 1\) s’il est dans la strate inférieure (intermédiaire ou opprimé) et \(Y_i = 0\) sinon, \(D_i\) son diamètre (en cm) et \(e(i) \in \{\mbox{bouleau}, \mbox{épinette}, \mbox{érable}, \mbox{sapin}\}\) son espèce. Le modèle suppose \(Y_i \sim \mbox{Bernoulli}(\pi_i)\), indépendants, avec \[\mbox{logit}\,\pi_i = \log\frac{\pi_i}{1 - \pi_i} = \alpha + f(D_i) + \gamma_{e(i)},\] où
\(f\) est une fonction lisse inconnue du diamètre, représentée par une spline de régression pénalisée à 10 fonctions de base (s(diameter_cm)) et centrée, \(\sum_i f(D_i) = 0\), pour qu’elle soit identifiable séparément de \(\alpha\) ;
\(\gamma_{e}\) est l’effet de l’espèce, un terme paramétrique ordinaire avec le bouleau à papier comme niveau de référence (\(\gamma_{\text{bouleau}} = 0\)), de sorte que \(e^{\gamma_e}\) est le rapport de cotes de la strate inférieure entre l’espèce \(e\) et le bouleau, à diamètre égal ;
\(\alpha\) est le logit de la probabilité pour un bouleau de diamètre « moyen » au sens de la contrainte de centrage.
C’est la régression logistique du Chapitre 2, à ceci près que l’effet du diamètre n’est pas contraint à être linéaire sur l’échelle logit : le paramètre de lissage de \(f\) est choisi par UBRE, et c’est lui qui décide, au vu des données, du degré de courbure nécessaire.
arbres <-read.csv("Jeux de données/arbres.csv")arbres$inferieure <-as.integer(arbres$canopy_stratum %in%c("Intermédiaire", "Opprimé"))arbres$espece <-factor(arbres$species_fr)mod2 <-gam(inferieure ~s(diameter_cm) + espece, family = binomial, data = arbres)summary(mod2)
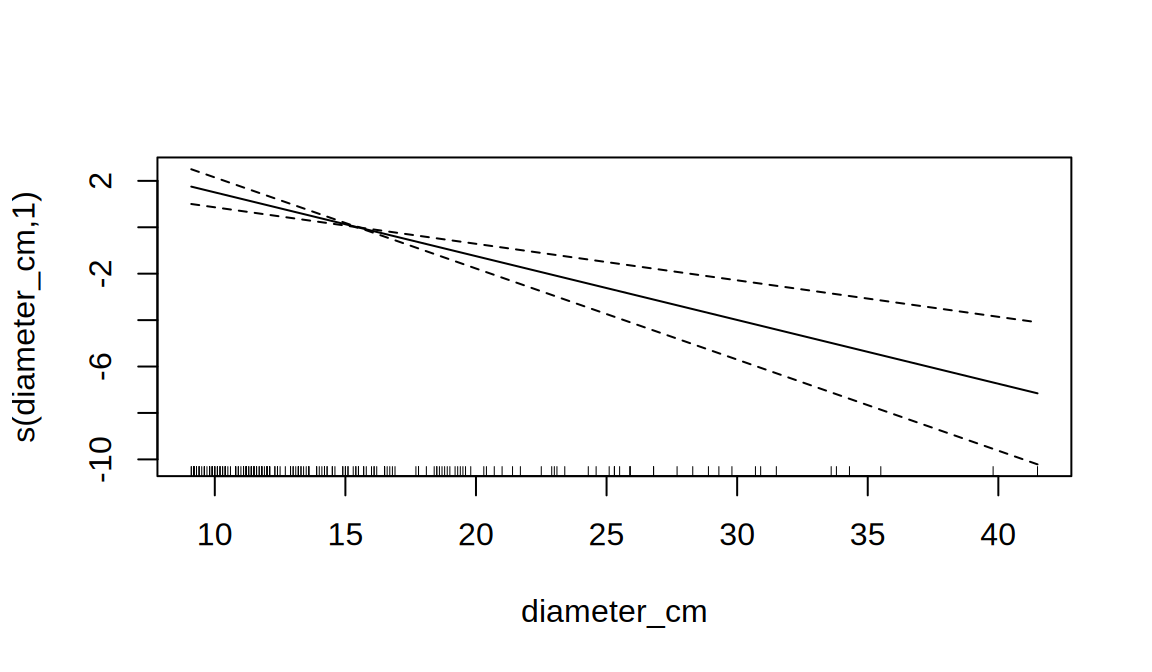
Figure 8.2: Fonction lisse \(\hat f\) du diamètre sur l’échelle logit, centrée, avec bande de confiance à 95 %. Les traits au bas de la figure marquent les diamètres observés.
La fonction lisse du diamètre a exactement un degré de liberté effectif : la pénalisation a ramené \(\hat f\) à une droite, et le GAM se réduit à la régression logistique avec le diamètre comme variable linéaire sur l’échelle logit (même AIC, à \(10^{-4}\) près). La Figure 8.2 le montre sans ambiguïté : une droite décroissante, dont la bande de confiance s’évase là où les gros arbres se font rares. C’est l’usage diagnostique du GAM : lorsqu’on hésite sur la forme fonctionnelle, on laisse les données trancher, et si les degrés de liberté effectifs sont proches de 1, un MLG paramétrique suffit.
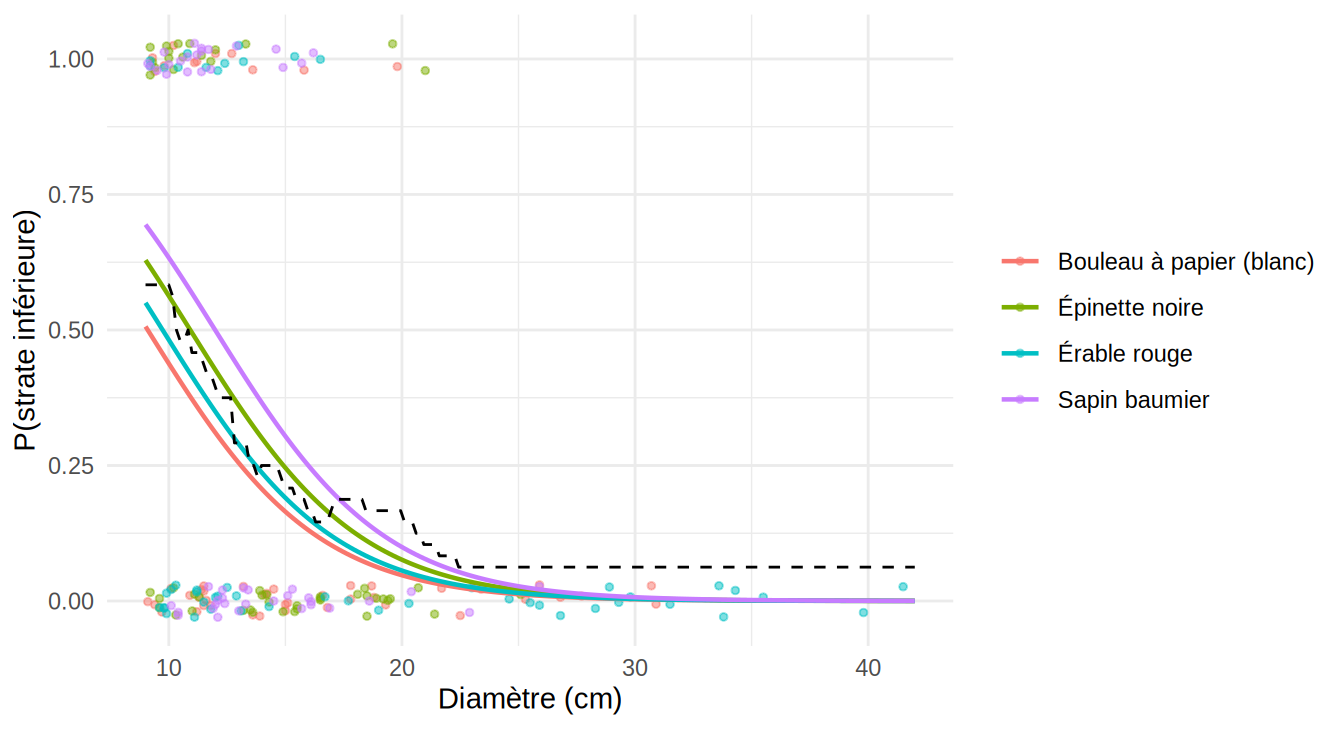
Sur l’échelle des probabilités, le modèle donne une courbe par espèce, toutes de même forme (effet additif sur le logit) et décalées verticalement par les \(\hat\gamma_e\) : à diamètre égal, le sapin baumier est l’espèce la plus souvent sous le couvert et le bouleau la moins souvent, mais aucun de ces écarts n’est significatif. La Figure 8.3 superpose l’estimateur \(k\)NN du Chapitre 6 avec \(k = 48\), la valeur choisie par l’AUC.
Figure 8.3: Probabilité estimée d’être dans la strate inférieure selon le diamètre et l’espèce (GAM logistique), observations (0 ou 1, légèrement décalées verticalement) et estimateur \(k\)NN avec \(k = 48\) (tirets), qui ignore l’espèce.
Les deux approches racontent la même histoire : la probabilité passe d’environ 0,5 à 0,7 (selon l’espèce) pour les plus petits arbres à presque 0 au-delà de 25 cm. Le \(k\)NN, en escalier, plafonne à 0,06 pour les gros diamètres parce que ses 48 voisins incluent alors toujours quelques arbres moyens ; le GAM, lui, prolonge la décroissance. Avec \(n = 200\), l’estimateur non-paramétrique ne contenait pas d’information que la droite sur l’échelle logit ne capte déjà, et le GAM y ajoute l’espèce sans effort.
Contrairement aux splines du Chapitre 7, cet exemple comporte des paramètres qui s’interprètent. La partie paramétrique du modèle, les \(\gamma_e\), se lit exactement comme en régression logistique : \(e^{\hat\gamma_{\text{sapin}}} = e^{0{,}795} \approx 2{,}2\) est le rapport de cotes estimé de la strate inférieure entre un sapin baumier et un bouleau à papier de même diamètre, avec un intervalle de confiance à 95 % d’environ \([0{,}9;\ 5{,}7]\) qui contient 1. C’est le propre des modèles additifs : les effets dont on veut une interprétation restent paramétriques, et seuls ceux dont la forme est incertaine passent par une fonction lisse. Ici, comme \(\hat f\) s’est révélée linéaire, on peut aller plus loin et réajuster le modèle avec glm : la pente du diamètre vaut alors \(-0{,}275\) par cm, soit un rapport de cotes de \(e^{-0{,}275} \approx 0{,}76\) par centimètre de diamètre supplémentaire (IC à 95 % : \([0{,}68;\ 0{,}85]\)), ou encore une division des cotes par environ 4 pour 5 cm de plus. Cette interprétation n’aurait pas été disponible si les degrés de liberté effectifs de \(\hat f\) avaient été nettement supérieurs à 1.
Dans les deux cas, summary rapporte, pour chaque fonction lisse, ses degrés de liberté effectifs et un test approximatif de nullité, et plot trace chaque \(\hat f_j\) avec ses bandes de confiance. Pour un GAM Poisson, la syntaxe est la même avec family = poisson et, au besoin, un terme offset(log(exposition)) dans la formule, comme pour glm.