Les modèles de régression linéaire ne permettent de considérer que les cas où la variable réponse \(Y_i\) est normale. Cependant, dans plusieurs situations, on a une variable réponse discrète qui ne peut prendre qu’un nombre fini (ou dénombrable) de valeurs possibles. Dans ce chapitre, on s’intéresse au cas où \(Y_i\) suit une loi de Bernoulli ou une loi binomiale.
Exemple — Jeu de données : le naufrage de l’Empress of Ireland
Le 29 mai 1914, le paquebot Empress of Ireland a coulé en moins de 15 minutes dans le fleuve Saint-Laurent, près de Rimouski, après une collision avec le charbonnier norvégien Storstad. Sur les 1057 passagers à bord, seulement 217 ont survécu. Les données recensent, pour chaque passager, sa classe de billet (classe : première, deuxième ou troisième), son sexe (sexe) et son groupe d’âge (groupe_age : adulte ou enfant), ainsi qu’un indicateur de survie.
On dispose de ces données sous deux formes, utilisées tout au long du chapitre :
une version empress_individusindividuelle (), avec une ligne par passager (1057 lignes) et une réponse binaire survecu ;
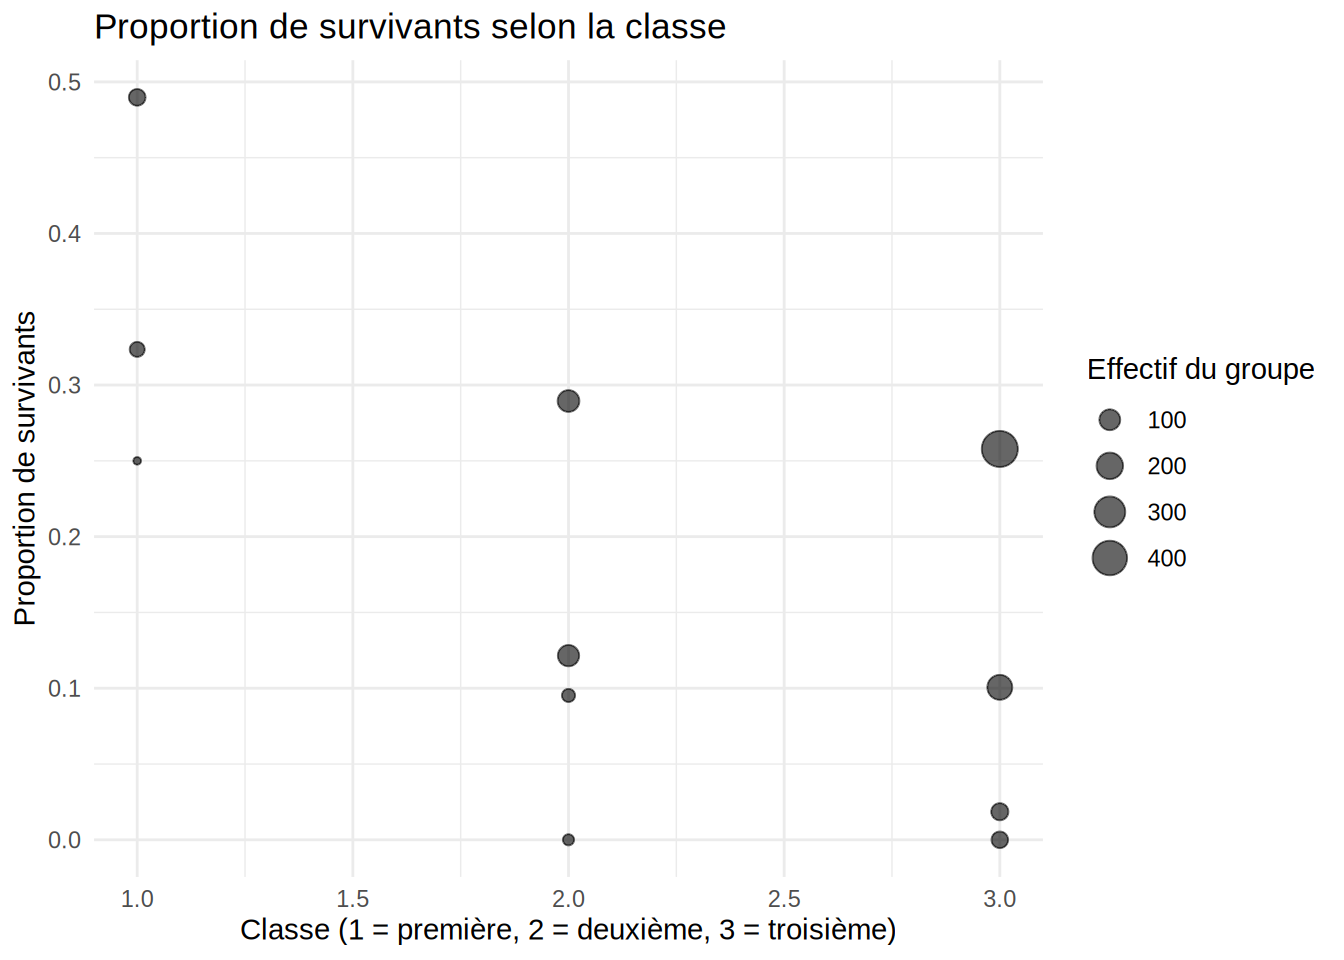
une version empress_agregeagrégée (), avec un effectif total et un nombre de survivants pour chaque combinaison classe-sexe-groupe d’âge (11 lignes), accompagnée d’une variable numérique auxiliaire classe_num (1 = première, 2 = deuxième, 3 = troisième) qui sert de proxy pour l’éloignement du pont supérieur (et donc des canots de sauvetage).
La version individuelle s’obtient en dépliant la version agrégée avec uncount() :
      classe  sexe groupe_age effectif survivants classe_num
1   Première Homme     Adulte       49         24          1
2   Première Femme     Adulte       34         11          1
3   Première Femme     Enfant        4          1          1
4   Deuxième Homme     Adulte      114         33          2
5   Deuxième Homme     Enfant       11          0          2
6   Deuxième Femme     Adulte      107         13          2
7   Deuxième Femme     Enfant       21          2          2
8  Troisième Homme     Adulte      446        115          3
9  Troisième Homme     Enfant       54          1          3
10 Troisième Femme     Adulte      169         17          3
11 Troisième Femme     Enfant       48          0          3
Aucun garçon de première classe n’était à bord : la combinaison (première, homme, enfant) est donc structurellement absente des données.
2.1 Données et modèle
2.1.1 Données individuelles (Bernoulli)
Dans la version individuelle empress_individus, la variable réponse \(Y_i \in \{0,1\}\) (le passager \(i\) a survécu ou non). Les données sont sous la forme \(\{(Y_i,\boldsymbol{X}_i),\, i=1,\ldots,n\}\). On dit que \(Y_i\) suit une loi de Bernoulli de paramètre \(\pi_i \in [0,1]\) :
Définition — Prédicteur linéaire et fonction de lien
On pose \(\eta_i = \beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip}\) (le prédicteur linéaire) et on relie \(\pi_i\) à \(\eta_i\) par une fonction de lien\(g\) supposée connue : \(\eta_i=g(\pi_i)\), c’est-à-dire \[\pi_i = P(Y_i = 1) = g^{-1}(\beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip}).\]
2.1.2 Données groupées (binomiale)
Dans la version agrégée empress_agrege, \(Y_i \in \{0,1,\ldots,m_i\}\), où \(m_i\) est l’effectif (effectif) du \(i\)-ème groupe classe-sexe-groupe d’âge ; \(Y_i\) est le nombre de survivants (survivants) dans ce groupe. On écrit \(Y_i \sim \mathrm{Bin}(m_i,\pi_i)\) :
On pose de nouveau \(\eta_i = g(\pi_i)\), qui peut s’écrire \(\eta_i=g(\mu_i/m_i)\). À noter, on voit souvent \(g(\mu_i)\), par abus de notation. Si \(m_1 = \cdots = m_n = 1\), on retrouve la loi de Bernoulli : celle-ci est un cas particulier de la loi binomiale, et les développements qui suivent couvrent les deux situations.
2.1.3 Fonctions de lien
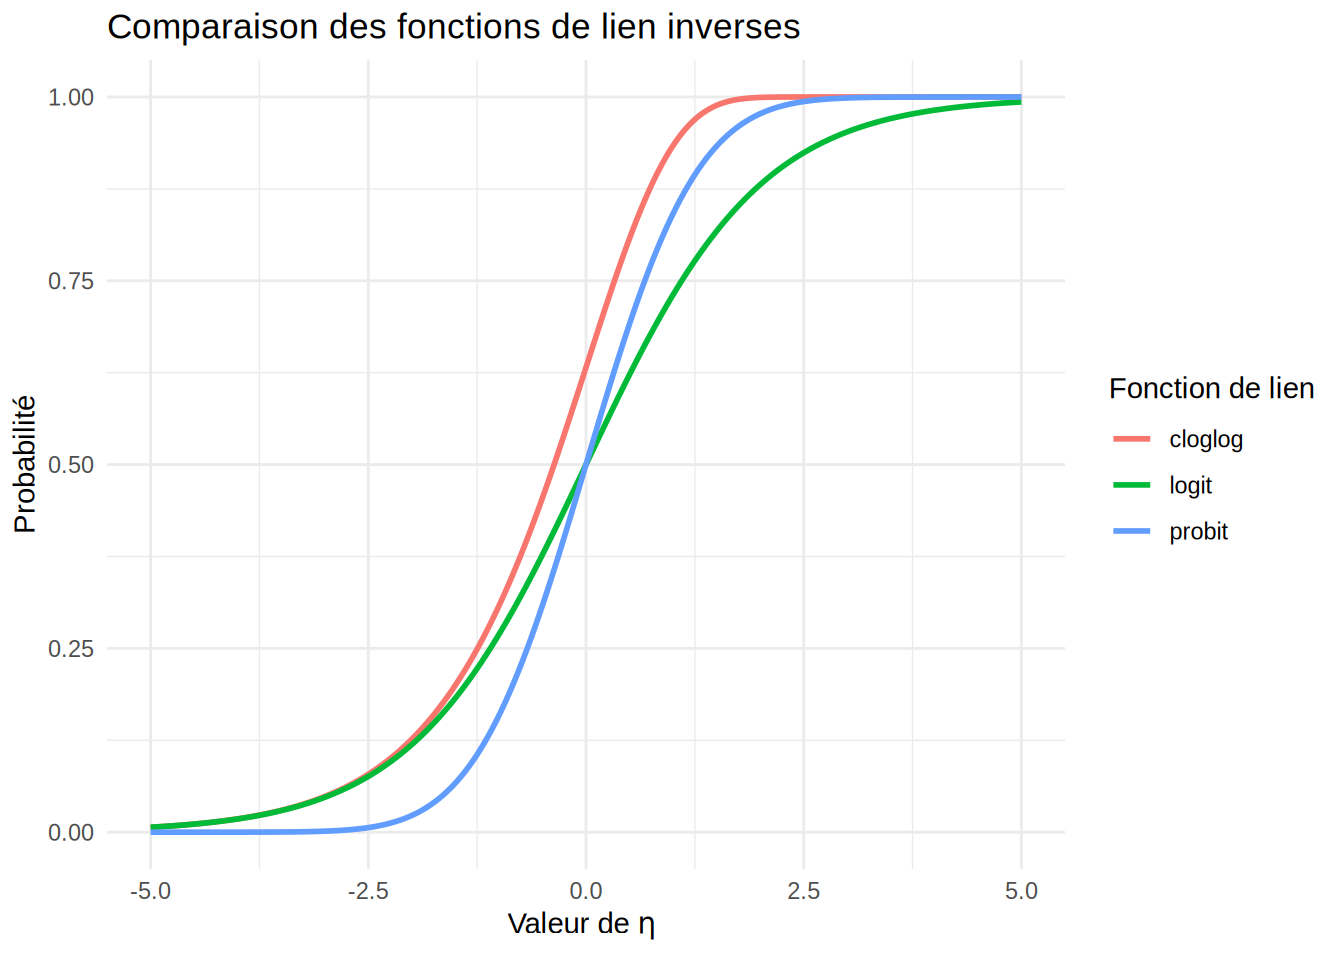
La fonction de lien doit assurer que \(\pi_i = g^{-1}(\eta_i) \in [0,1]\). Trois choix sont courants :
Logit :\(g(u) = \mathrm{logit}(u) = \log\!\left(\dfrac{u}{1-u}\right)\), d’où \(\pi_i = \dfrac{e^{\eta_i}}{1+e^{\eta_i}}\). En R : link="logit" dans glm. Il s’agit du lien le plus utilisé en régression binaire. Ceci est en partie expliqué par son interprétabilité, voir la remarque ci-dessous.
Probit :\(g(u) = \Phi^{-1}(u)\), où \(\Phi\) est la fonction de répartition de la \(\mathcal{N}(0,1)\), d’où \(\pi_i = \Phi(\eta_i)\). En R : link="probit".
C-log-log :\(g(u) = \log\{-\log(1-u)\}\), d’où \(\pi_i = 1 - e^{-e^{\eta_i}}\). En R : link="cloglog".
Propriété — \(g^{-1}\) est une fonction de répartition
Dans les trois cas, \(g^{-1}(\cdot)\) est une fonction de répartition. C’est précisément cette propriété qui garantit que \(\pi_i = g^{-1}(\eta_i) \in [0,1]\), peu importe le lien choisi et peu importe la valeur (réelle, non bornée) de \(\eta_i\).
En pratique, les trois liens donnent souvent des résultats très similaires.
Voici une comparaison des probabilités prédites pour les trois liens, en fonction de \(\eta_i\).
Autrement dit, la cote compare la probabilité que l’événement se produise (\(Y_i=1\)) à la probabilité qu’il ne se produise pas (\(Y_i=0\)). Par exemple :
si \(\pi_i = 0{,}5\), alors \(o_i = 1\) : autant de chances que l’événement arrive ou n’arrive pas ;
si \(\pi_i = 0{,}75\), alors \(o_i = 3\) : l’événement a 3 fois plus de chances de se produire que de ne pas se produire.
Interprétation du coefficient \(\beta_j\). Dans le modèle,
Si on augmente \(X_j\) d’une unité, toutes les autres variables restant constantes, \(\eta_i\) augmente de \(\beta_j\).
Propriété — Effet multiplicatif sur la cote
Comme \(o_i = e^{\eta_i}\), une augmentation d’une unité de \(X_j\) (toutes les autres variables restant constantes) se traduit par une multiplication de la cote :
Une augmentation unitaire de \(X_j\) multiplie donc la cote par \(e^{\beta_j}\) ; \(e^{\beta_j}\) est le rapport de cotes (odds ratio). On distingue trois cas :
si \(e^{\beta_j} > 1\) : augmenter \(X_j\) augmente la cote (et donc \(P(Y_i=1)\)) ;
si \(e^{\beta_j} < 1\) : augmenter \(X_j\) diminue la cote ;
si \(e^{\beta_j} = 1\) (c’est-à-dire \(\beta_j = 0\)) : \(X_j\) n’a pas d’effet sur la cote.
2.2 Inférence statistique
2.2.1 Estimation des paramètres \(\boldsymbol{\beta}\)
Point de départ : la vraisemblance. On observe \(n\) variables \(Y_i \sim \text{Binomiale}(m_i, \pi_i)\). La fonction de log-vraisemblance s’écrit
où \(g^{-1}\) est l’inverse de la fonction de lien (par exemple la fonction logistique si \(g\) est le lien logit).
Reparamétrisation en termes de \(\mu_i\). Il est parfois plus commode de travailler avec \(\mu_i = m_i \pi_i\) (l’espérance de \(Y_i\)) plutôt qu’avec \(\pi_i\) directement. En substituant \(\pi_i = \mu_i/m_i\) dans la log-vraisemblance et en isolant tous les termes qui ne dépendent pas de \(\beta\) (regroupés dans la constante \(K\), qui contient le terme \(\log\binom{m_i}{y_i}\)), on obtient une forme équivalente mais plus simple :
où \(\boldsymbol{\mu} = (\mu_1, \dots, \mu_n)^\top\) et \(K\) ne dépend pas de \(\beta\) (donc n’affecte pas la maximisation). C’est sous cette forme qu’on reconnaîtra, plus loin, que le modèle de régression binomiale appartient à la famille exponentielle. Cette écriture est aussi plus facile à utiliser pour le calcul de la déviance.
Le cas du lien logit — Log-vraisemblance
Avec le lien logit, \(\pi_i = \dfrac{e^{\eta_i}}{1+e^{\eta_i}}\) et \(1-\pi_i = \dfrac{1}{1+e^{\eta_i}}\), où
Le score, noté \(\boldsymbol{U}(\boldsymbol{\beta})\), est le vecteur des dérivées partielles de la log-vraisemblance par rapport à \(\boldsymbol\beta\) :
Estimation. L’estimateur du maximum de vraisemblance \(\hat{\boldsymbol\beta}\) est la solution de l’équation du score \(\boldsymbol U(\boldsymbol\beta) = \boldsymbol 0\), c’est-à-dire la valeur qui maximise \(\ell\). Contrairement à la régression linéaire classique, il n’existe pas de solution analytique (forme fermée) ici, à cause de la non-linéarité introduite par la fonction de lien \(g\). On doit donc résoudre le problème numériquement, typiquement par l’algorithme des moindres carrés pondérés itératifs (IRLS – Iteratively Reweighted Least Squares), qui est une application de la méthode de Newton-Raphson (ou Fisher scoring) à ce problème.
Le cas du lien logit — Estimation
Dérivée par rapport à \(\beta_j\)
On dérive \(\ell(\boldsymbol{\beta}; \boldsymbol{y})\) terme à terme par rapport à \(\beta_j\) (\(j = 0, 1, \dots, p\)), en notant que \(\dfrac{\partial \eta_i}{\partial \beta_j} = X_{ij}\) (avec \(X_{i0} \equiv 1\) pour l’ordonnée à l’origine).
Le terme \(\log\binom{m_i}{y_i}\) ne dépend pas de \(\boldsymbol{\beta}\), sa dérivée est donc nulle. Pour le terme \(y_i \eta_i\) :
En posant \(\boldsymbol{X}\) la matrice de design (\(n \times (p+1)\)), \(\boldsymbol{y} = (y_1, \dots, y_n)^\top\) et \(\boldsymbol{\mu} = (m_1\pi_1, \dots, m_n\pi_n)^\top\), on obtient le score sous forme matricielle :
Définition — Séparation complète et quasi-complète
On dit qu’il y a séparation complète si un hyperplan permet de classer parfaitement les \(Y_i\) à partir des covariables : il existe \(\boldsymbol\beta\) tel que \(\boldsymbol{X}_i^\top\boldsymbol\beta > 0\) chaque fois que \(Y_i=1\) et \(\boldsymbol{X}_i^\top\boldsymbol\beta < 0\) chaque fois que \(Y_i=0\) (ou l’inverse).
On parle de séparation quasi-complète lorsque cette séparation est presque parfaite : il existe un hyperplan qui classe correctement toutes les observations, sauf sur un sous-ensemble où \(\boldsymbol{X}_i^\top\boldsymbol\beta = 0\) exactement.
Remarque — Intuition géométrique : une pente qui explose
Avec un seul prédicteur continu et le lien logit, \(\hat\pi(x) = g^{-1}(\hat\beta_0 + \hat\beta_1 x)\), dont la pente est
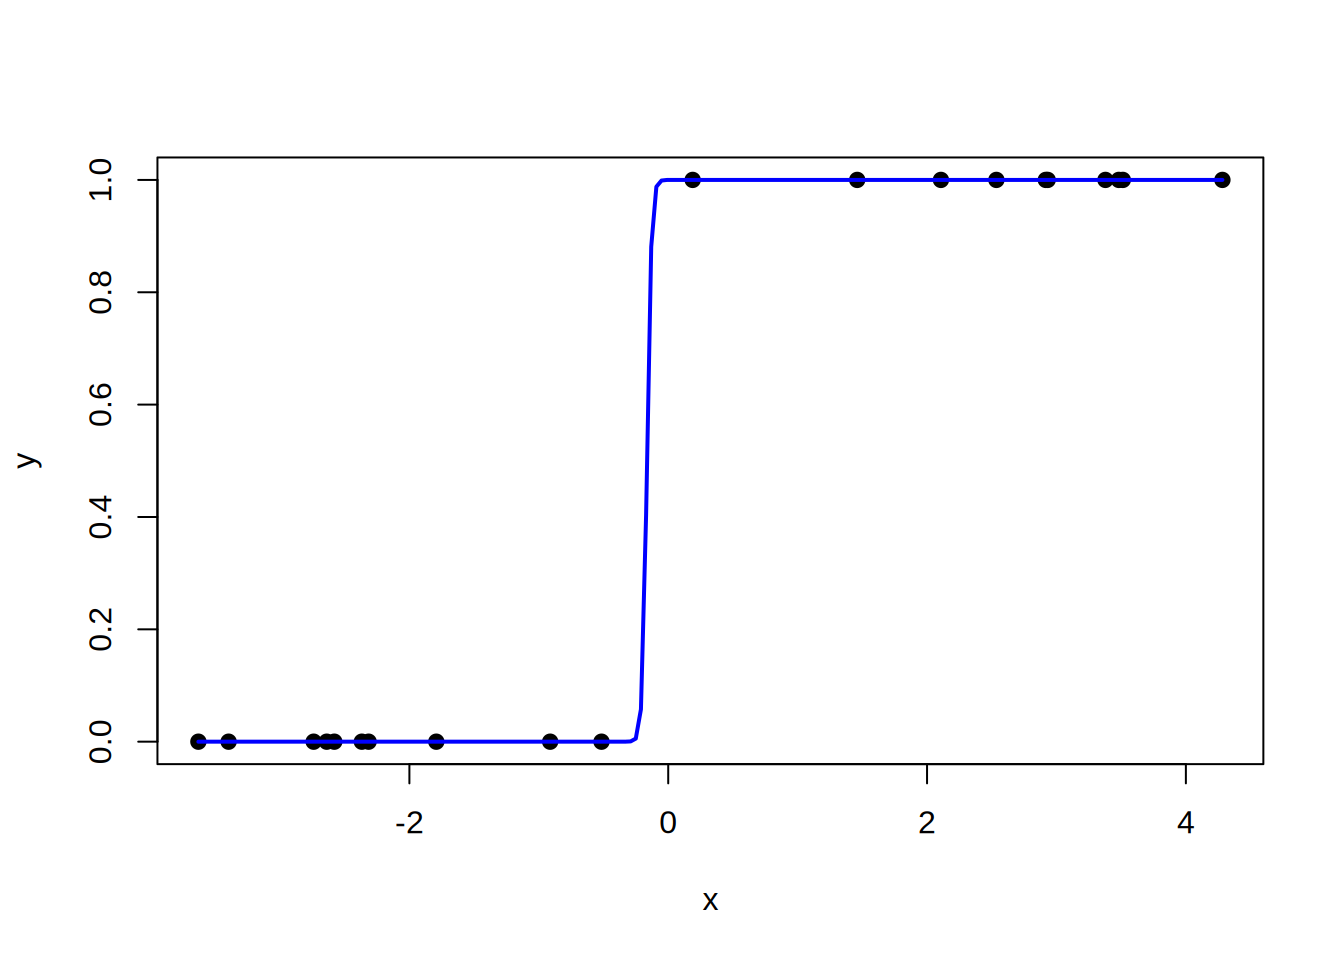
maximale au point d’inflexion (\(\hat\pi(x)=1/2\)), où elle vaut \(\hat\beta_1/4\). Sous séparation, l’algorithme pousse \(|\hat\beta_1| \to \infty\) pour continuer à augmenter la vraisemblance : la pente maximale de la courbe explose elle aussi. Géométriquement, la sigmoïde logistique devient de plus en plus abrupte et se rapproche d’une fonction en escalier (valant 0 d’un côté du seuil de séparation et 1 de l’autre) plutôt que de converger vers une courbe en S bien définie — un saut qu’aucune sigmoïde à pente finie ne peut reproduire exactement, d’où la non-convergence de l’algorithme plutôt qu’une pente littéralement infinie en pratique.
Avec plusieurs covariables, cette image se généralise : l’hyperplan séparateur devient une frontière de décision parfaitement nette (les probabilités prédites tendent vers 0 ou 1 de chaque côté), mais « la pente » n’est plus un scalaire unique — c’est la norme \(\|\hat{\boldsymbol\beta}\|\) dans la direction séparatrice qui diverge.
En présence de séparation (complète ou quasi-complète), l’estimateur du maximum de vraisemblance \(\hat{\boldsymbol\beta}\)n’existe pas au sens usuel : la vraisemblance continue d’augmenter à mesure que \(\|\boldsymbol\beta\| \to \infty\) dans la direction qui sépare les données, sans jamais atteindre de maximum fini. En pratique, l’algorithme IRLS ne converge pas, ou converge vers des \(\hat\beta_j\) extrêmement grands, limités seulement par le critère d’arrêt numérique de l’algorithme.
R signale souvent ce problème par l’avertissement
Warning: glm.fit: fitted probabilities numerically 0 or 1 occurred
accompagné de coefficients estimés très grands en valeur absolue et d’erreurs-types démesurément grandes — souvent des ordres de grandeur plus grandes que le coefficient lui-même.
Exemple — Illustration de la séparation complète
set.seed(2)x <-c(rnorm(10, mean =-2.5), rnorm(10, mean =2.5))y <-c(rep(0, 10), rep(1, 10)) # séparation complète : y=0 si x<0, y=1 si x>0modele_separe <-glm(y ~ x, family = binomial)
Warning: glm.fit: algorithm did not converge
Warning: glm.fit: fitted probabilities numerically 0 or 1 occurred
summary(modele_separe)$coefficients
             Estimate Std. Error      z value  Pr(>|z|)
(Intercept)  9.924497   19989.53 0.0004964849 0.9996039
x           60.320086   50086.41 0.0012043204 0.9990391
grille_x <-data.frame(x =seq(min(x), max(x), length.out =200))grille_x$p_hat <-predict(modele_separe, newdata = grille_x, type ="response")plot(x, y, pch =19, ylim =c(0, 1))lines(grille_x$x, grille_x$p_hat, col ="blue", lwd =2)
La courbe de prédiction \(\hat\pi(x)\) se rapproche d’une fonction en escalier plutôt que d’une sigmoïde classique : elle passe de 0 à 1 sur un intervalle extrêmement court, autour du seuil de séparation (\(x=0\) ici) — reflet direct de la pente \(\hat\beta_1/4\) qui explose sous séparation complète.
Le coefficient de x et son erreur-type explosent tous les deux — signe clair de séparation, pas d’un effet réellement très fort.
Remarque — Que faire en cas de séparation?
Quelques approches courantes :
Régression logistique pénalisée (Firth) : ajoute un terme de pénalité à la vraisemblance (logistf en R), qui garantit l’existence d’un estimateur fini même sous séparation.
Retirer ou regrouper la variable problématique : si une variable catégorielle cause la séparation, fusionner la catégorie en cause avec une catégorie voisine peut régler le problème.
Régularisation (ridge, lasso) : contraint les coefficients et empêche qu’ils divergent vers l’infini.
Recueillir plus de données : si la séparation vient d’un petit échantillon plutôt que d’une relation déterministe réelle, un échantillon plus grand peut la faire disparaître.
Ce phénomène a aussi une conséquence directe sur l’inférence : les tests de Wald deviennent peu fiables en présence de séparation, même partielle — voir le phénomène de Hauck-Donner plus loin.
2.2.3 Information de Fisher et variance des estimateurs
Matrice d’information de Fisher. On calcule ensuite la matrice d’information de Fisher \(I\), dont l’élément \((j,k)\) est
\(\overset{\cdot}{\sim}\)
La notation \(\dot\sim\) signifie que la variable aléatoire suit approximativement la loi indiquée, de façon asymptotique — ici, quand \(n\to\infty\). Cette approximation provient d’un résultat de convergence en distribution, qu’on explicitera à la section sur la déviance.
Dans ce qui suit, \(\hv{\hb}\) sera utilisé à la place de \(\hvar{\hb}\), pour alléger la notation. De plus, on écrit \(\hv{\hbj{j}}=[\hvar{\hb}]_{jj}\) quand on parle de la variance estimée du paramètre \(\beta_j\).
Forme explicite dans le cas binomial. On montre que
\[
\widehat{\text{V}}(\hb) = (X^\top W X)^{-1},
\]
Avec le lien logit, \(\hpi{i} = \dfrac{e^{\heta{i}}}{1+e^{\heta{i}}}\), où \(\heta{i} = \hbj{0} + \hbj{1} X_{i1} + \cdots + \hbj{p} X_{ip}\). L’entrée \(w_i\) se simplifie alors en
Estimate Std. Error z value Pr(>|z|)
(Intercept) -0.5073411 0.24167756 -2.099248 3.579504e-02
classe_num -0.3798464 0.09480604 -4.006563 6.160872e-05
La sortie de summary() nous donne les estimations des écarts-types des estimations sous Std. Error, comme pour la régression linéaire.
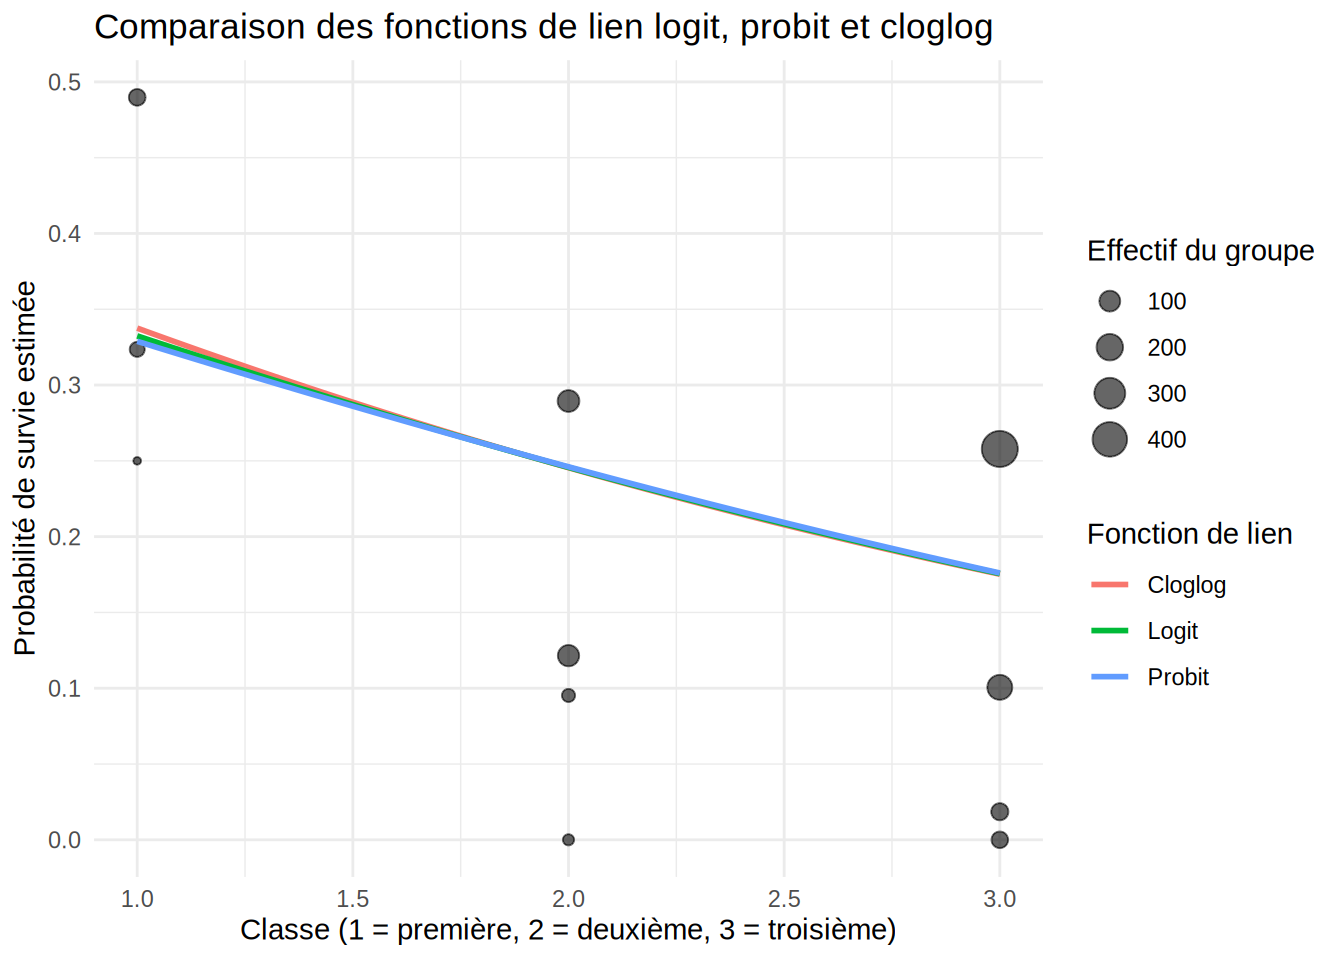
grille <-data.frame(classe_num =seq(min(empress_agrege$classe_num), max(empress_agrege$classe_num), length.out =200))predire_modele <-function(modele, nom_lien) { grille |>mutate(p_hat =predict(modele, newdata = grille, type ="response"),lien = nom_lien )}predictions <-bind_rows(predire_modele(modele_agrege_classe_logit, "Logit"),predire_modele(modele_agrege_classe_probit, "Probit"),predire_modele(modele_agrege_classe_cloglog, "Cloglog"))empress_obs <- empress_agrege |>mutate(prop_observee = survivants / effectif)ggplot() +geom_point(data = empress_obs,aes(x = classe_num, y = prop_observee, size = effectif),color ="black",alpha =0.6 ) +geom_line(data = predictions,aes(x = classe_num, y = p_hat, color = lien),linewidth =1 ) +labs(x ="Classe (1 = première, 2 = deuxième, 3 = troisième)",y ="Probabilité de survie estimée",color ="Fonction de lien",size ="Effectif du groupe",title ="Comparaison des fonctions de lien logit, probit et cloglog" ) +theme_minimal()
Pour les trois liens, la valeur-p associée à classe_num (environ \(1{,}3\times10^{-4}\) pour le logit, \(2{,}1\times10^{-4}\) pour le probit et \(6{,}2\times10^{-5}\) pour le cloglog) est largement inférieure au seuil de 5% : on rejette \(H_0:\beta_1=0\) dans les trois cas, l’effet de la classe est donc significatif quel que soit le lien choisi.
Les trois liens mènent à des coefficients significatifs (plus la classe est élevée, moins la probabilité de survie est grande) et à des courbes prédites \(\hat\pi^*\) très similaires : à classe_num fixé, les probabilités prédites diffèrent de moins de 1 point de pourcentage d’un lien à l’autre.
2.2.4 Intervalles de confiance pour les \(\beta_j\)
Les intervalles de confiance et tests concernant les \(\beta_j\) sont obtenus par la méthode de Wald. Un intervalle de confiance de niveau \((1-\alpha)\) pour \(\beta_j\) est \[\left[\hat\beta_j - z_{\alpha/2}\sqrt{\hat{\text V}(\hat\beta_j)}\,;\ \hat\beta_j + z_{\alpha/2}\sqrt{\hat{\text V}(\hat\beta_j)}\right],\] où \(z_\gamma\) est le quantile de la \(\mathcal{N}(0,1)\) défini par \(P(Z > z_\gamma) = \gamma\).
Pour tester \(H_0: \beta_j = 0\) contre \(H_1: \beta_j\neq 0\), on rejette \(H_0\) au seuil \(\alpha\) si \(|z_{obs}| > z_{\alpha/2}\), avec \(z_{obs} = \hat\beta_j/\sqrt{\hat{\text V}(\hat\beta_j)}\). Le seuil observé (\(p\)-valeur) est \(\alpha^* = 2P(Z > |z_{obs}|)\).
Exemple — Intervalle de confiance pour \(\beta_1\) dans l’exemple empress_agrege
En utilisant le lien logit, on construit un intervalle de confiance de niveau 95% pour \(\beta_1\) (l’effet de classe_num) en utilsant les informations données par la sortie:
summary(modele_agrege_classe_logit)$coefficients
              Estimate Std. Error    z value   Pr(>|z|)
(Intercept) -0.2727075  0.2876705 -0.9479859 0.34313662
classe_num  -0.4245292  0.1110337 -3.8234261 0.00013161
L’intervalle est \([\hat{\beta_1}-1,96\times \sqrt{\hat{\text V}(\hat\beta_1)};\hat{\beta_1}+1,96\times \sqrt{\hat{\text V}(\hat\beta_1)}]=[-0,6422;-0,2069]\).
On peut bien sûr l’extraire à partir de R directement:
On constate que les deux intervalles ne sont pas identiques.
Remarque — Intervalle de Wald ou intervalle par vraisemblance profilée?
En R, confint(modele) appliqué à un objet glm ne calcule pas l’intervalle de Wald ci-dessus, mais un intervalle par vraisemblance profilée (profile likelihood) : plutôt que de supposer une courbure symétrique (parabolique) de la log-vraisemblance autour de \(\hat\beta_j\), cette méthode explore directement sa vraie courbe en faisant varier \(\beta_j\) (en réoptimisant les autres paramètres à chaque valeur), puis inverse le test du rapport de vraisemblance pour trouver les bornes exactes. L’intervalle obtenu n’est généralement pas symétrique autour de \(\hat\beta_j\), contrairement à celui de Wald. Pour obtenir l’intervalle de Wald depuis R, il faut plutôt utiliser confint.default(modele).
Les deux méthodes convergent vers des résultats similaires avec de grands échantillons et des coefficients modérés. L’intervalle par vraisemblance profilée reste toutefois préférable en général, car il ne dépend pas de la courbure locale en \(\hat\beta_j\) — il est donc, comme le test du rapport de vraisemblance, immunisé contre le phénomène de Hauck-Donner décrit ci-dessous, et reste fiable en présence de séparation ou de petits échantillons, situations où l’intervalle de Wald peut devenir trompeur (artificiellement trop large, voire non significatif alors que l’effet est réel). En pratique, l’intervalle de Wald garde son utilité pour l’intuition et les calculs rapides à la main, mais l’intervalle par vraisemblance profilée est préférable pour les résultats rapportés.
Pour aller plus loin avec la théorie — Construction de l’intervalle par vraisemblance profilée
On définit d’abord la log-vraisemblance profilée de \(\beta_j\) : pour chaque valeur fixée de \(\beta_j\), on maximise la log-vraisemblance sur tous les autres paramètres \(\boldsymbol\beta_{-j}\) :
C’est une équation non linéaire en \(\beta_j\) (elle implique elle-même une optimisation à chaque évaluation), donc — sauf cas particuliers — il n’existe pas de solution algébrique explicite : contrairement à l’intervalle de Wald, cet intervalle n’a pas de forme fermée.
Cas particulier avec forme fermée. En régression linéaire classique avec erreurs gaussiennes, la log-vraisemblance est exactement quadratique en \(\boldsymbol\beta\), donc la vraisemblance profilée coïncide exactement avec l’approximation de Wald : les deux méthodes donnent alors le même intervalle. Cette coïncidence disparaît dès qu’on introduit une fonction de lien non linéaire, comme en régression logistique.
Résolution en pratique.confint.glm() (package MASS) calcule \(\ell_p(\beta_j)\) sur une grille de valeurs de \(\beta_j\) autour de \(\hat\beta_j\), en réajustant le modèle (avec les autres paramètres libres) à chaque valeur — d’où le message “Waiting for profiling to be done…”, qui reflète ces refits successifs. Ces points sont ensuite interpolés par une spline pour approximer la fonction inverse, et les bornes sont trouvées par recherche de racine sur cette interpolation plutôt que par résolution directe de l’équation ci-dessus.
Remarque — Le phénomène de Hauck-Donner
Le test de Wald pour \(H_0 : \beta_j = 0\) repose sur la statistique
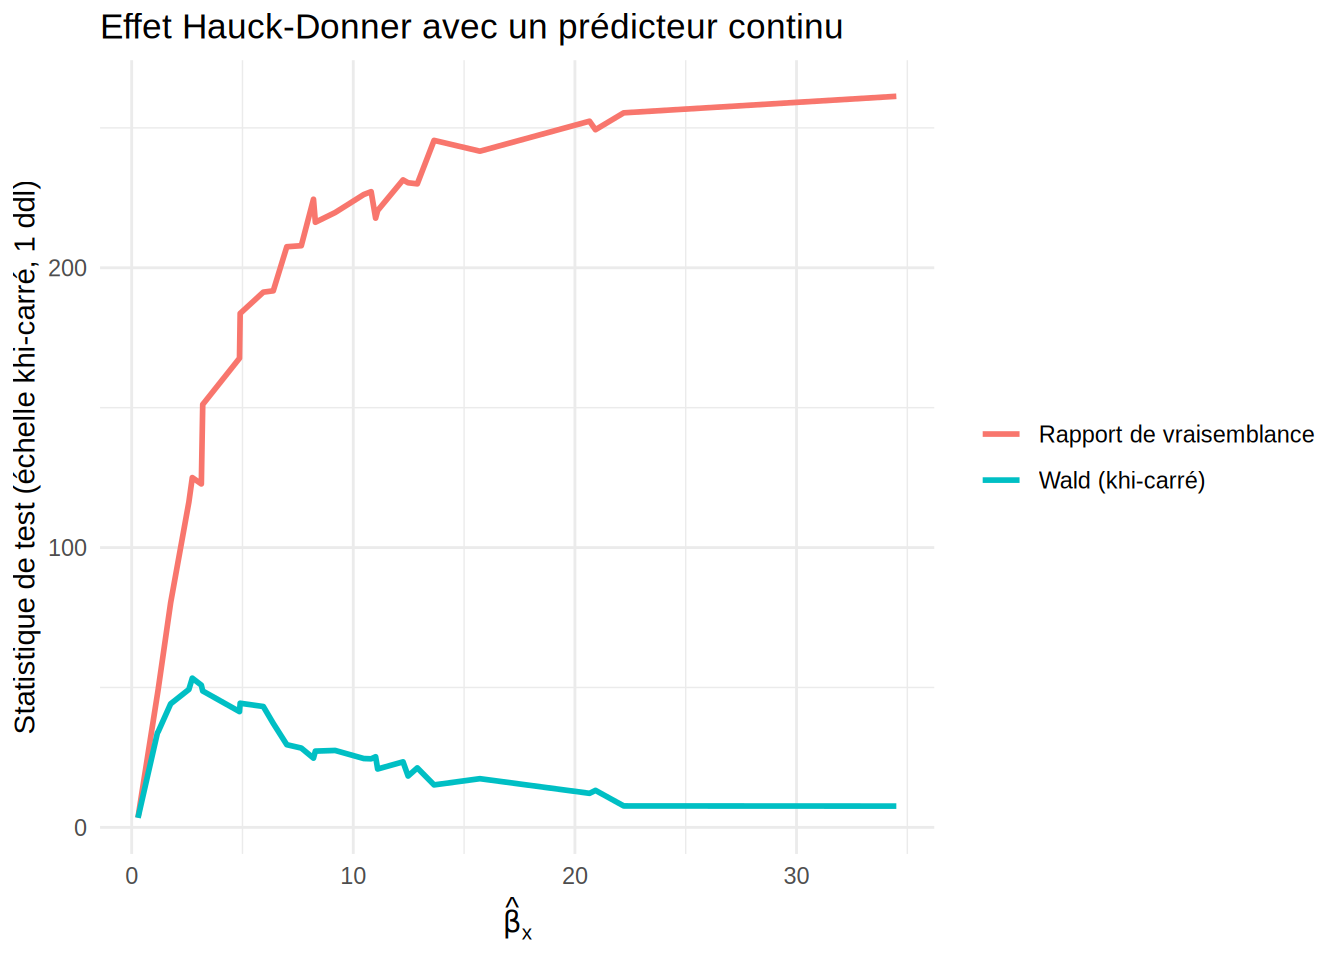
où l’erreur-type est estimée à partir de la courbure de la log-vraisemblance évaluée au point estimé\(\hat\beta_j\), plutôt que sous \(H_0\). Cette dépendance locale peut mener à un comportement contre-intuitif : lorsque \(|\hat\beta_j|\) devient très grand (par exemple en présence de séparation — complète ou quasi-complète — ou d’un effet très fort), la courbure de la vraisemblance en \(\hat\beta_j\) s’aplatit, ce qui gonfle\(\sqrt{\hat{\text V}(\hat\beta_j)}\) et peut faire diminuer\(z_{obs}\) — donnant l’impression que l’effet n’est pas significatif, alors qu’il l’est. On pourrait montrer que cela est causé par le fait que l’erreur-type augmente plus rapidement que la valeur absolue de l’estimation du paramètre.
Ce phénomène, documenté par Hauck et Donner (1977), n’affecte pas le test du rapport de vraisemblance, qui compare directement la vraisemblance en \(\hat\beta_j\) à celle en \(0\) plutôt que de s’appuyer sur une approximation locale :
En pratique : le test «par défaut» de la plupart des fonctions de R utilise le test de Wald, car celui-ci est moins coûteux en calcul et est fiable avec de grands échantillons. Il faut porter une attention particulière aux cas où un coefficient très grand ressort avec une valeur-p de Wald étonnamment élevée. Il faut comparer avec anova(modele_reduit, modele_complet, test = "Chisq") avant de conclure à la non-significativité.
Exemple — Effet Hauck-Donner
On étudie le phénomène par simulation (voir le Chapitre 1) : on génère des données logistiques avec un effet \(\beta_1\) de plus en plus grand et on compare les deux statistiques de test sur chaque jeu de données. La fonction simuler_logistique est réutilisée dans l’exemple suivant.
simuler_logistique <-function(n, beta0 =0, beta1 =1) { x <-rnorm(n, mean =0, sd =1) eta <- beta0 + beta1 * x p <-plogis(eta) # équivalent à 1 / (1 + exp(-eta)) y <-rbinom(n, size =1, prob = p)data.frame(x = x, y = y)}set.seed(123)n <-200valeurs_beta1 <-seq(0.5, 15, by =0.5) # vrai effet croissant -> séparationresultats <-map_dfr(valeurs_beta1, function(b1) { dat <-simuler_logistique(n, beta0 =0, beta1 = b1) mod_complet <-glm(y ~ x, data = dat, family = binomial) mod_reduit <-glm(y ~1, data = dat, family = binomial) beta_hat <-coef(mod_complet)["x"] et_hat <-summary(mod_complet)$coefficients["x", "Std. Error"] wald_chisq <- (beta_hat / et_hat)^2 lr_chisq <-as.numeric(2* (logLik(mod_complet) -logLik(mod_reduit)))data.frame(beta1_vrai = b1,beta_hat = beta_hat,wald_chisq = wald_chisq,lr_chisq = lr_chisq )})resultats |> tidyr::pivot_longer(c(wald_chisq, lr_chisq),names_to ="test",values_to ="statistique" ) |>mutate(test =recode( test,wald_chisq ="Wald (khi-carré)",lr_chisq ="Rapport de vraisemblance" ) ) |>ggplot(aes(x = beta_hat, y = statistique, color = test)) +geom_line(linewidth =1) +labs(x =expression(hat(beta)[x]),y ="Statistique de test (échelle khi-carré, 1 ddl)",color =NULL,title ="Effet Hauck-Donner avec un prédicteur continu" ) +theme_minimal()
2.2.5 Comparaison directe des sorties
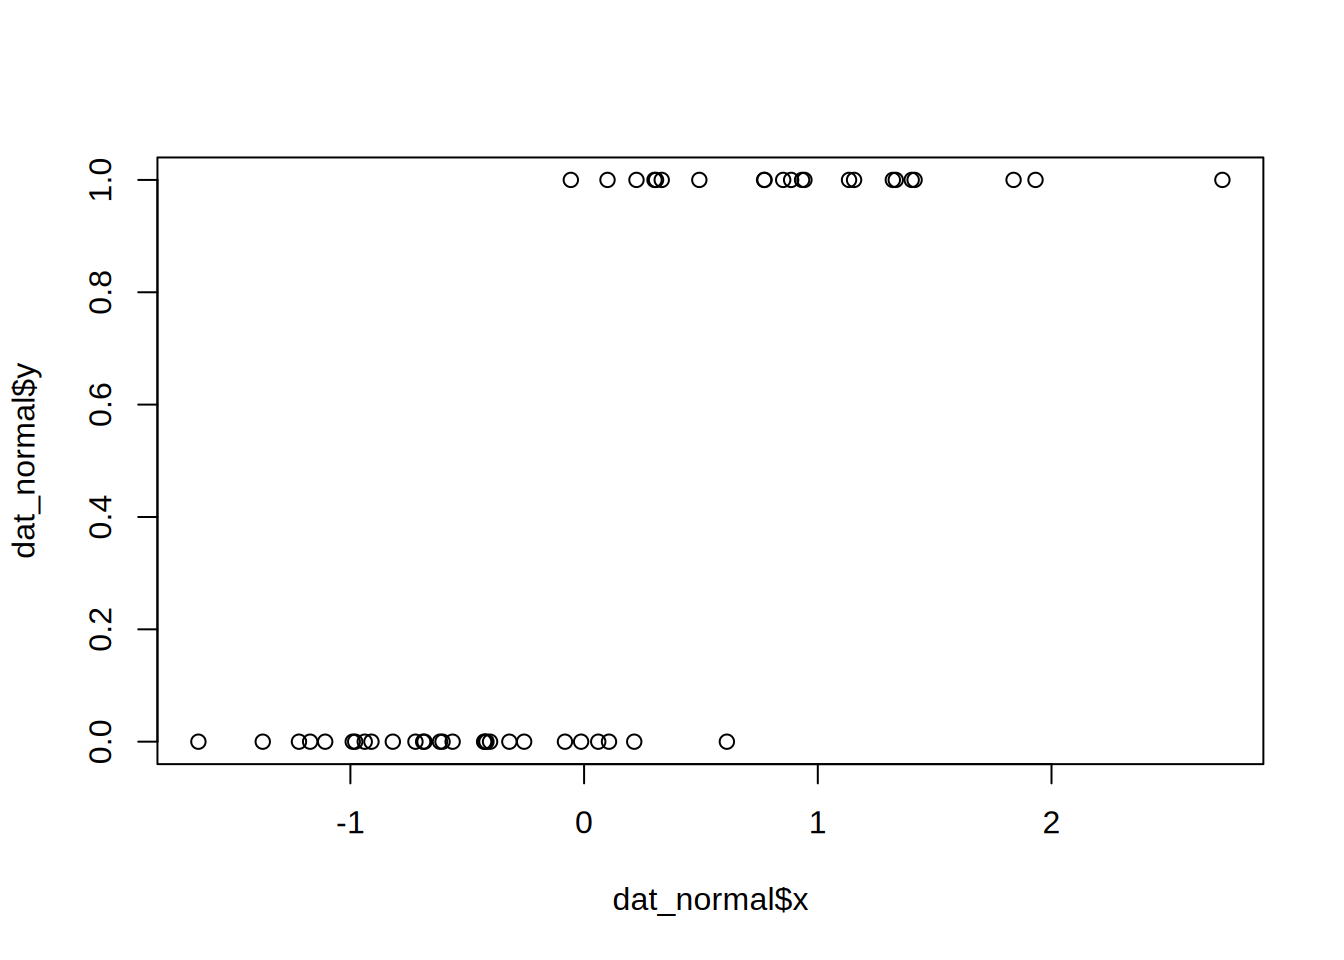
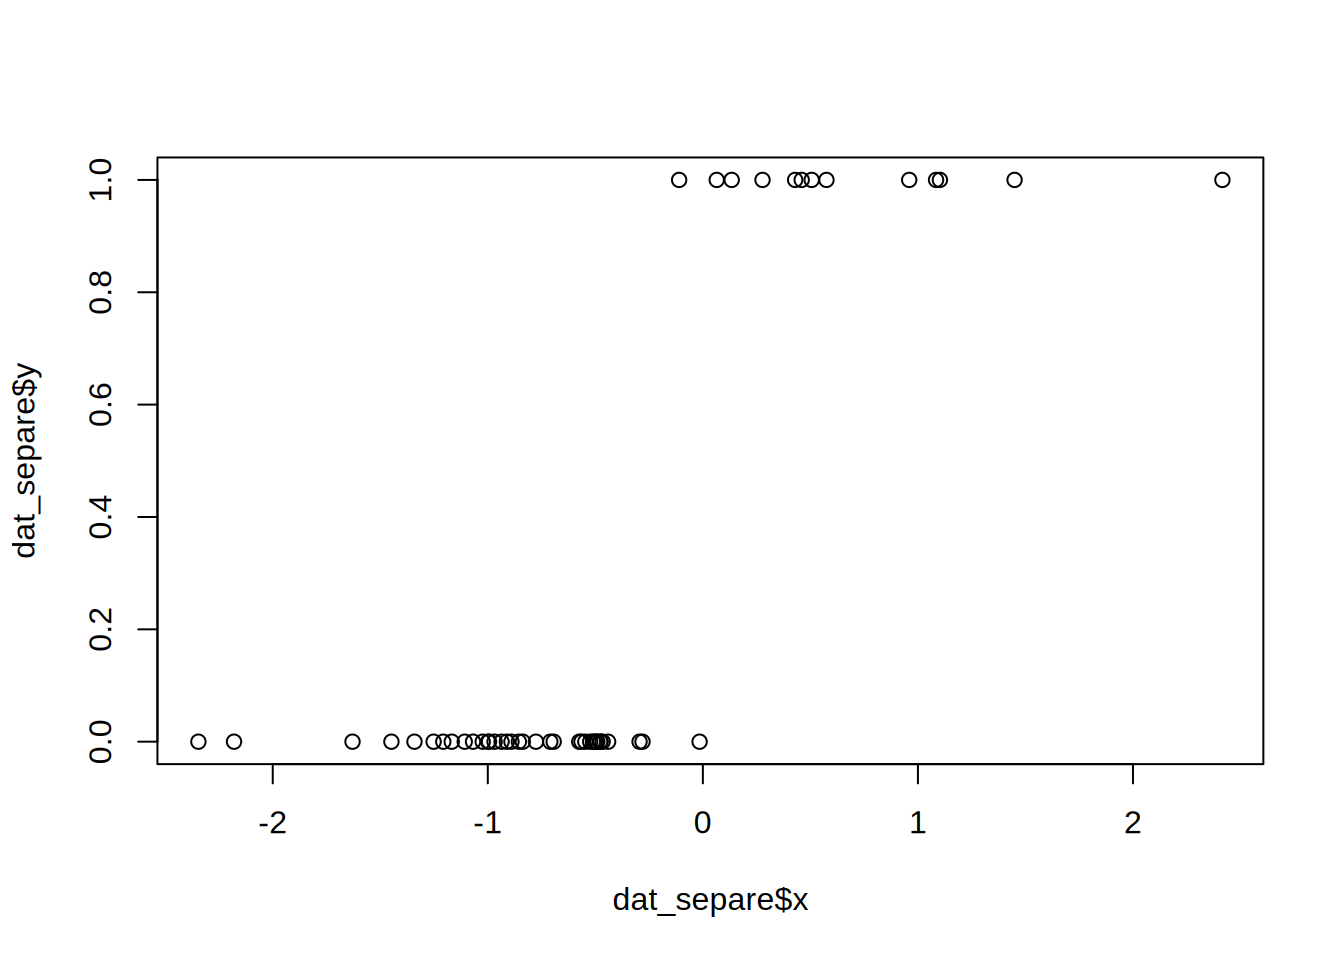
Pour illustrer concrètement l’écart entre les deux tests, comparons un cas “normal” (\(k = 15\), pas de séparation) à un cas de séparation quasi-complète (\(k = 19\), un seul échec sur 20 dans le groupe \(x = 1\)) :
# Cas 1 : k = 15, pas de séparationdat_normal <-simuler_logistique(n =50, beta0 =0, beta1 =5)plot(dat_normal$x, dat_normal$y)
mod_normal <-glm(y ~ x, data = dat_normal, family = binomial)summary(mod_normal)$coefficients
              Estimate Std. Error   z value    Pr(>|z|)
(Intercept) -0.9870555  0.6429306 -1.535244 0.124723837
x            5.7141805  1.9696783  2.901073 0.003718873
# Cas 2 : k = 19, séparation quasi-complèteset.seed(1234)dat_separe <-simuler_logistique(n =50, beta0 =0, beta1 =15)plot(dat_separe$x, dat_separe$y)
mod_separe <-glm(y ~ x, data = dat_separe, family = binomial)summary(mod_separe)$coefficients
             Estimate Std. Error   z value  Pr(>|z|)
(Intercept)  1.028036   1.301805 0.7897003 0.4297028
x           14.144188   7.929599 1.7837205 0.0744691
On constate ici que, dans le cas normal, la valeur-p de x est d’environ \(0{,}0037\) — bien sous le seuil de 5%, donc on rejette \(H_0:\beta_1=0\), comme attendu puisque l’effet simulé est réel. Dans le cas de séparation quasi-complète, la valeur-p de x grimpe à environ \(0{,}074\) — au-dessus du seuil de 5%, donc le test de Wald ne rejette pas \(H_0\), alors même que l’effet simulé y est beaucoup plus fort que dans le cas normal (\(\beta_1=15\) contre \(\beta_1=5\)). C’est exactement le phénomène de Hauck-Donner : le test de Wald devient trompeur sous séparation.
Si on regarde les valeurs-p des tests des rapports de vraisemblance pour les deux cas:
mod_normal_reduit <-glm(y ~1, data = dat_normal, family = binomial)anova(mod_normal_reduit, mod_normal, test ="Chisq")
Analysis of Deviance Table

Model 1: y ~ 1
Model 2: y ~ x
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1        49     68.593
2        48     19.252  1   49.341 2.151e-12 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
mod_separe_reduit <-glm(y ~1, data = dat_separe, family = binomial)anova(mod_separe_reduit, mod_separe, test ="Chisq")
Analysis of Deviance Table

Model 1: y ~ 1
Model 2: y ~ x
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1        49     57.306
2        48      4.990  1   52.316 4.725e-13 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Contrairement au test de Wald, le test du rapport de vraisemblance rejette \(H_0\) dans les deux cas au seuil de 5% : \(p \approx 2{,}15\times10^{-12}\) pour le cas normal et \(p \approx 4{,}73\times10^{-13}\) pour le cas séparé, tous deux très largement inférieurs à \(0{,}05\). Il détecte donc correctement l’effet significatif même sous séparation quasi-complète, là où le test de Wald échouait.
2.2.6 Intervalle de confiance pour une probabilité prédite
Pour \(\boldsymbol{X}^* = (1, X_1^*,\ldots,X_p^*)^\top\), on estime \(\pi^*\) par \(\hat\pi^* = g^{-1}({\boldsymbol{X}^*}^\top\hat\beta)\). Deux approches :
Transformation de l’intervalle sur \(\eta^*\) : un IC pour \({X^*}^\top\beta\) est \[\left[{\boldsymbol{X}^*}^\top\hat\beta \pm z_{\alpha/2}\sqrt{\hat{\text V}({\boldsymbol{X}^*}^\top\hat\beta)}\right], \qquad \hat{\text V}({\boldsymbol{X}^*}^\top\hat\beta) = {\boldsymbol{X}^*}^\top \hat{\text V}(\hat\beta)\, \boldsymbol{X}^*,\] et on applique \(g^{-1}\) aux deux bornes. Cet intervalle respecte toujours \([0,1]\).
Les deux méthodes donnent en pratique des résultats très similaires.
Exemple — IC pour la probabilité de survie en deuxième classe — empress_agrege
On reprend le modèle modele_agrege_classe_logit (classe_num seulement) pour estimer un intervalle de confiance à 95% pour la probabilité de survie d’un passager de deuxième classe, soit \(\boldsymbol{X}^* = (1, 2)^\top\).
X_etoile <-data.frame(classe_num =2)# Prédiction sur l'échelle du prédicteur linéaire, avec erreur-typeeta_etoile <-predict(modele_agrege_classe_logit, newdata = X_etoile, type ="link", se.fit =TRUE)eta_etoile$fit
        1
-1.121766
eta_etoile$se.fit
[1] 0.09448949
z <-qnorm(0.975)# Approche 1 : transformation des bornes sur eta*bornes_eta <- eta_etoile$fit +c(-1, 1) * z * eta_etoile$se.fitic_transform <-plogis(bornes_eta)ic_transform
La probabilité de survie estimée pour un passager de deuxième classe est \(\hat\pi^* \approx 0{,}246\). L’intervalle par transformation est \([0{,}213\,;\,0{,}282]\), celui par la méthode du delta \([0{,}211\,;\,0{,}280]\) : très proches, comme annoncé.
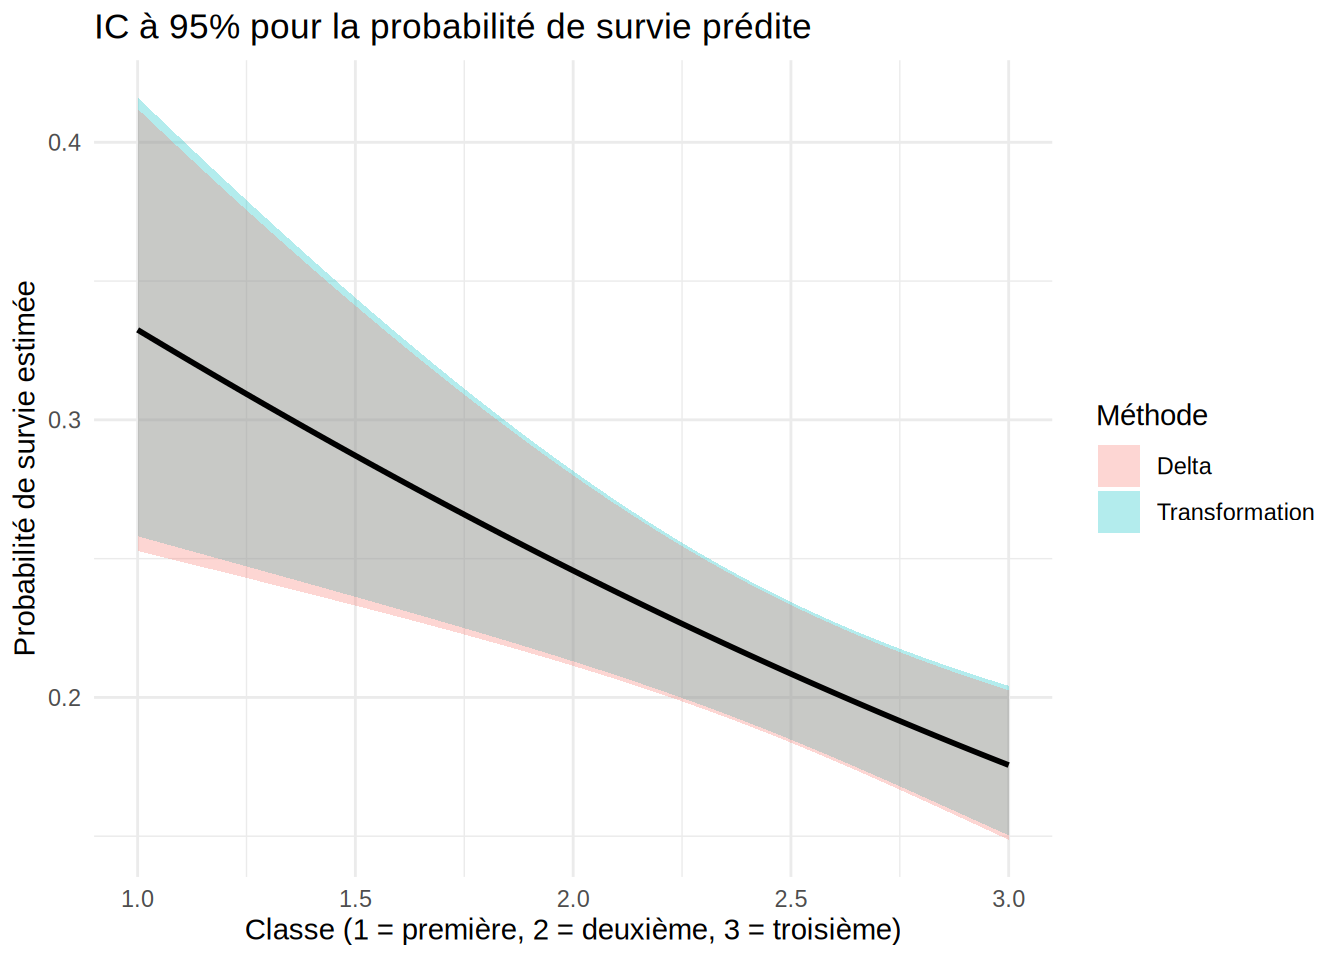
On peut étendre la comparaison à toute la plage de classe_num :
grille <-data.frame(classe_num =seq(1, 3, length.out =200))pred <-predict(modele_agrege_classe_logit, newdata = grille, type ="link", se.fit =TRUE)grille$pi_hat <-plogis(pred$fit)grille$ic_transform_bas <-plogis(pred$fit - z * pred$se.fit)grille$ic_transform_haut <-plogis(pred$fit + z * pred$se.fit)grille$se_pi_delta <-sqrt((grille$pi_hat * (1- grille$pi_hat))^2* pred$se.fit^2)grille$ic_delta_bas <- grille$pi_hat - z * grille$se_pi_deltagrille$ic_delta_haut <- grille$pi_hat + z * grille$se_pi_deltaggplot(grille, aes(x = classe_num)) +geom_ribbon(aes(ymin = ic_transform_bas, ymax = ic_transform_haut, fill ="Transformation"),alpha =0.3) +geom_ribbon(aes(ymin = ic_delta_bas, ymax = ic_delta_haut, fill ="Delta"),alpha =0.3) +geom_line(aes(y = pi_hat), linewidth =1) +labs(x ="Classe (1 = première, 2 = deuxième, 3 = troisième)",y ="Probabilité de survie estimée",fill ="Méthode",title ="IC à 95% pour la probabilité de survie prédite" ) +theme_minimal()
Les deux bandes de confiance sont pratiquement superposées sur toute la plage de classe_num : avec un échantillon de cette taille et un effet modéré, le choix de la méthode importe peu ici. À noter, la borne inférieure de l’IC delta descend jusqu’à environ \(0{,}149\) en troisième classe (classe_num = 3) sans jamais devenir négative dans cet exemple — mais rien ne garantit ce résultat en général : contrairement à l’IC obtenu par transformation, qui reste automatiquement dans \([0,1]\), l’IC delta pourrait déborder de cet intervalle avec d’autres données ou d’autres valeurs de \(\boldsymbol{X}^*\).
Le cas du lien logit — Méthode du delta
Avec le lien logit, \(g^{-1}(u) = \dfrac{e^u}{1+e^u}\), dont la dérivée est
Ainsi, \(h(u) = \left[g^{-1}(u)\{1-g^{-1}(u)\}\right]^2\), et évalué en \(u = {\boldsymbol{X}^*}^\top\hat\beta\), on obtient \(h({\boldsymbol{X}^*}^\top\hat\beta) = \left[\hat\pi^*(1-\hat\pi^*)\right]^2\). La règle du delta donne alors
Pour aller plus loin avec la théorie — Idée de la méthode du delta
On a \(\hat\theta = {\boldsymbol{X}^*}^\top\hat\beta\), dont on connaît la distribution asymptotique : \(\hat\theta \overset{\cdot}{\sim} \mathcal{N}(\theta,\, \hat{\text V}(\hat\theta))\). On s’intéresse cependant à \(\hat\pi^* = g^{-1}(\hat\theta)\), une transformation non linéaire de \(\hat\theta\) — et la normalité asymptotique ne se transporte pas automatiquement à travers une transformation non linéaire, ni sa variance.
La méthode du delta contourne le problème en approximant \(g^{-1}\) localement par sa tangente (développement de Taylor au premier ordre) autour de \(\theta\) : \[
g^{-1}(\hat\theta) \approx g^{-1}(\theta) + \left.\frac{\partial g^{-1}(u)}{\partial u}\right|_{u=\theta} (\hat\theta - \theta).
\] Comme \(g^{-1}(\theta) = \pi^*\) est une constante et que le second terme n’est qu’une transformation linéaire de \(\hat\theta\), on peut maintenant calculer sa variance directement : \[
\text{Var}(\hat\pi^*) \approx \left[\left.\frac{\partial g^{-1}(u)}{\partial u}\right|_{u=\theta}\right]^2 \text{Var}(\hat\theta),
\] qu’on estime en substituant \(\hat\theta\) à \(\theta\) (d’où \(\hat{\text V}(\hat\pi^*) = h({\boldsymbol{X}^*}^\top\hat\beta)\,\hat{\text V}({\boldsymbol{X}^*}^\top\hat\beta)\), où \(h(u) = \{\partial g^{-1}(u)/\partial u\}^2\)).
Contrairement à la première approche (transformer les bornes de l’IC sur \(\eta^*\)), cette méthode approxime directement la variance de \(\hat\pi^*\) sur son échelle naturelle — mais comme elle repose sur une approximation linéaire locale, l’intervalle de confiance qui en résulte n’est pas garanti de rester dans \([0,1]\), contrairement à celui obtenu par transformation.
2.3 Sélection de modèles
2.3.1 Déviance
Pour juger si un modèle avec \(p+1\) paramètres \(\boldsymbol\beta\) s’ajuste bien aux données, il est utile de le comparer au modèle le plus flexible possible : celui qui accorde à chaque observation son propre paramètre, sans aucune structure imposée par des variables explicatives.
Définition — Modèle saturé
On l’appelle le modèle saturé, avec \(n\) paramètres \(\{\tilde\mu_1,\ldots,\tilde\mu_n\}\) (un par observation, plutôt que \(p+1\) pour l’ensemble de l’échantillon).
Il est facile de constater que le modèle saturé maximise la log-vraisemblance, donnée par \[
\ell(\tilde\mu_1,\ldots,\tilde\mu_n; \boldsymbol{y}) = \sum_{i=1}^n \left\{ y_i \log(\tilde\mu_i) + (m_i - y_i)\log(m_i - \tilde\mu_i) \right\} + K,
\]
quand \(\{\tilde\mu_1,\ldots,\tilde\mu_n\}= \{y_1,\ldots,y_n\}\), c’est-à-dire si la log-vraisemblance est calculée en ajustant chaque paramètre exactement sur la donnée observée correspondante. Le modèle saturé représente donc l’ajustement parfait : il reproduit exactement les données, sans laisser aucun résidu. Il n’a cependant aucune valeur prédictive ou explicative, puisqu’il ne fait que mémoriser les observations — son seul rôle est de servir de référence, un étalon auquel comparer un modèle plus parcimonieux (avec \(p+1 \ll n\) paramètres) pour quantifier ce qui reste à expliquer.
La déviance. En notant \(\tilde{\boldsymbol{\mu}}=(\tilde\mu_1,\ldots,\tilde\mu_n)^\top\) et \(\hat{\boldsymbol{\mu}}=(\hat\mu_1,\ldots,\hat\mu_n)^\top\), la statistique du rapport de vraisemblance entre le modèle saturé et le modèle considéré est
\(D\) est la déviance du modèle et \(d_i\) la déviance individuelle de l’observation \(i\) ; chaque \(d_i\) mesure l’écart entre l’ajustement parfait \(y_i\) et l’ajustement \(\hmu{i}\) obtenu par le modèle.
Remarque
Le \(2\) de la formule de la déviance est nécessaire pour avoir
c’est-à-dire que la déviance tend vers la loi du khi-carré à \(n-(p+1)\) degrés de liberté quand les \(m_i\) tendent vers l’infini.
\(\xrightarrow{d}\)
La flèche \(\xrightarrow{d}\) indique une convergence en distribution (ou en loi) : la distribution de la quantité à gauche (ici \(D\)) se rapproche de celle indiquée à droite (ici \(\chi^2_{n-(p+1)}\)) lorsque le paramètre asymptotique tend vers l’infini (ici \(m_i\)), sans que \(D\) elle-même ne converge vers une valeur précise. C’est ce même type de convergence qui justifiait la notation \(\dot\sim\) utilisée plus tôt pour \(\hat\beta\).
Autrement, c’est-à-dire lorsque les \(m_i\) sont finis, on utilise plutôt
\[D \;\overset{\cdot}{\sim}\; \chi_{n-(p+1)}^2\]
comme approximation.
Propriété — Non-négativité de la déviance
Puisque le modèle saturé maximise la vraisemblance parmi tous les modèles possibles, \(l(y,y) \geq l(\hat\mu,y)\) toujours, et donc \(D \geq 0\) : plus \(D\) est petit, plus le modèle considéré se rapproche du modèle saturé, donc plus il s’ajuste bien aux données.
La déviance joue le même rôle que la somme des carrés des résidus en régression linéaire : elle sert à évaluer l’adéquation du modèle et à comparer des modèles.
2.3.2 Comparaison de modèles emboîtés
Pour comparer deux modèles emboîtés de déviances \(D_1\) (complet) et \(D_2\) (réduit), la statistique de test est \(\chi^2 = D_2 - D_1\).
Propriété — Distribution asymptotique de \(\chi^2 = D_2-D_1\)
Sous \(H_0\) (le modèle réduit est adéquat), \(\chi^2\) suit une loi du khi-deux à \(d\) degrés de liberté, où \(d\) est la différence du nombre de paramètres.
Exemple — Ajout du sexe et du groupe d’âge dans l’exemple empress_agrege
On teste \(H_0: \beta_{\text{sexe}} = \beta_{\text{groupe\_age}} = 0\) (modèle avec classe_num seulement contre modèle avec sexe et groupe_age en plus) :
On rejette clairement \(H_0\), puisque \(p \approx 3\times 10^{-16}\) est largement inférieur au seuil de 5% : le sexe et le groupe d’âge ajoutent une information importante que la classe seule ne capture pas. On verra plus loin, en examinant les coefficients du modèle complet, que l’effet du sexe va dans le sens contraire de l’idée reçue « les femmes et les enfants d’abord » — cohérent avec le fait que le navire a coulé en moins de 15 minutes, laissant peu de place à une évacuation ordonnée.
2.3.3 Comparaison de modèles non emboîtés : AIC et BIC
Comme pour les modèles linéaires, on utilise \[AIC = -2\,l(\hat\mu;y) + 2(p+1), \qquad BIC = -2\,l(\hat\mu;y) + \log(n)(p+1).\] Le modèle ayant le plus petit \(AIC\) (ou \(BIC\)) est préférable. En R : AIC(modele) et AIC(modele, k=log(n)).
Exemple — Modèles non emboîtés avec empress_individus
modele_indiv_classe_sexe <-glm(survecu ~ classe + sexe, data = empress_individus, family = binomial)modele_indiv_classe_age <-glm(survecu ~ classe + groupe_age, data = empress_individus, family = binomial)AIC(modele_indiv_classe_sexe)
[1] 1022.129
AIC(modele_indiv_classe_age)
[1] 1021.349
Le modèle 2 (classe + groupe_age) a un AIC légèrement plus faible que le modèle 1 (classe + sexe) et lui est donc préférable — mais l’écart est mince (moins d’un point), signe qu’aucun des deux modèles n’est pleinement satisfaisant : chacun omet une variable importante, comme le confirme la sélection automatique ci-dessous.
2.3.4 Sélection automatique
Les méthodes pas à pas forward, backward et stepwise fonctionnent exactement comme pour les modèles linéaires (fonction step avec l’argument direction).
Exemple — Sélection automatique sur le jeu de données empress_individus
# Modèle complet : effets additifs des trois variables explicatives disponiblesmodele_indiv_complet <-glm(survecu ~ classe + sexe + groupe_age,data = empress_individus, family = binomial)# Backward : part du modèle complet, retire des termesmodele_indiv_backward <-step(modele_indiv_complet, direction ="backward")
# Forward : part du modèle vide, ajoute des termes jusqu'au modèle completmodele_indiv_vide <-glm(survecu ~1, data = empress_individus, family = binomial)modele_indiv_forward <-step(modele_indiv_vide, direction ="forward",scope =formula(modele_indiv_complet))
Call:
glm(formula = survecu ~ classe + sexe + groupe_age, family = binomial,
    data = empress_individus)

Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)       -1.8870     0.2085  -9.052  < 2e-16 ***
classePremière     1.0070     0.2808   3.586 0.000336 ***
classeTroisième   -0.2009     0.1955  -1.028 0.304121
sexeHomme          0.9891     0.1919   5.153 2.56e-07 ***
groupe_ageEnfant  -2.0826     0.5161  -4.035 5.45e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 1073.19  on 1056  degrees of freedom
Residual deviance:  983.66  on 1052  degrees of freedom
AIC: 993.66

Number of Fisher Scoring iterations: 6
summary(modele_indiv_forward)
Call:
glm(formula = survecu ~ groupe_age + sexe + classe, family = binomial,
    data = empress_individus)

Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)       -1.8870     0.2085  -9.052  < 2e-16 ***
groupe_ageEnfant  -2.0826     0.5161  -4.035 5.45e-05 ***
sexeHomme          0.9891     0.1919   5.153 2.56e-07 ***
classePremière     1.0070     0.2808   3.586 0.000336 ***
classeTroisième   -0.2009     0.1955  -1.028 0.304121
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 1073.19  on 1056  degrees of freedom
Residual deviance:  983.66  on 1052  degrees of freedom
AIC: 993.66

Number of Fisher Scoring iterations: 6
summary(modele_indiv_final)
Call:
glm(formula = survecu ~ classe + sexe + groupe_age, family = binomial,
    data = empress_individus)

Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)       -1.8870     0.2085  -9.052  < 2e-16 ***
classePremière     1.0070     0.2808   3.586 0.000336 ***
classeTroisième   -0.2009     0.1955  -1.028 0.304121
sexeHomme          0.9891     0.1919   5.153 2.56e-07 ***
groupe_ageEnfant  -2.0826     0.5161  -4.035 5.45e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 1073.19  on 1056  degrees of freedom
Residual deviance:  983.66  on 1052  degrees of freedom
AIC: 993.66

Number of Fisher Scoring iterations: 6
Dans cet exemple, les trois méthodes convergent vers le même modèle final (classe + sexe + groupe_age), ce qui n’est pas toujours le cas : comme chacune n’explore qu’un chemin restreint parmi tous les sous-modèles possibles (ajoutant ou retirant une variable à la fois), rien ne garantit qu’elles aboutissent au même optimum local (et encore moins à l’optimum global). Ici, les trois variables sont conservées : aucune ne peut être retirée sans détériorer significativement l’ajustement.
Notons toutefois que tous les coefficients du modèle final ne sont pas individuellement significatifs au seuil de 5% : classeTroisième a une valeur-p d’environ \(0{,}30\), largement au-dessus de \(0,05\) — on ne rejette donc pas \(H_0:\beta_{\text{classeTroisième}}=0\) — alors que classePremière (\(p\approx 0{,}0003\)), sexeHomme (\(p\approx 2{,}6\times10^{-7}\)) et groupe_ageEnfant (\(p\approx 5{,}4\times10^{-5}\)) le sont largement. La variable classe reste néanmoins dans le modèle : c’est sa contribution globale (via le test emboîté, comparant tous ses niveaux à la fois) qui détermine si on la retire, pas la significativité d’un seul de ses coefficients.
2.4 Validation et diagnostic de modèles
2.4.1 Résidus
Définition — Résidus de déviance et résidus de Pearson
Résidus de déviance : \(r_{D,i} = \mathrm{signe}(y_i - \hmu{i})\sqrt{d_i}\), avec \(d_i\) la déviance individuelle de l’observation \(i\).
Deux statistiques permettent de tester l’adéquation globale : la déviance\(D\) et la statistique du khi-deux de Pearson \[\chi^2_P = \sum_{i=1}^n r_{P,i}^2 = \sum_{i=1}^n \frac{m_i(y_i - \hmu{i})^2}{\hmu{i}(m_i - \hmu{i})}.\]
Propriété — Convergence de \(D\) et \(\chi^2_P\)
Lorsque tous les \(m_i \to \infty\), \(D\) et \(\chi^2_P\) convergent en loi vers une \(\chi^2_{n-(p+1)}\) si le modèle est bien spécifié.
L’hypothèse nulle du test est que le modèle est adéquat.
Exemple — Test d’adéquation avec l’exemple empress_agrege
On reprend ici le modèle modele_agrege_classe_logit ajusté plus haut, avec classe_num comme seule variable explicative :
# DévianceD <-deviance(modele_agrege_classe_logit)ddl <-df.residual(modele_agrege_classe_logit)p.deviance <-1-pchisq(D, df = ddl)# Khi-deux de Pearsonchi2.pearson <-sum(residuals(modele_agrege_classe_logit, type ="pearson")^2)p.pearson <-1-pchisq(chi2.pearson, df = ddl)data.frame(Statistique =c("Déviance", "Khi-deux de Pearson"),Valeur =c(D, chi2.pearson),ddl = ddl,p.valeur =c(p.deviance, p.pearson))
Les deux valeurs-p (\(p \approx 1{,}68\times10^{-14}\) pour la déviance et \(p \approx 2{,}78\times10^{-11}\) pour le khi-deux de Pearson) sont largement inférieures au seuil de 5%, donc on rejette l’adéquation du modèle : la classe seule ne suffit pas à expliquer la survie. C’est cohérent avec le test emboîté vu plus haut, qui montrait que le sexe et le groupe d’âge ajoutent une information essentielle.
Remarque — Déviance ou Khi-carré de Pearson?
Bien que \(D\) et \(\chi^2_P\) convergent tous deux vers une loi \(\chi^2_{n-(p+1)}\) quand les \(m_i \to \infty\), leur comportement en échantillon fini diffère : la statistique de Pearson respecte généralement mieux cette approximation que la déviance, surtout quand les \(m_i\) sont petits ou modérés (McCullagh et Nelder 1989; Agresti 2013).
Le cas extrême illustre bien ce phénomène : ils sont inutilisables pour des données individuelles (Bernoulli, \(m_i=1\)). En effet, dans ce cas, un des deux termes de \(d_i\) s’annule toujours (par la convention \(0\log 0=0\)), de sorte que
De plus, la log-vraisemblance du modèle saturé vaut alors exactement 0, puisque \(\tilde\mu_i = y_i \in \{0,1\}\) annule \(y_i\log(y_i)+(1-y_i)\log(1-y_i)\) par la même convention. La déviance se réduit donc à
\[
D = \sum_{i=1}^n d_i = -2\,\ell(\hat{\boldsymbol\mu};\boldsymbol y),
\]
c’est-à-dire une simple transformation de la vraisemblance du modèle, sans point de comparaison utile — d’où la perte de son interprétation comme test d’adéquation. \(\chi^2_P\), lui, reste au moins défini dans ce cas, même si son approximation \(\chi^2\) n’est pas fiable non plus.
Quand les deux statistiques mènent à des conclusions similaires (avec des \(m_i\) raisonnablement grands), peu importe laquelle on rapporte. Un désaccord marqué entre les deux valeurs-\(p\) signale plutôt que l’approximation asymptotique commune aux deux tests devient peu fiable, plutôt que l’un des deux tests serait le bon et l’autre non.
Cette distinction ne s’applique toutefois qu’au test d’adéquation globale d’un seul modèle. Pour comparer des modèles emboîtés, la déviance conserve un avantage clair : les différences de déviances suivent exactement une loi \(\chi^2\), ce qui n’est pas le cas des différences de statistiques de Pearson.
2.4.3 Graphiques et extra-variabilité
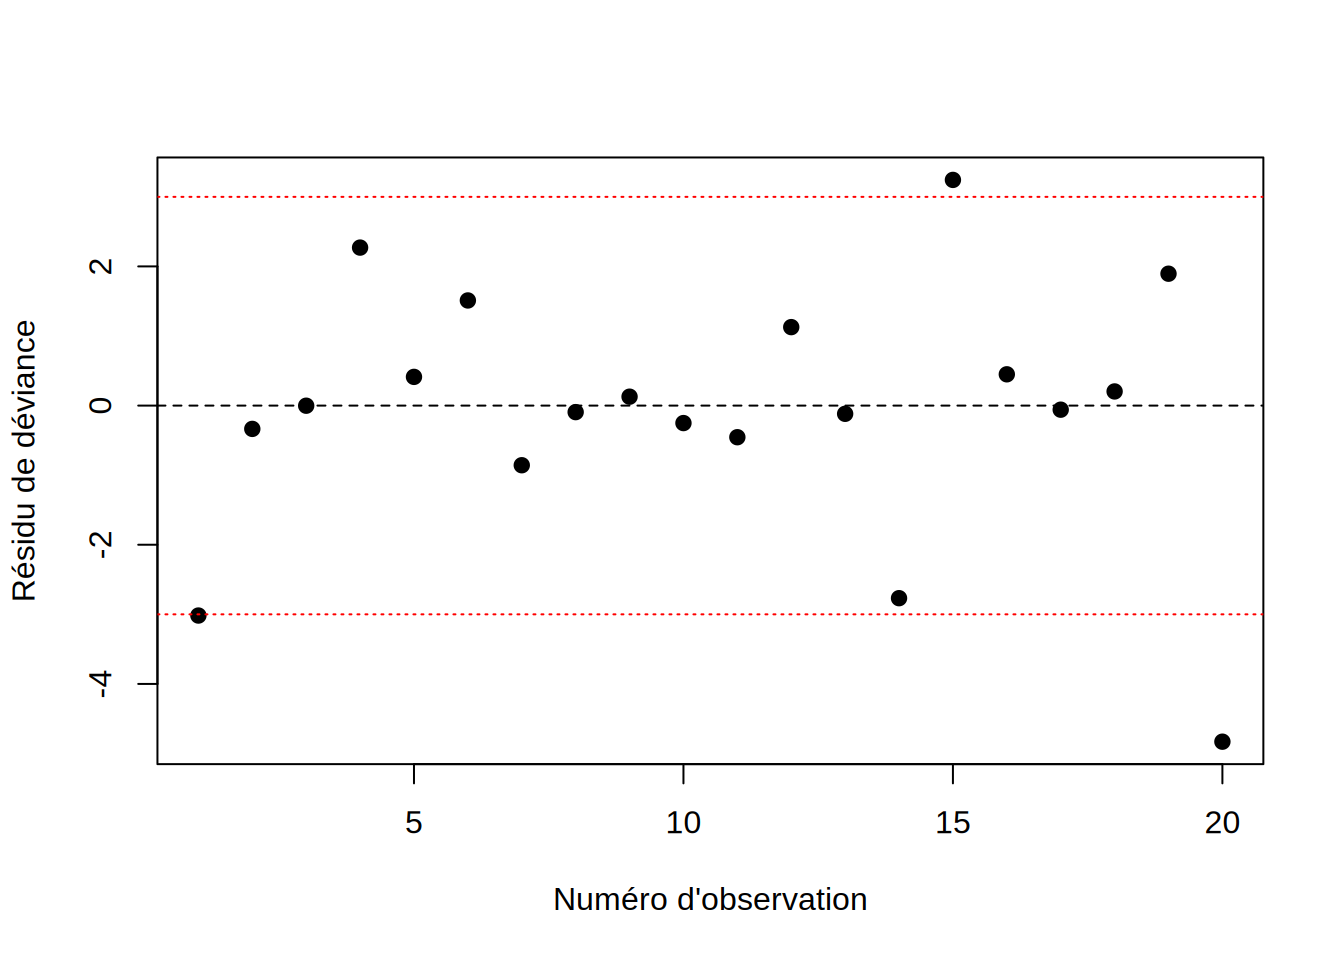
Les graphiques des résidus en fonction des numéros d’observations ne doivent montrer aucune tendance. Si plusieurs résidus de dépassent 3 en valeur absolue, cela peut suggérer une extra-variabilité.
Définition — Extra-variabilité (overdispersion)
L’extra-variabilité (overdispersion) survient quand \(E[Y_i] = m_i\pi_i\) mais \(Var[Y_i] > m_i\pi_i(1-\pi_i)\). On pose alors \(Var[Y_i] = \phi\, m_i\pi_i(1-\pi_i)\) et on estime \(\phi\) par \(\chi^2_P/(n-(p+1))\).
En cas d’extra-variabilité, on spécifie family=quasibinomial() au lieu de family=binomial() dans glm.
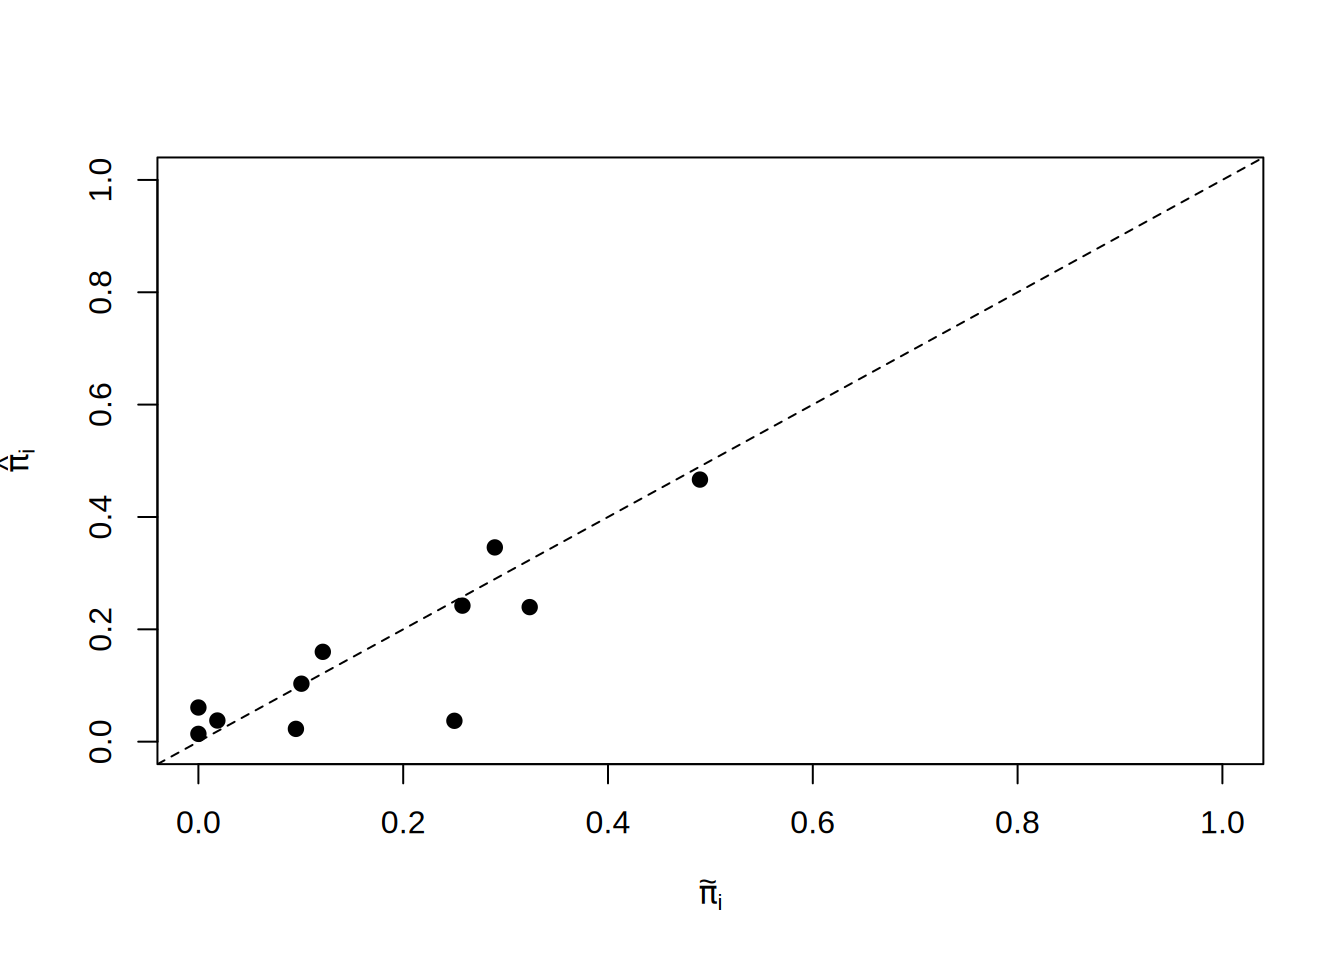
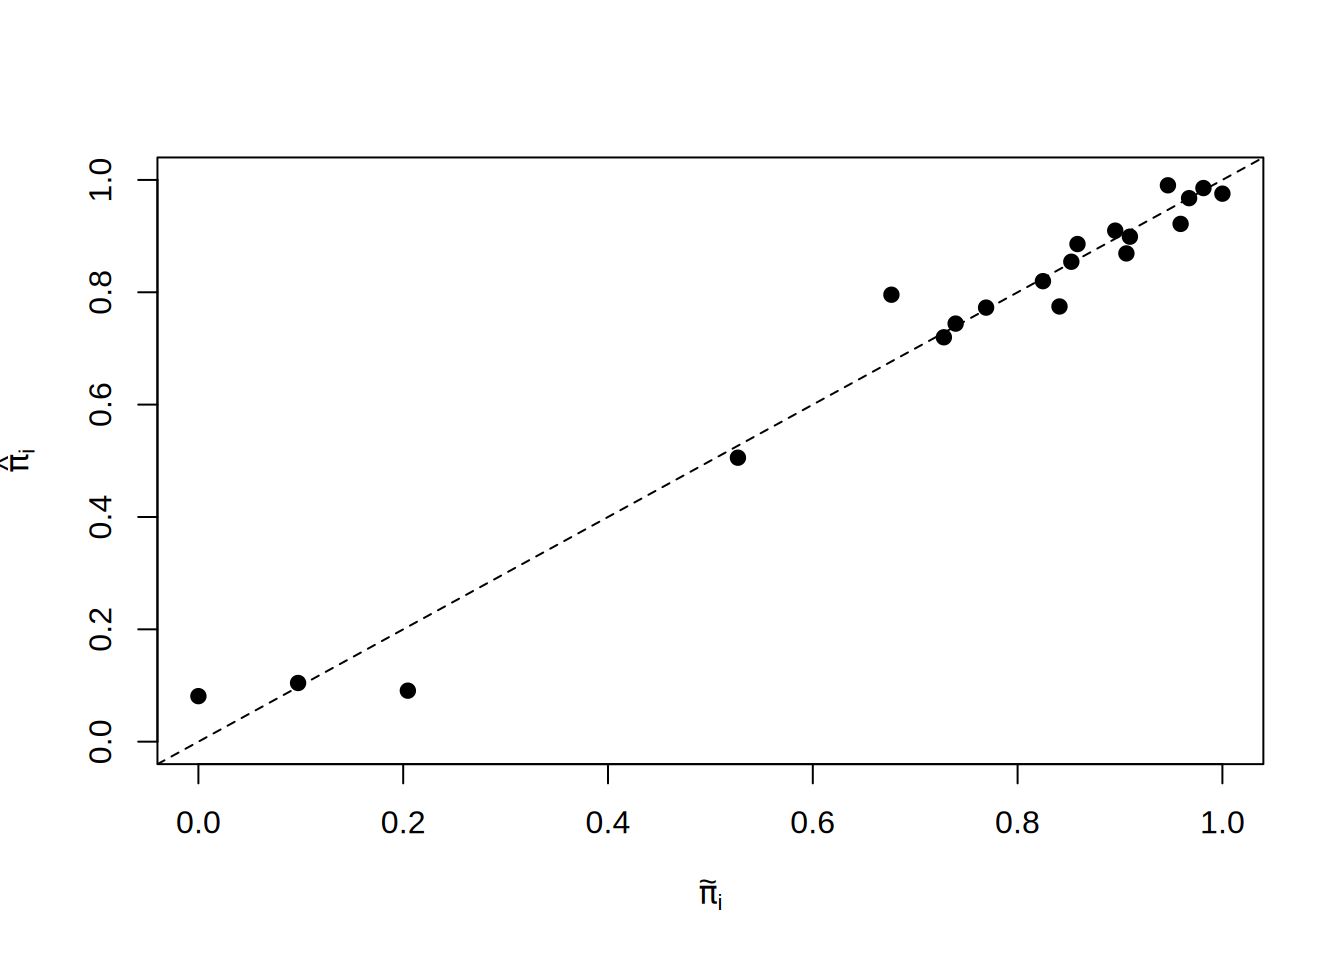
Pour vérifier la linéarité du prédicteur, on trace le nuage de points \(\{(\hpi{i}, \tilde\pi_i)\}\), où \(\hpi{i} = g^{-1}(\heta{i})\) et \(\tilde\pi_i = y_i/m_i\) : si le modèle est bien spécifié, les points doivent être autour de la droite \(y=x\).
2.4.4 Observations aberrantes et valeurs influentes
Le principe est identique à la régression linéaire. Les définitions des leviers, résidus standardisés et studentisés diffèrent, mais ces quantités ont la même interprétation. Il en va de même pour la distance de Cook, les DFBETAS et les DFFITS.
Exemple — Diagnostics de surdispersion — données empress_agrege
On reprend le modèle modele_agrege_complet ajusté plus haut (classe_num + sexe + groupe_age) sur les données agrégées.
Résidus en fonction du numéro d’observation
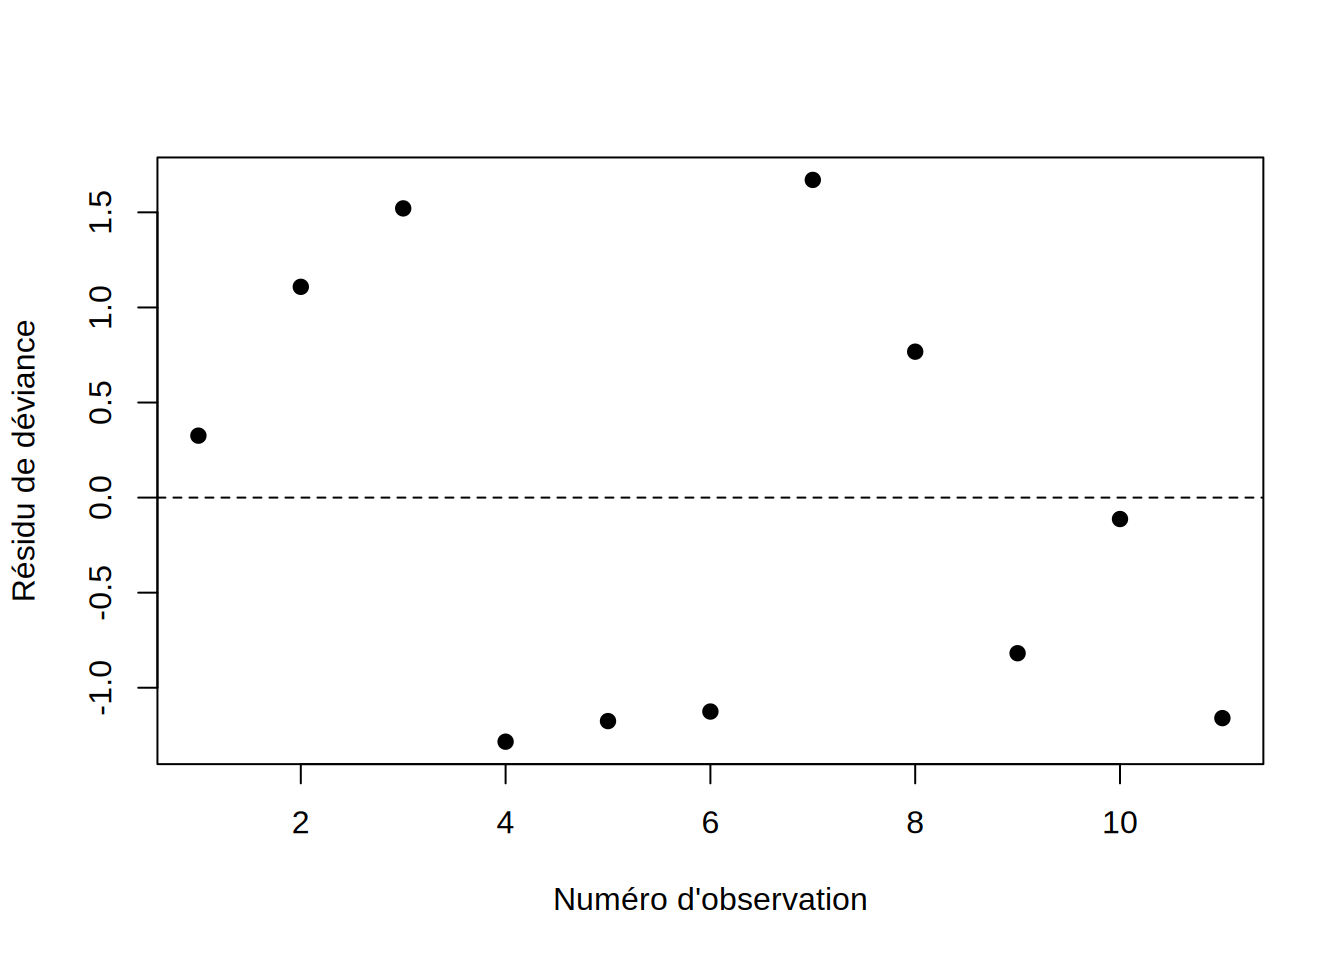
res_dev <-residuals(modele_agrege_complet, type ="deviance")plot(res_dev, xlab ="Numéro d'observation", ylab ="Résidu de déviance",pch =19)abline(h =0, lty =2)abline(h =c(-3, 3), lty =3, col ="red")
Ici, aucun résidu ne dépasse les seuils à \(\pm 3\) (pointillés rouges), mais plusieurs approchent \(\pm 1{,}5\) pour seulement 11 observations, ce qui reste un signal à vérifier.
Estimation de \(\phi\) et passage au modèle quasibinomial
Call:
glm(formula = cbind(survivants, effectif - survivants) ~ classe_num +
    sexe + groupe_age, family = quasibinomial, data = empress_agrege)

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)       -0.6517     0.4794  -1.359   0.2162
classe_num        -0.5034     0.1798  -2.799   0.0266 *
sexeHomme          1.0211     0.2947   3.465   0.0105 *
groupe_ageEnfant  -2.0991     0.7985  -2.629   0.0340 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for quasibinomial family taken to be 2.393388)

    Null deviance: 99.007  on 10  degrees of freedom
Residual deviance: 13.349  on  7  degrees of freedom
AIC: NA

Number of Fisher Scoring iterations: 5
summary(modele_agrege_complet)
Call:
glm(formula = cbind(survivants, effectif - survivants) ~ classe_num +
    sexe + groupe_age, family = binomial, data = empress_agrege)

Coefficients:
                 Estimate Std. Error z value Pr(>|z|)
(Intercept)       -0.6517     0.3099  -2.103   0.0355 *
classe_num        -0.5034     0.1162  -4.331 1.49e-05 ***
sexeHomme          1.0211     0.1905   5.361 8.28e-08 ***
groupe_ageEnfant  -2.0991     0.5161  -4.067 4.76e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 99.007  on 10  degrees of freedom
Residual deviance: 13.349  on  7  degrees of freedom
AIC: 55.932

Number of Fisher Scoring iterations: 5
On estime \(\hat\phi \approx 2{,}4\) : la variance observée est environ 2,4 fois plus grande que ce que prédit le modèle binomial, un signe net d’extra-variabilité. Le passage au modèle quasibinomial gonfle les erreurs-types en conséquence, sans changer les estimations ponctuelles des \(\beta_j\). Malgré ce gonflement, les trois valeurs-p restent sous le seuil de 5% (classe_num : \(p\approx 0{,}027\) ; sexeHomme : \(p\approx 0{,}011\) ; groupe_ageEnfant : \(p\approx 0{,}034\)) : les trois effets demeurent significatifs une fois la surdispersion prise en compte.
Vérification de la linéarité : \(\hat\pi_i\) contre \(\tilde\pi_i\)
Les points suivent globalement la droite \(y = x\) (corrélation d’environ 0,87), mais avec une dispersion notable pour un aussi petit nombre de groupes — cohérent avec l’extra-variabilité détectée ci-dessus.
Observations aberrantes et valeurs influentes
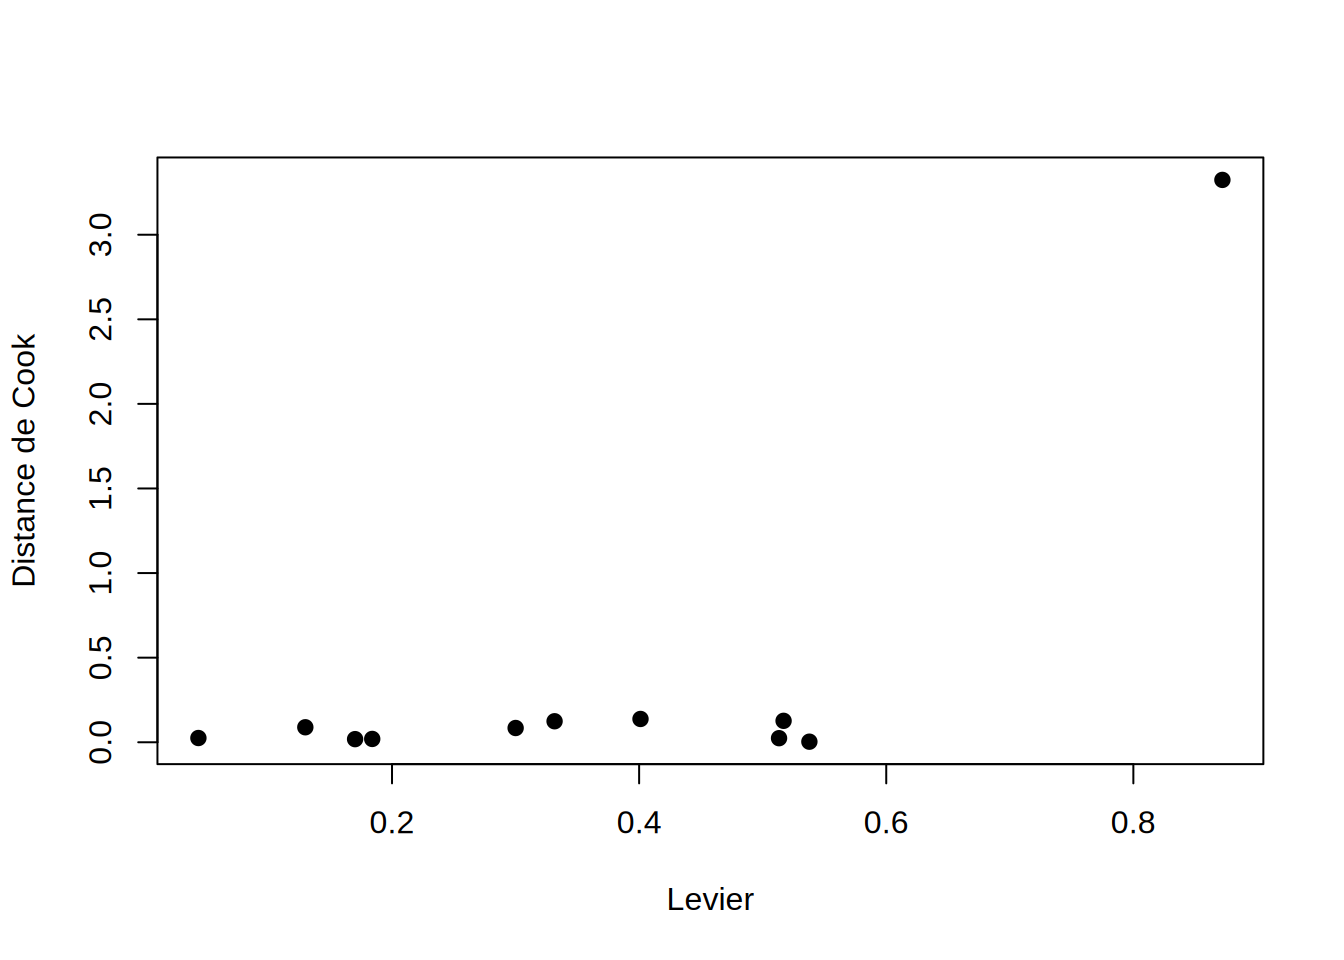
lev <-hatvalues(modele_agrege_complet_quasi)rstd <-rstandard(modele_agrege_complet_quasi, type ="pearson")rstu <-rstudent(modele_agrege_complet_quasi)cook <-cooks.distance(modele_agrege_complet_quasi)dfb <-dfbetas(modele_agrege_complet_quasi)dff <-dffits(modele_agrege_complet_quasi)plot(lev, cook, xlab ="Levier", ylab ="Distance de Cook", pch =19)
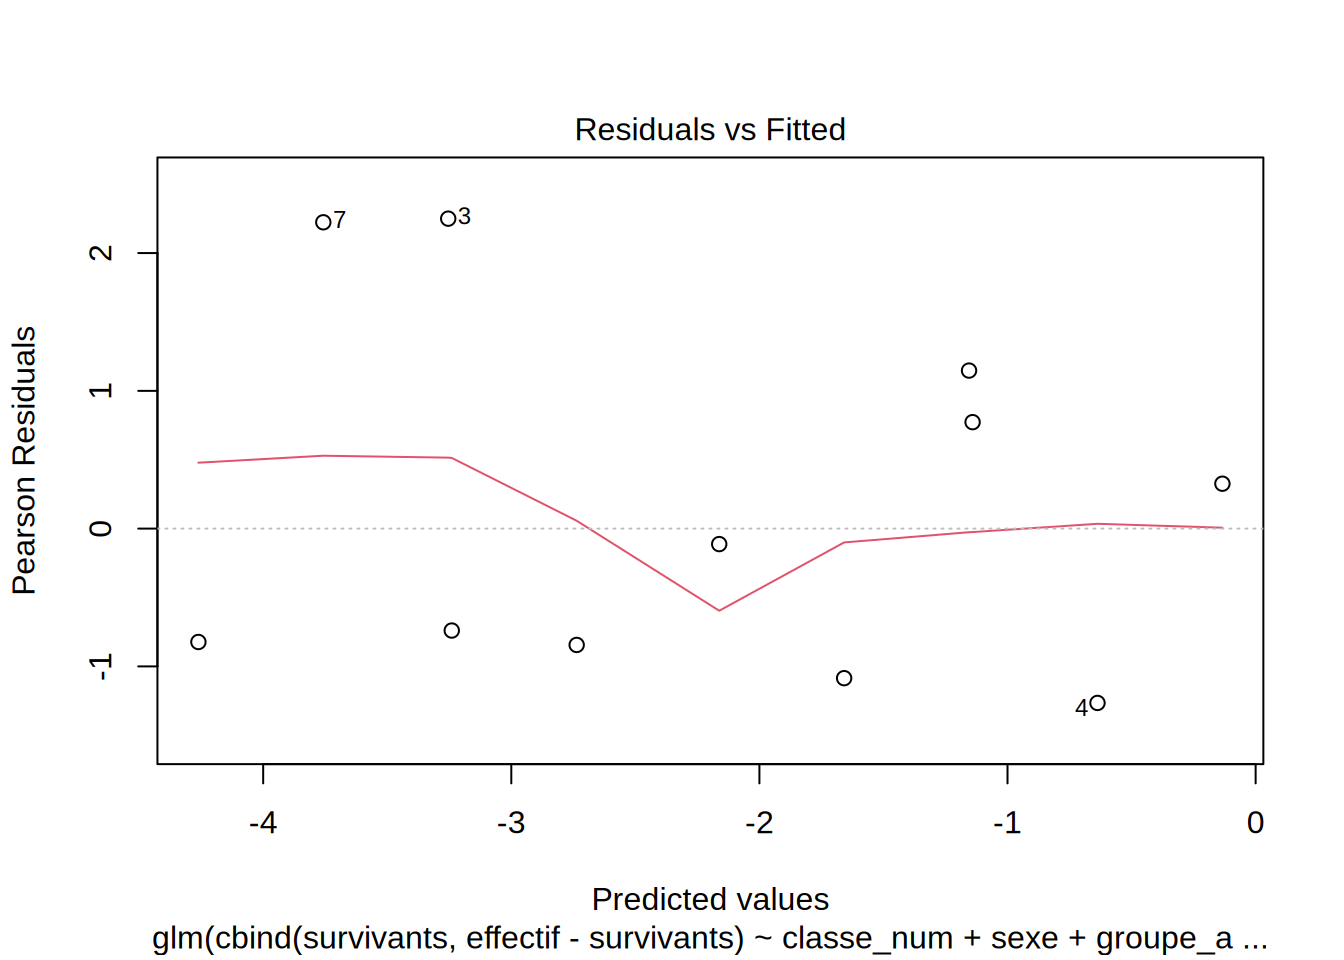
plot(modele_agrege_complet_quasi, which =1)
Le graphique des résidus vs valeurs ajustées met en évidence un point nettement à l’écart des autres.
plot(modele_agrege_complet_quasi, which =2)
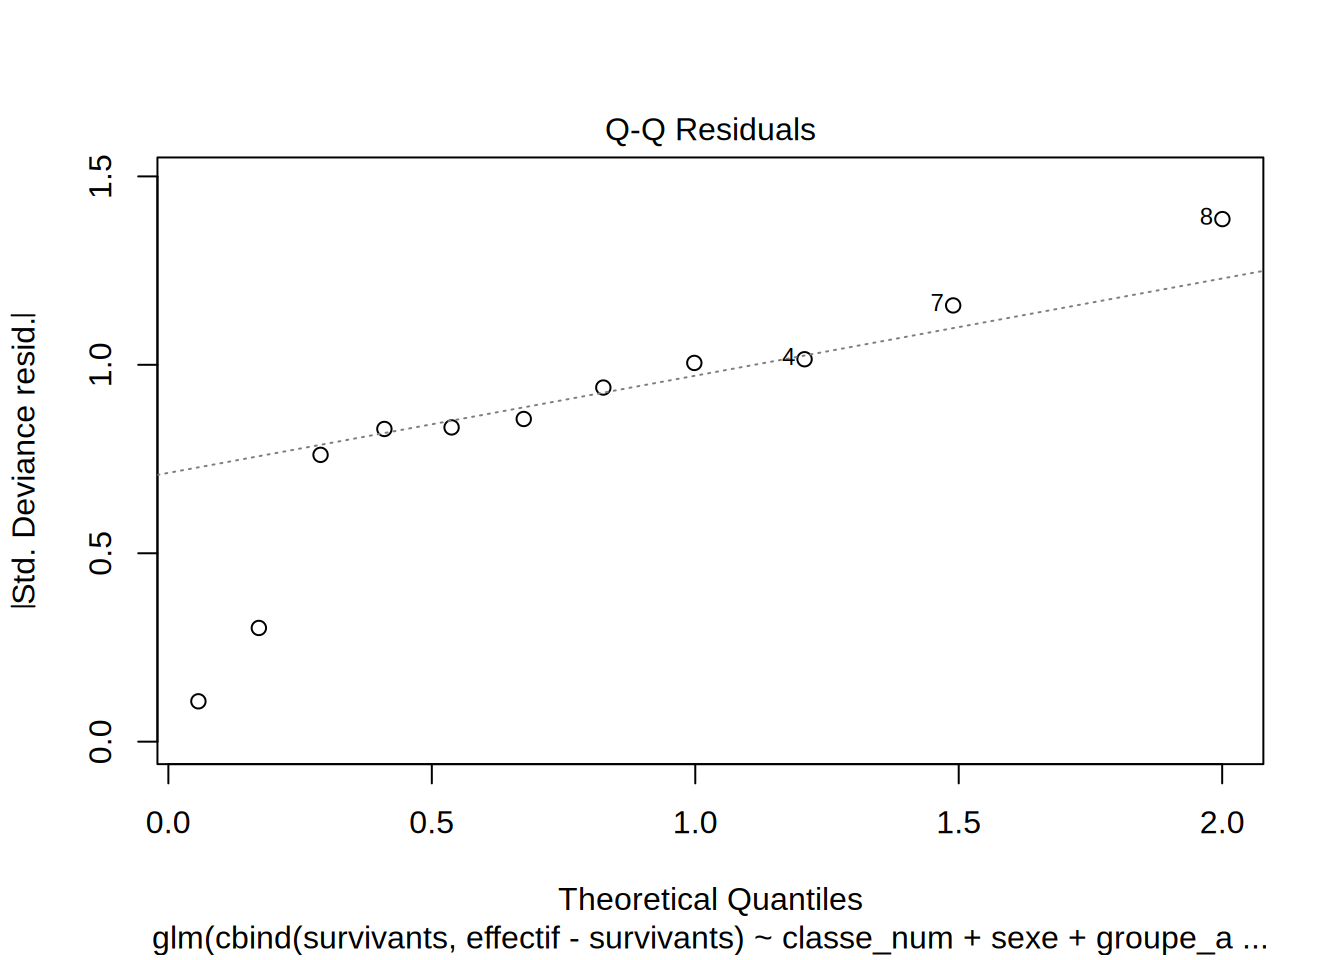
Le QQ-plot ne montre pas d’écart marqué à la normalité asymptotique des résidus, malgré le petit nombre d’observations.
plot(modele_agrege_complet_quasi, which =3)
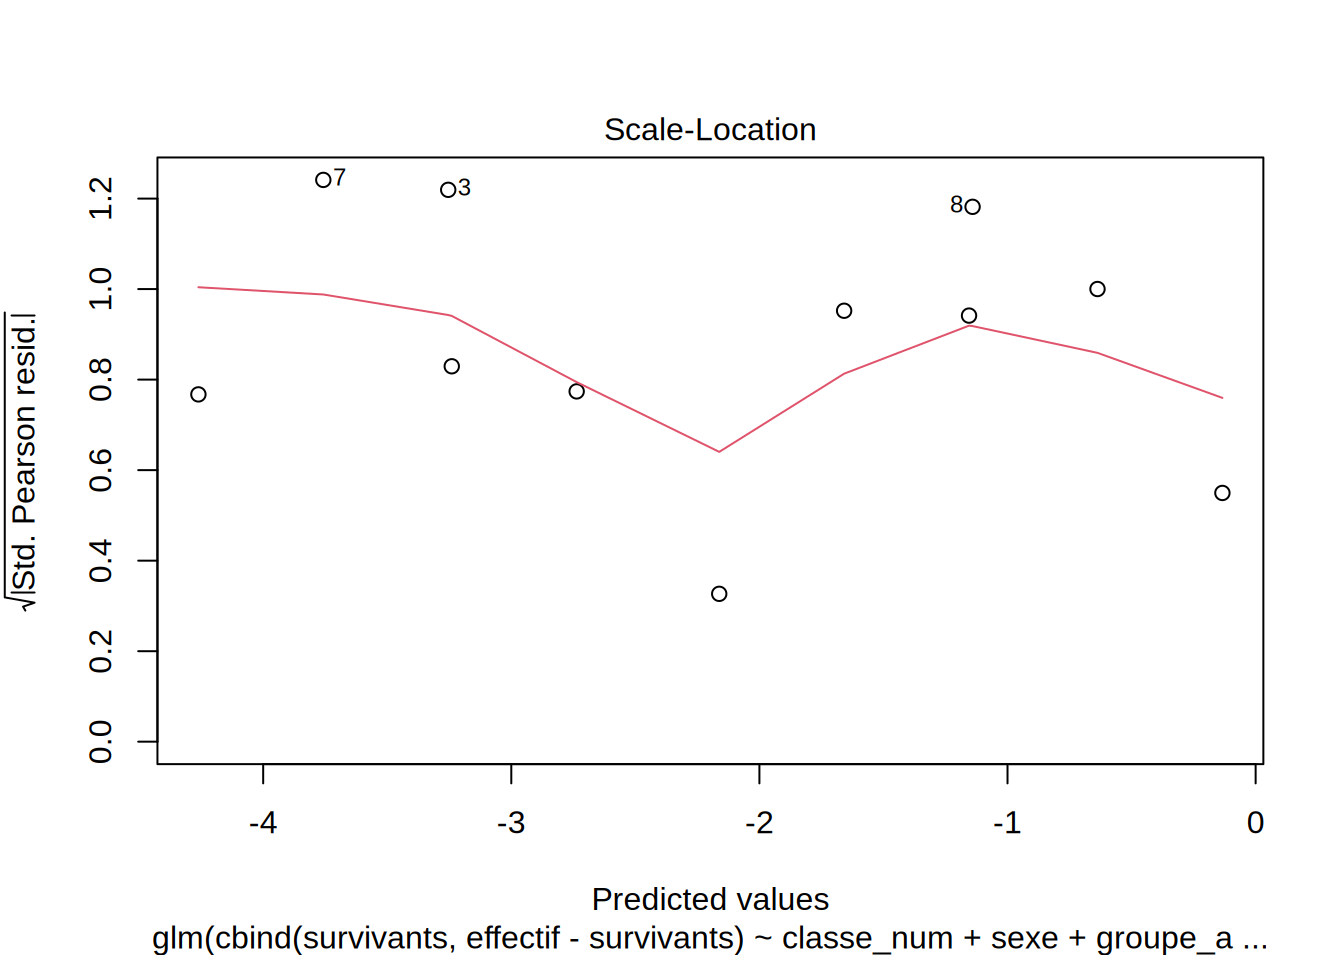
Le graphique Scale-Location confirme une dispersion des résidus qui n’est pas parfaitement constante.
plot(modele_agrege_complet_quasi, which =4)
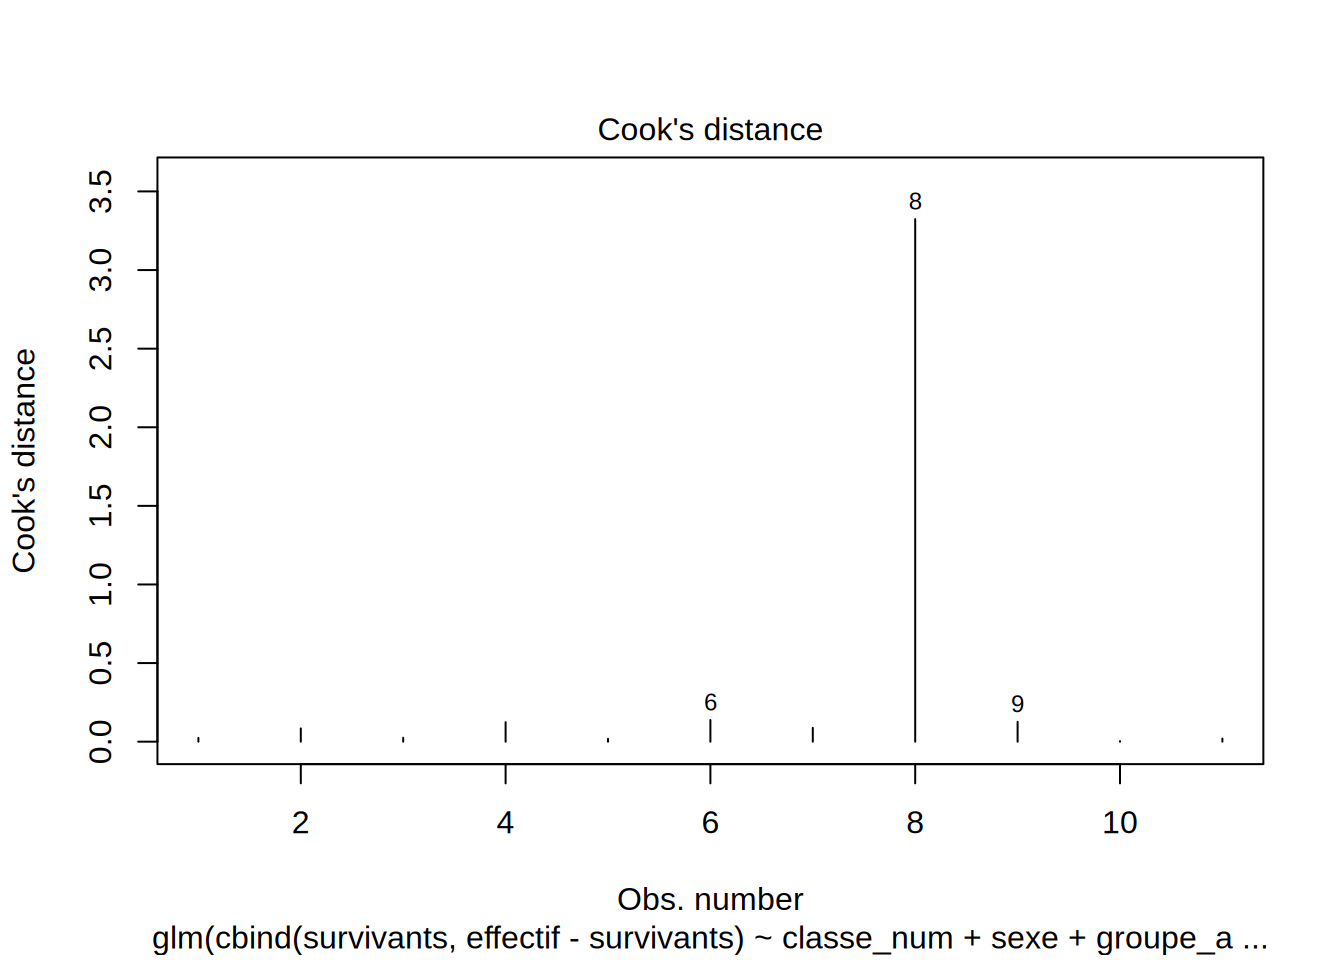
La distance de Cook pointe très clairement vers une seule observation influente.
Le seuil usuel pour un levier élevé est \(2(p+1)/n\), ici environ \(0{,}73\). L’observation 8 (troisième classe, hommes adultes) le dépasse largement, avec un levier de \(0{,}87\) et une distance de Cook de \(3{,}32\) — loin devant toutes les autres observations (qui restent sous \(0{,}14\)). Ses DFBETAS et son DFFITS (\(\approx 4{,}6\), contre moins de \(0{,}9\) en valeur absolue ailleurs) confirment qu’elle déplace fortement l’ajustement. Ce n’est pas surprenant : ce groupe représente à lui seul 446 des 1057 passagers (42 %), donc le modèle doit nécessairement bien reproduire son taux de survie sous peine de voir la déviance globale exploser — un effet de poids d’échantillon plutôt qu’une anomalie des données.
2.5 Spécificité, sensibilité et courbe ROC
Pour des données individuelles, l’adéquation est difficile à évaluer, mais on peut mesurer la capacité prédictive du modèle. On ajuste le modèle et on calcule les probabilités prédites \(\hpi{i} = g^{-1}(\heta{i})\).
Fixons un seuil \(u \in [0,1]\) (souvent \(u=1/2\)). On classe \(\hat y_i = 1\) si \(\hpi{i} > u\) et \(\hat y_i = 0\) sinon.
Définition — Spécificité et sensibilité
On mesure la capacité prédictive par :
\[
\begin{aligned}
\text{Spécificité (taux de vrais négatifs) :}\quad & Spec = P(\hat y = 0 \mid y = 0),\\
\text{Sensibilité (taux de vrais positifs) :}\quad & Sens = P(\hat y = 1 \mid y = 1).
\end{aligned}
\]
Pour un \(u\) fixé, on les estime par \[\widehat{Spec}(u) = \frac{\sum_{i=1}^n \mathbf{1}_{\{(\hpi{i} < u)\,\&\,(y_i = 0)\}}}{\sum_{i=1}^n \mathbf{1}_{\{y_i = 0\}}},
\qquad
\widehat{Sens}(u) = \frac{\sum_{i=1}^n \mathbf{1}_{\{(\hpi{i} > u)\,\&\,(y_i = 1)\}}}{\sum_{i=1}^n \mathbf{1}_{\{y_i = 1\}}}.\]
Définition — Courbe ROC et AUC
En faisant varier \(u\) sur une grille \(\{u_1 = 0, u_2, \ldots, u_B = 1\}\) et en traçant les points \(\{(1-\widehat{Spec}(u_b),\, \widehat{Sens}(u_b))\}\), on obtient la courbe ROC. L’aire sous la courbe (AUC) quantifie la capacité prédictive : \[\mbox{AUC} \in \begin{cases}
[0.9,\,1] & \mbox{modèle excellent},\\
[0.8,\,0.9) & \mbox{modèle bon},\\
[0.7,\,0.8) & \mbox{modèle moyen},\\
[0.6,\,0.7) & \mbox{modèle mauvais},\\
[0.5,\,0.6) & \mbox{modèle très faible}.
\end{cases}\]
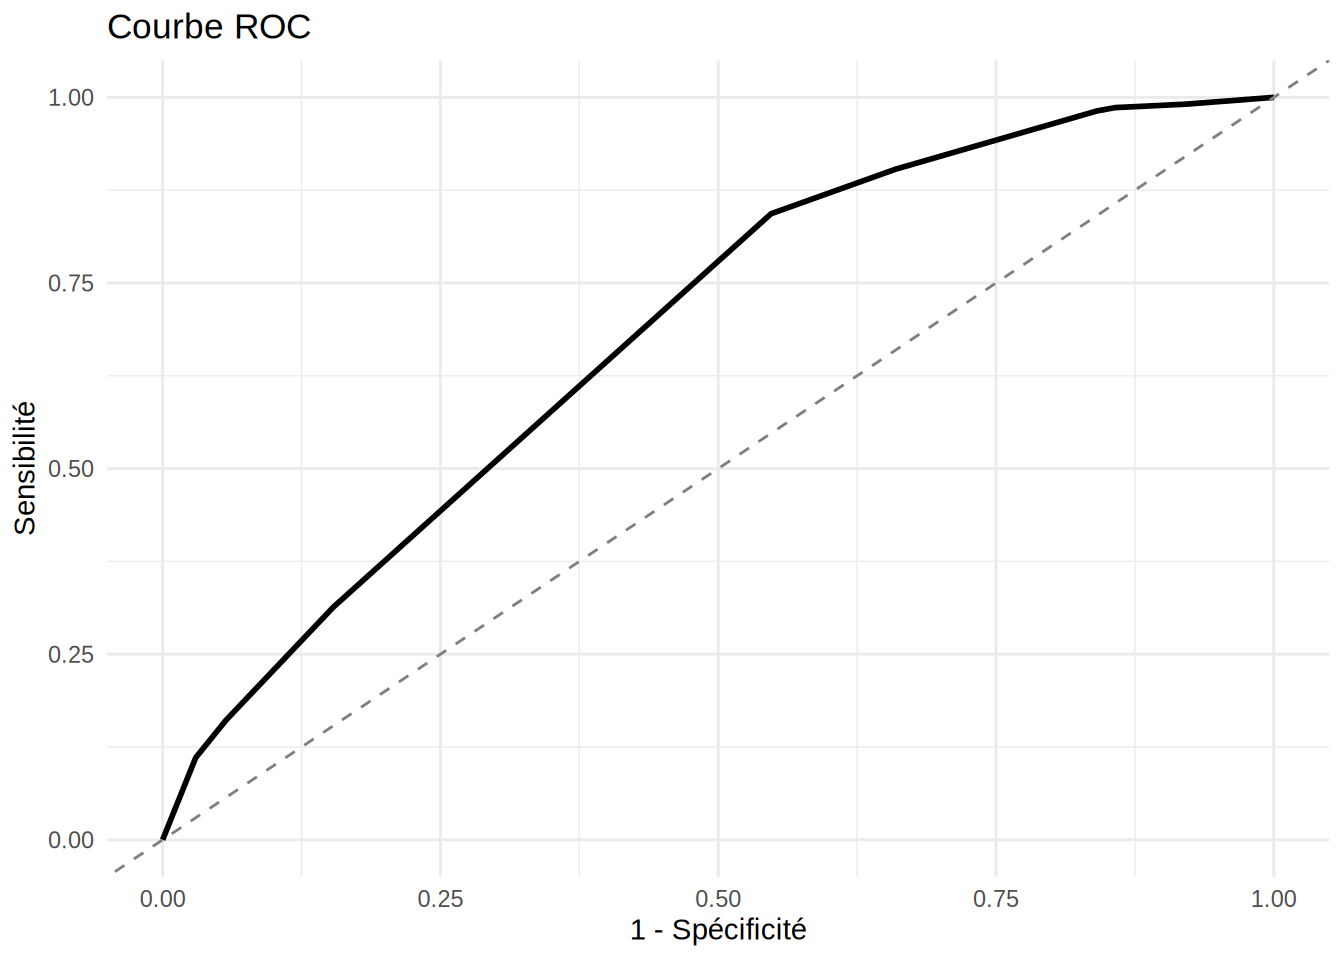
On reprend ici modele_indiv_final, le modèle retenu par la sélection automatique (classe + sexe + groupe_age), et on construit la courbe ROC directement à partir des estimateurs \(\widehat{Spec}(u)\) et \(\widehat{Sens}(u)\) définis plus haut :
# Aire sous la courbe par la règle du trapèzeauc <-sum(diff(1- roc$specificite) * (head(roc$sensibilite, -1) +tail(roc$sensibilite, -1)) /2)auc
[1] 0.6825598
L’aire sous la courbe est d’environ 0.68 : le modèle est mauvais selon l’échelle donnée plus haut. La classe, le sexe et le groupe d’âge influencent bien la survie (comme le confirment les tests précédents), mais ils sont loin de suffire à prédire, au niveau individuel, qui a survécu ou non — beaucoup d’autres facteurs (emplacement exact au moment de l’impact, capacité physique, chance) ont joué un rôle.
2.6 Pour aller plus loin
Les exemples ci-dessus s’appuient tous sur le jeu de données empress. Les librairies R GLMsData(Dunn et Smyth 2018) et faraway(Faraway 2025) offrent d’autres jeux de données classiques pour la régression binaire, repris ici avec les mêmes analyses que dans les sections précédentes.
quilpie : observations de 1921 à 1988 de la quantité de pluie mesurée en juillet à Quilpie (Australie), une ville semi-aride du Queensland où les précipitations conditionnent fortement l’agriculture locale. La réponse vaut 1 si la quantité de pluie dépasse 10 mm (un seuil jugé suffisant pour amorcer les semis) et 0 sinon ; la variable explicative est un indice de pression atmosphérique, le Southern Oscillation Index (SOI), qui capture les phases El Niño/La Niña connues pour influencer les précipitations dans cette région.
nminer : 31 transects de deux hectares en milieu boisé (eucalyptus) dans l’ouest de Victoria (Australie) ; la réponse vaut 1 si au moins un mineur bruyant (Manorina melanocephala, un oiseau indigène particulièrement agressif qui chasse les espèces plus petites) est détecté dans le transect et 0 sinon. Les variables explicatives décrivent l’habitat : densité d’eucalyptus (Eucs), superficie du transect (Area), présence de pâturage (Grazed), présence d’arbustes (Shrubs), nombre d’arbres de type buloke (Bulokes) et quantité de bois mort au sol (Timber).
deposit : 18 observations sur l’efficacité de trois insecticides (\(A\), \(B\) ou \(C\)) appliqués à différentes doses (en mg) sur des insectes ; la réponse \(Y_i\) est le nombre d’insectes tués parmi les \(m_i\) insectes exposés à chaque combinaison insecticide-dose.
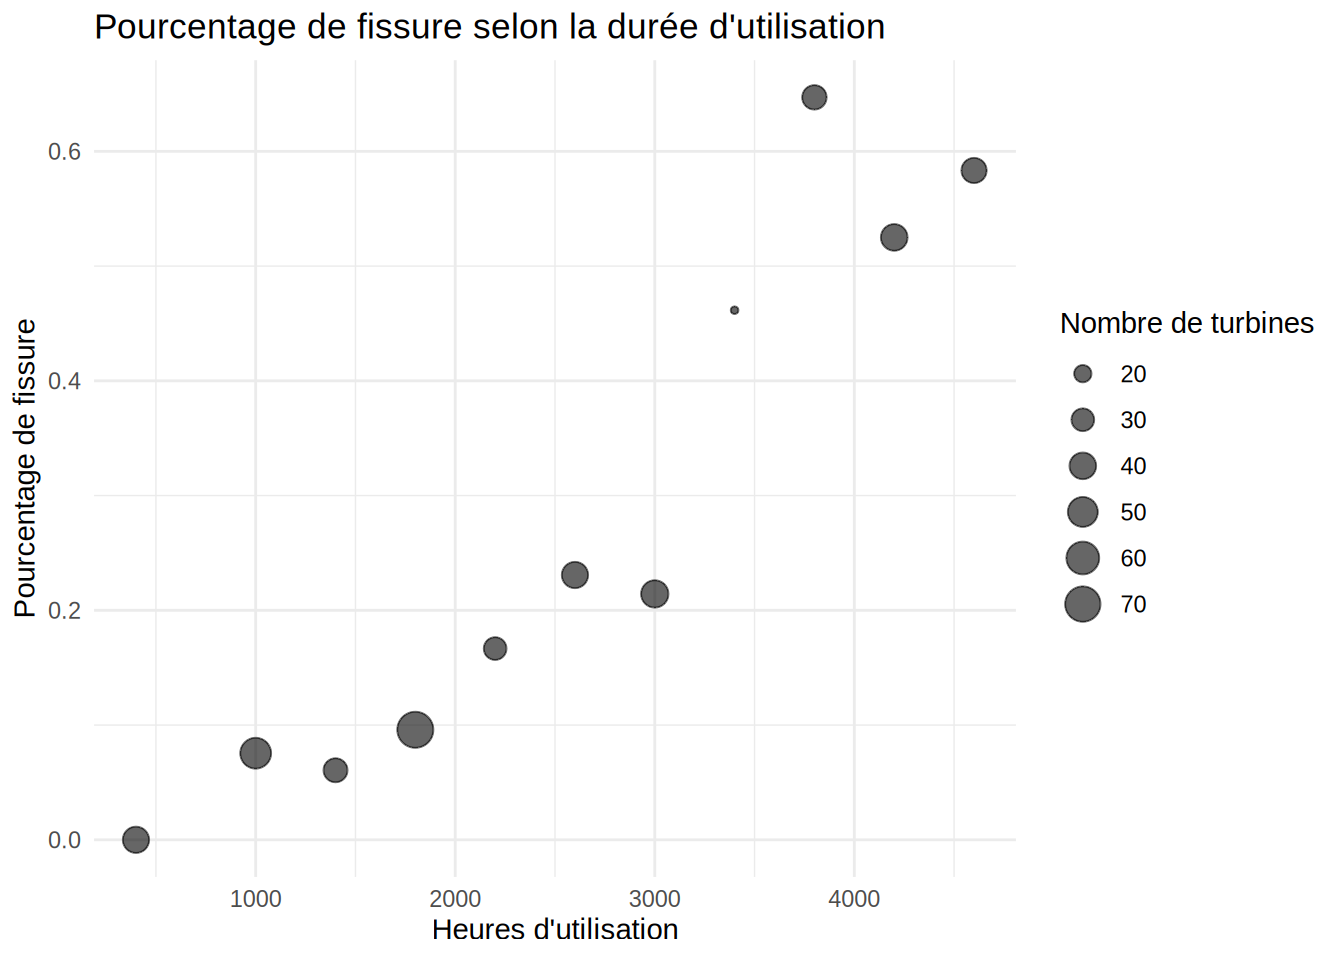
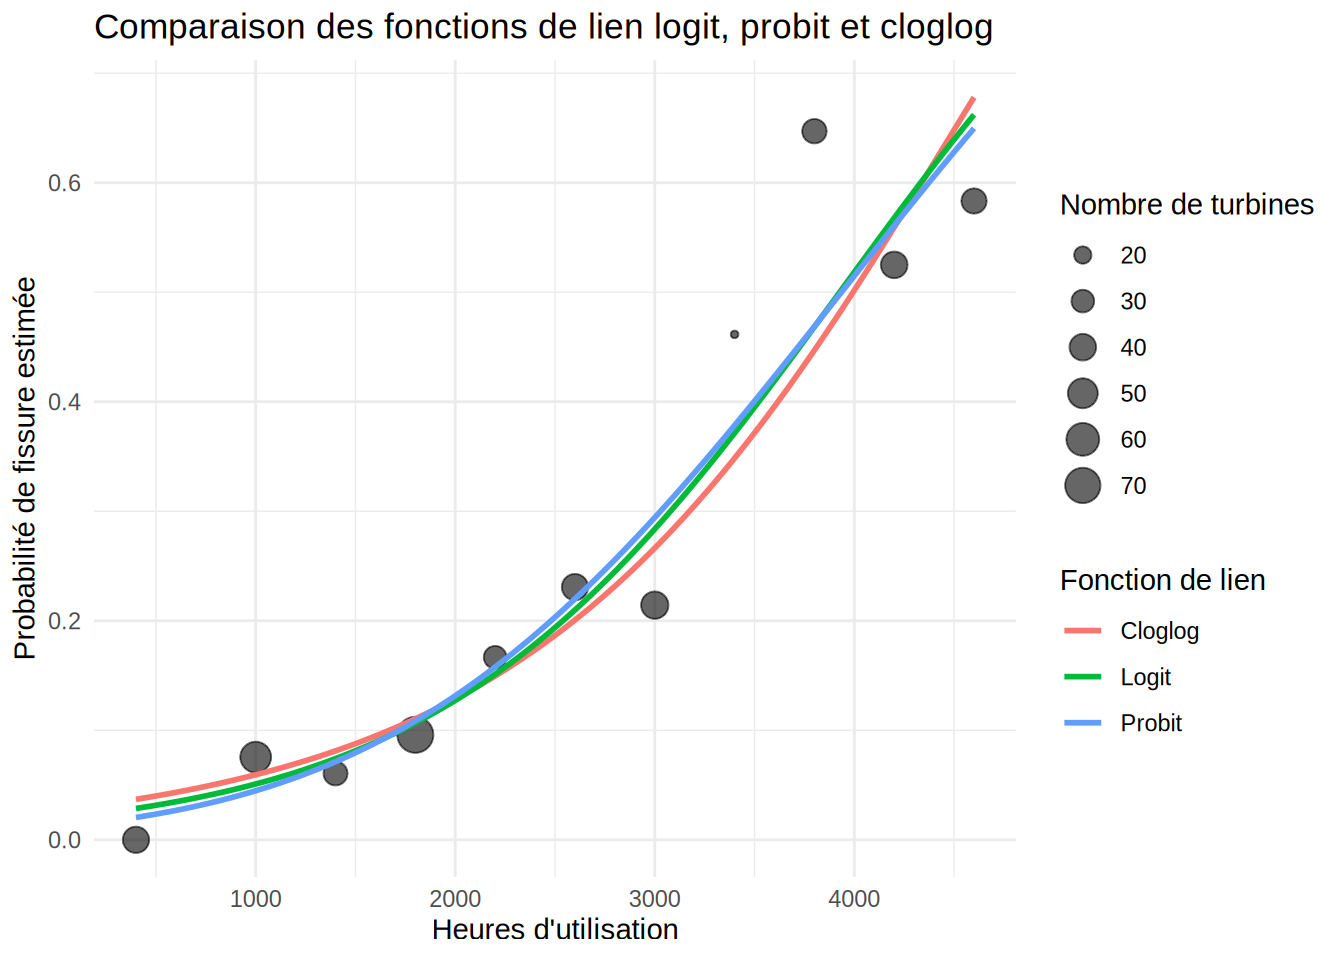
turbines : 11 observations issues d’une expérience de fiabilité sur des roues de turbine (Nelson 1982) ; la réponse \(Y_i\) est le nombre de roues présentant des fissures parmi \(m_i\) roues mises à l’essai, en fonction du nombre d’heures de fonctionnement.
troutegg : 20 observations issues d’une expérience où des boîtes d’œufs de truite ont été enfouies à cinq emplacements différents d’un cours d’eau (location) et retirées après quatre durées différentes (period, en semaines) ; la réponse \(Y_i\) est le nombre d’œufs survivants parmi les \(m_i\) œufs de la boîte.
Puisque la valeur-p affichée ci-dessus est supérieure au seuil de 5%, on ne rejette pas \(H_0\) : le modèle réduit est adéquat.
2.6.3 AIC et sélection automatique avec nminer
Exemple — Modèles non emboîtés avec nminer
data(nminer)nminer$Detecte <-as.numeric(nminer$Minerab >0)mod1.nminer <-glm(Detecte ~ Area + Grazed + Shrubs + Timber,data = nminer, family = binomial)mod2.nminer <-glm(Detecte ~ Eucs + Grazed + Bulokes,data = nminer, family = binomial)AIC(mod1.nminer)
[1] 46.86053
AIC(mod2.nminer)
[1] 24.94172
Le modèle 2 a un AIC plus faible que le modèle 1 et lui est donc préférable.
À noter, les variables explicatives ont été choisies au hasard ici.
Exemple — Sélection automatique sur le jeu de données nminer
data(nminer)# On construit la réponse binaire décrite dans le texte :# 1 si au moins un mineur bruyant a été détecté, 0 sinonnminer$Detecte <-as.numeric(nminer$Minerab >0)# Modèle complet : effets additifs de toutes les variables explicatives disponiblesmodele.complet.nminer <-glm(Detecte ~ Eucs + Area + Grazed + Shrubs + Bulokes + Timber,data = nminer, family = binomial)
Warning: glm.fit: fitted probabilities numerically 0 or 1 occurred
# Backward : part du modèle complet, retire des termesmodele.backward.nminer <-step(modele.complet.nminer, direction ="backward")
# Forward : part du modèle vide, ajoute des termes jusqu'au modèle completmodele.vide.nminer <-glm(Detecte ~1, data = nminer, family = binomial)modele.forward.nminer <-step(modele.vide.nminer, direction ="forward",scope =formula(modele.complet.nminer))
Call:
glm(formula = Detecte ~ Eucs + Grazed + Shrubs + Timber, family = binomial,
    data = nminer)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -6.7086     4.3062  -1.558   0.1193
Eucs          1.4941     0.8688   1.720   0.0855 .
Grazed       12.7870     8.1296   1.573   0.1157
Shrubs       -5.9792     4.5601  -1.311   0.1898
Timber       -0.5258     0.3294  -1.596   0.1105
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 42.6843  on 30  degrees of freedom
Residual deviance:  9.2721  on 26  degrees of freedom
AIC: 19.272

Number of Fisher Scoring iterations: 9
summary(modele.forward.nminer)
Call:
glm(formula = Detecte ~ Eucs + Grazed + Timber + Shrubs, family = binomial,
    data = nminer)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -6.7086     4.3062  -1.558   0.1193
Eucs          1.4941     0.8688   1.720   0.0855 .
Grazed       12.7870     8.1296   1.573   0.1157
Timber       -0.5258     0.3294  -1.596   0.1105
Shrubs       -5.9792     4.5601  -1.311   0.1898
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 42.6843  on 30  degrees of freedom
Residual deviance:  9.2721  on 26  degrees of freedom
AIC: 19.272

Number of Fisher Scoring iterations: 9
summary(modele.step.nminer)
Call:
glm(formula = Detecte ~ Eucs + Grazed + Shrubs + Timber, family = binomial,
    data = nminer)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -6.7086     4.3062  -1.558   0.1193
Eucs          1.4941     0.8688   1.720   0.0855 .
Grazed       12.7870     8.1296   1.573   0.1157
Shrubs       -5.9792     4.5601  -1.311   0.1898
Timber       -0.5258     0.3294  -1.596   0.1105
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 42.6843  on 30  degrees of freedom
Residual deviance:  9.2721  on 26  degrees of freedom
AIC: 19.272

Number of Fisher Scoring iterations: 9
Dans cet exemple, les trois méthodes convergent vers le même modèle final, ce qui n’est pas toujours le cas : comme chacune n’explore qu’un chemin restreint parmi tous les sous-modèles possibles (ajoutant ou retirant une variable à la fois), rien ne garantit qu’elles aboutissent au même optimum local (et encore moins à l’optimum global). Comme toujours, on compare chaque valeur-p des tableaux summary() ci-dessus au seuil de 5% pour juger de la significativité individuelle de chaque coefficient du modèle retenu.
2.6.4 Test d’adéquation avec turbines
Exemple — Test d’adéquation avec l’exemple turbines
data(turbines)modele.logit.adeq <-glm(cbind(Fissures, Turbines - Fissures) ~ Hours,data = turbines, family =binomial(link ="logit"))# DévianceD <-deviance(modele.logit.adeq)ddl <-df.residual(modele.logit.adeq)p.deviance <-1-pchisq(D, df = ddl)# Khi-deux de Pearsonchi2.pearson <-sum(residuals(modele.logit.adeq, type ="pearson")^2)p.pearson <-1-pchisq(chi2.pearson, df = ddl)data.frame(Statistique =c("Déviance", "Khi-deux de Pearson"),Valeur =c(D, chi2.pearson),ddl = ddl,p.valeur =c(p.deviance, p.pearson))
On compare chacune des deux valeurs de p.valeur ci-dessus au seuil de 5% : si elle lui est supérieure, on ne rejette pas l’adéquation du modèle ; si elle lui est inférieure, on la rejette à ce seuil.
2.6.5 Diagnostics de surdispersion avec troutegg
Exemple — Diagnostics de surdispersion — données troutegg
On ajuste un modèle binomial sur les données troutegg, qui recensent la survie d’œufs de truite selon l’emplacement dans le cours d’eau et la période de retrait.
library(faraway)data(troutegg)mod.troutegg <-glm(cbind(survive, total - survive) ~ location + period,family = binomial, data = troutegg)
Résidus en fonction du numéro d’observation
res_dev.troutegg <-residuals(mod.troutegg, type ="deviance")plot(res_dev.troutegg, xlab ="Numéro d'observation", ylab ="Résidu de déviance",pch =19)abline(h =0, lty =2)abline(h =c(-3, 3), lty =3, col ="red")
Ici, quelques résidus dépassent les seuils à \(\pm 3\) (pointillés rouges), ce qui suggère de l’extra-variabilité.
Estimation de \(\phi\) et passage au modèle quasibinomial
Les points suivent d’assez près la droite \(y = x\), sans courbure systématique apparente, ce qui appuie l’hypothèse de linéarité du prédicteur pour ce modèle.
Observations aberrantes et valeurs influentes
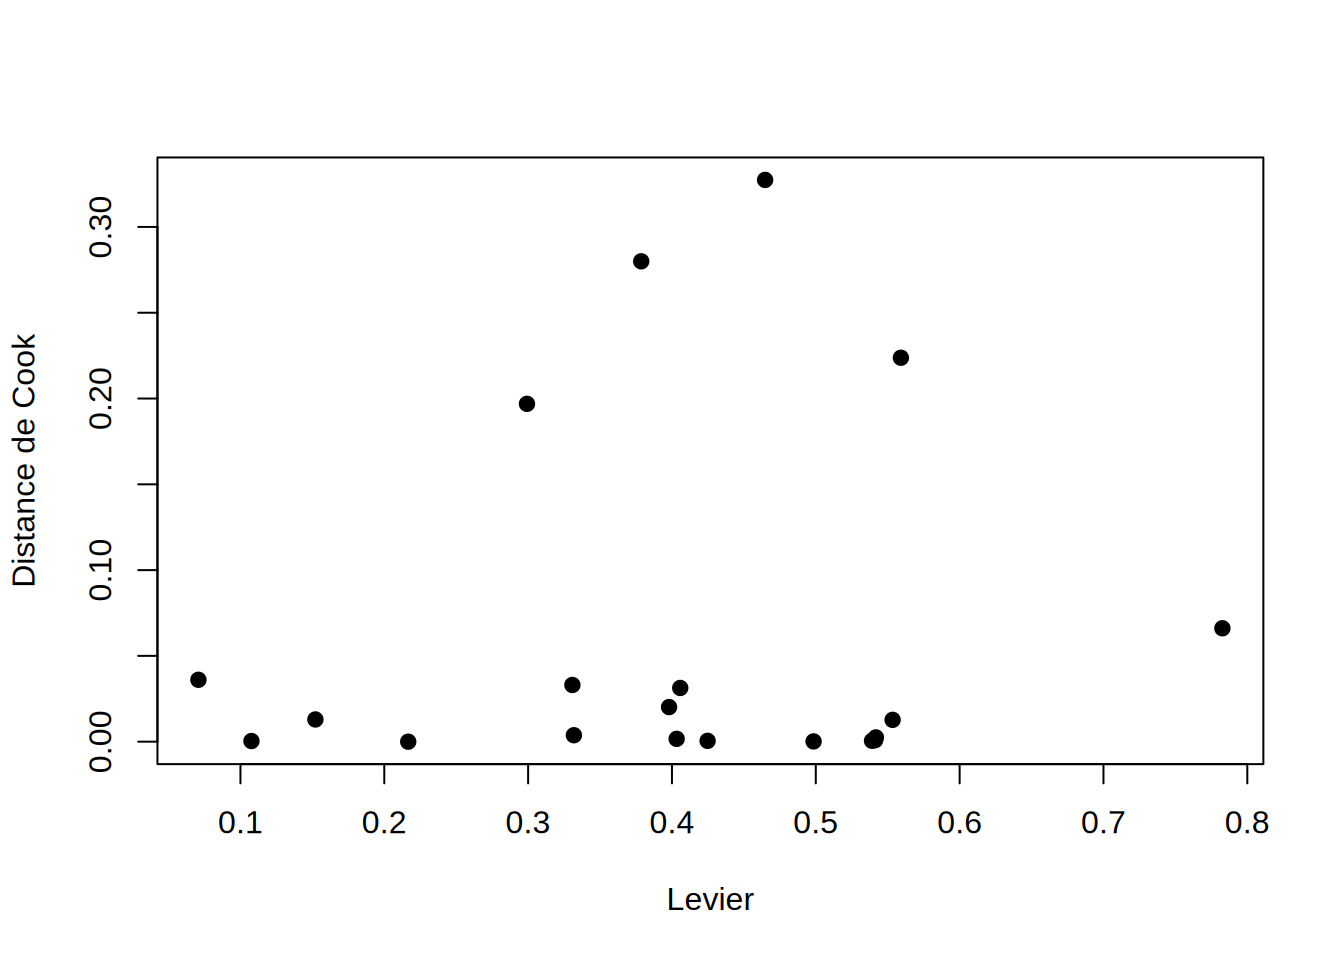
lev.troutegg <-hatvalues(mod_quasi.troutegg)rstd.troutegg <-rstandard(mod_quasi.troutegg, type ="pearson")rstu.troutegg <-rstudent(mod_quasi.troutegg)cook.troutegg <-cooks.distance(mod_quasi.troutegg)dfb.troutegg <-dfbetas(mod_quasi.troutegg)dff.troutegg <-dffits(mod_quasi.troutegg)plot(lev.troutegg, cook.troutegg, xlab ="Levier", ylab ="Distance de Cook", pch =19)
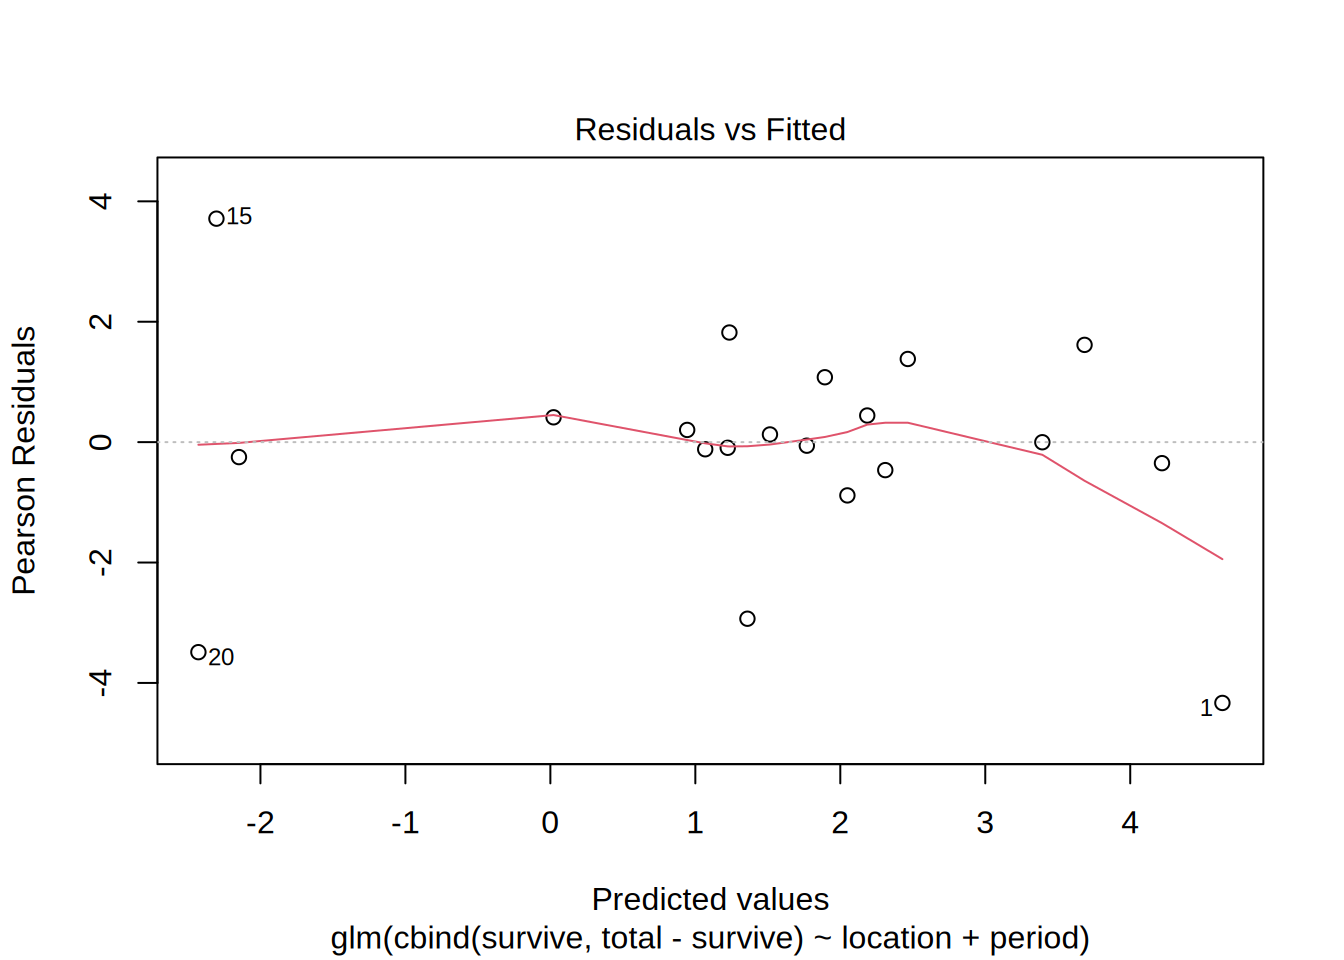
plot(mod_quasi.troutegg, which =1)
Le graphique des résidus vs valeurs ajustées montre plusieurs points nettement à l’écart (dont les observations 1, 15 et 20), suggérant que le modèle ne s’ajuste pas également bien à toutes les combinaisons de location et period.
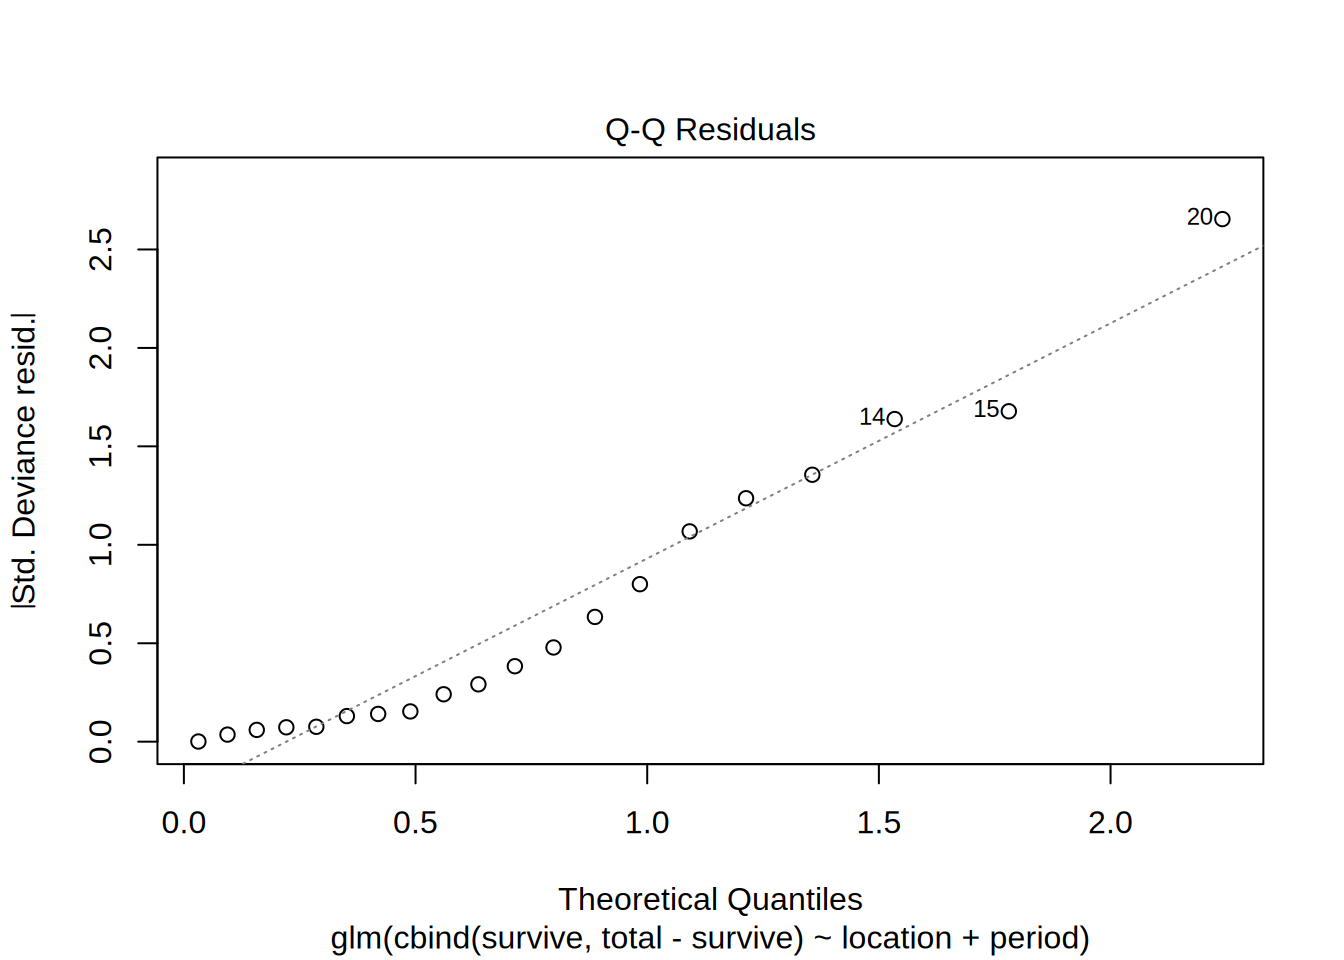
plot(mod_quasi.troutegg, which =2)
Le QQ-plot des résidus s’éloigne un peu de la droite de référence dans la queue supérieure (observations 14, 15 et 20), ce qui traduit un mauvais ajustement pour certaines observations plutôt qu’une déviation normale isolée.
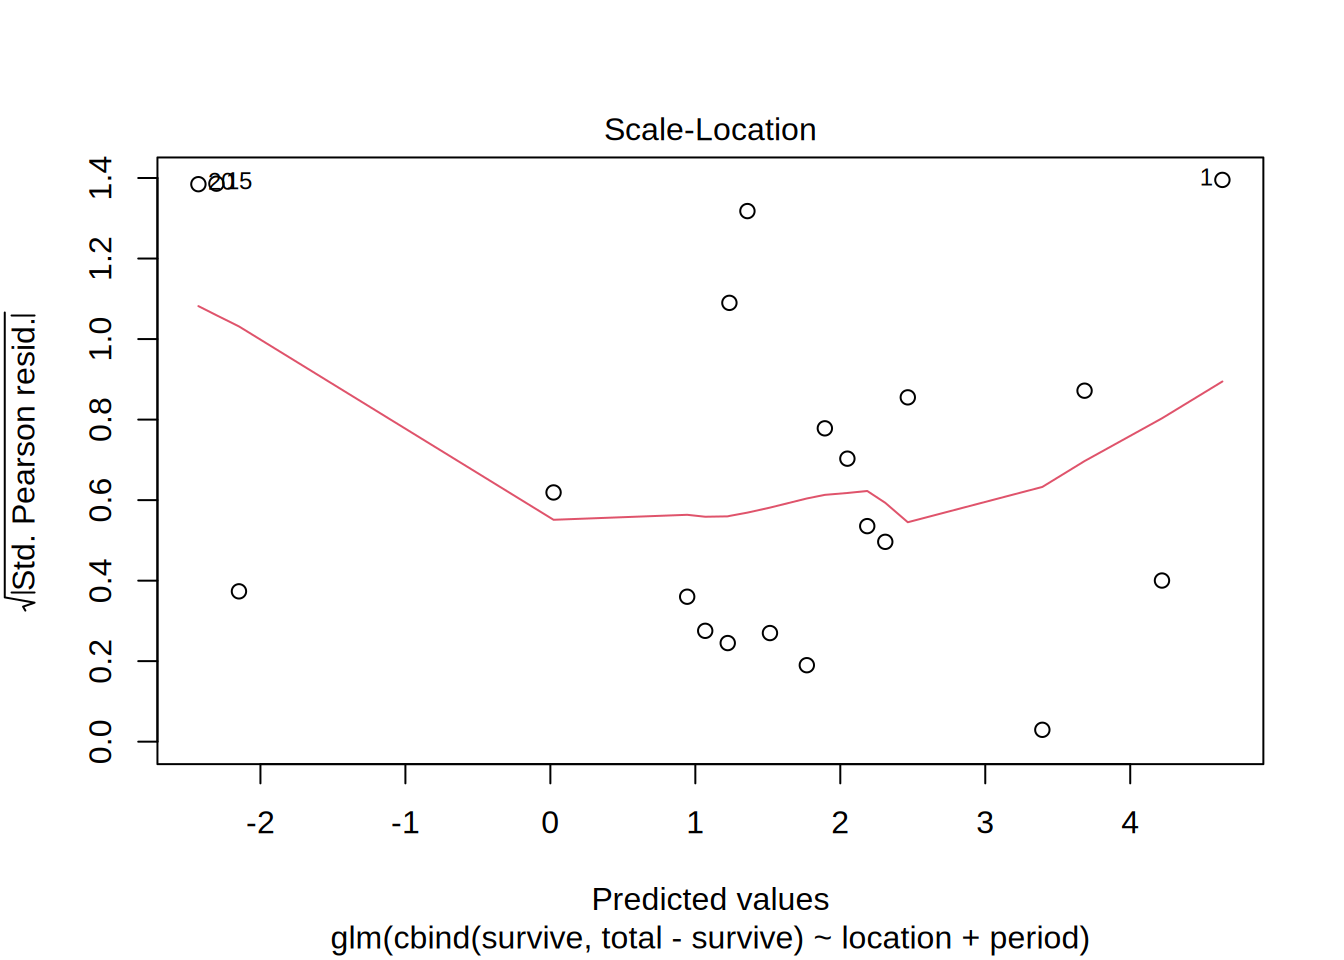
plot(mod_quasi.troutegg, which =3)
Le graphique Scale-Location révèle une dispersion des résidus qui n’est pas constante et plusieurs valeurs extrêmes (1, 14, 15, 20), malgré l’inclusion du paramètre de surdispersion.
plot(mod_quasi.troutegg, which =4)
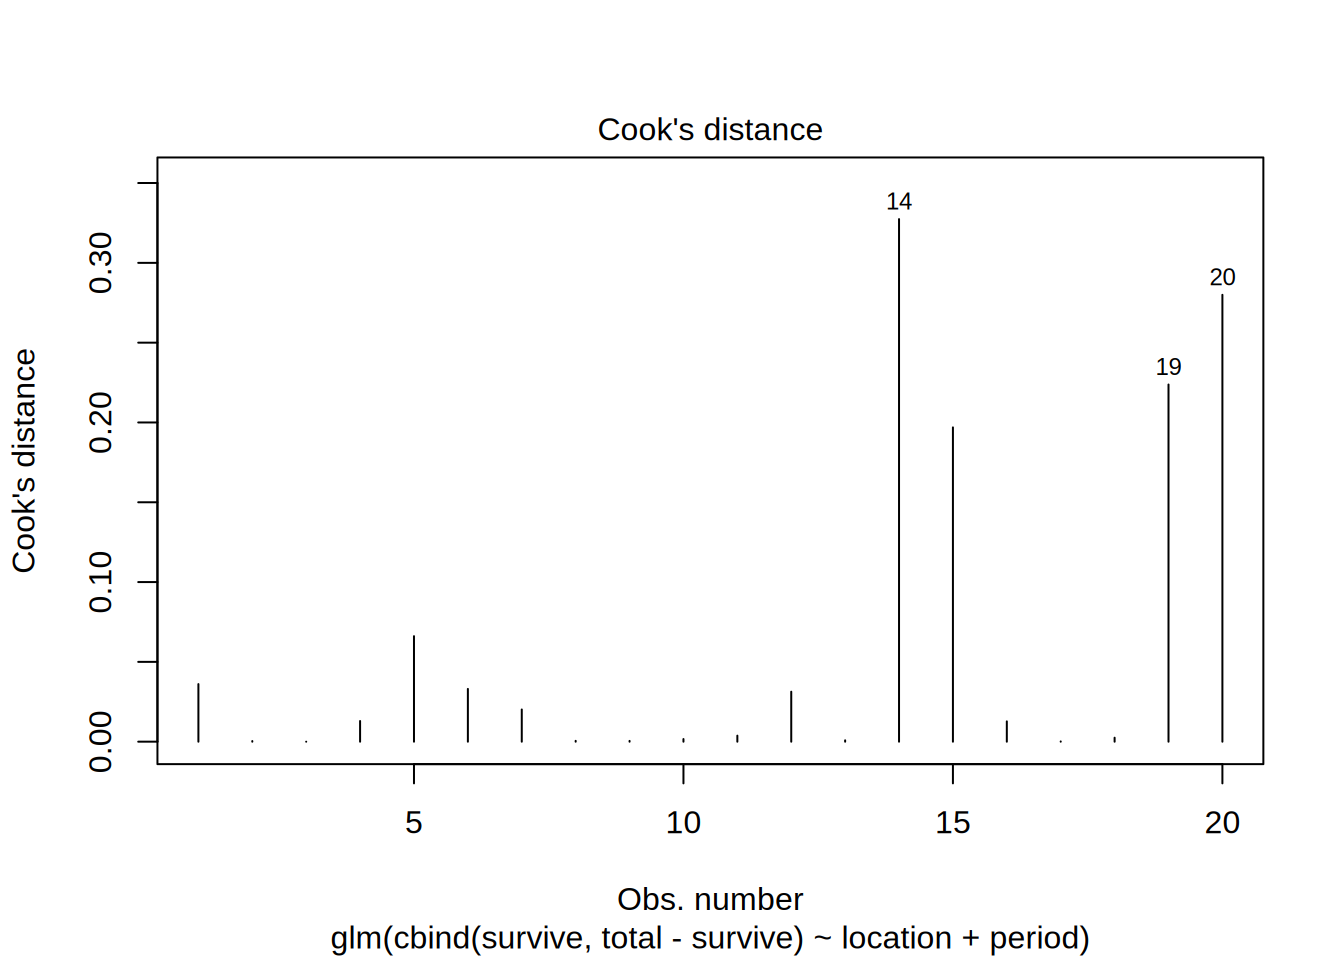
La distance de Cook pointe vers certaines observations influentes (14, 15, 19 et 20).
Le seuil usuel pour un levier élevé est \(2(p+1)/n\) ; pour la distance de Cook, on examine plutôt les valeurs qui se détachent nettement des autres.
On ajuste ici un modèle logistique avec la variable explicative SOI et le lien logit :
data(quilpie)modele.quilpie <-glm(y ~ SOI, family = binomial, data = quilpie)courbe.roc <-roc.curve(marker =as.vector(fitted(modele.quilpie)),status = quilpie$y,method =c("empirical"))courbe.roc
ROC curve with AUC = 0.7835498 and s.e. = 0.05651002
L’aire sous la courbe est de 0.78 : le modèle est moyen.
Agresti, Alan. 2013. Categorical Data Analysis. 3ᵉ éd. Wiley.
Dunn, Peter K., et Gordon K. Smyth. 2018. Generalized Linear Models with Examples in R. Springer Texts in Statistics. Springer. https://doi.org/10.1007/978-1-4419-0118-7.
Hauck, Walter W., et Allan Donner. 1977. « Wald’s Test as Applied to Hypotheses in Logit Analysis ». Journal of the American Statistical Association 72 (360): 851‑53. https://doi.org/10.1080/01621459.1977.10479969.
McCullagh, Peter, et John A. Nelder. 1989. Generalized Linear Models. 2ᵉ éd. Chapman; Hall.
Nelson, Wayne. 1982. Applied Life Data Analysis. Wiley.