6Régression non-paramétrique : \(k\) plus proches voisins et estimateur de noyau
Dernière modification
9 octobre 2026
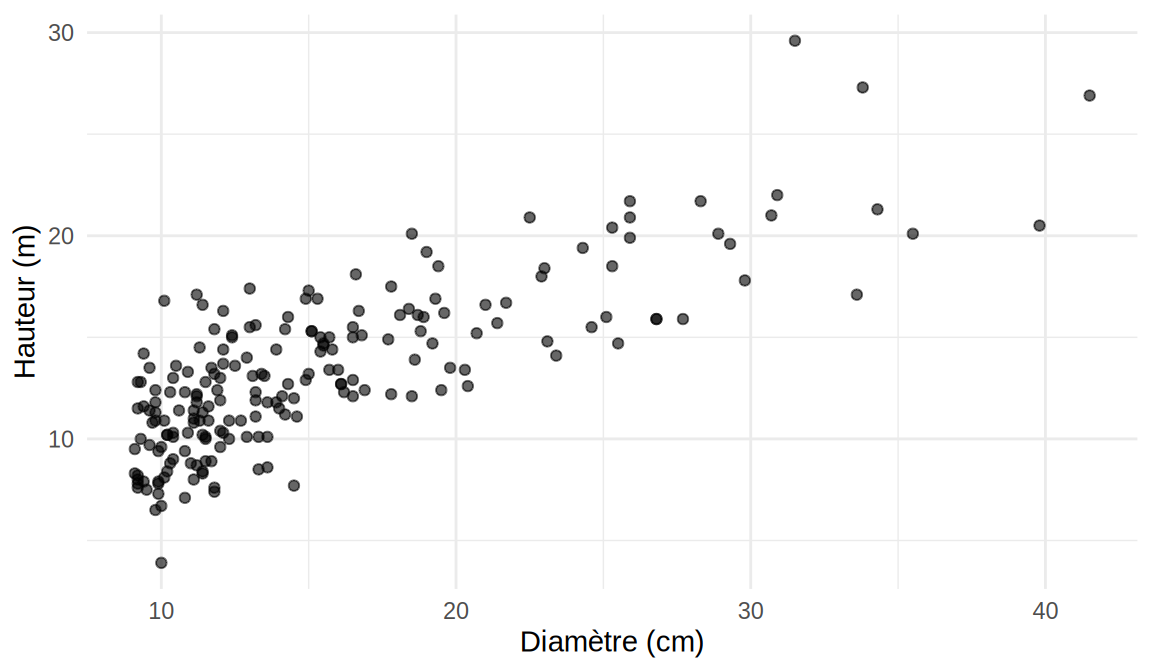
Reprenons le jeu de données arbres du Chapitre 4 : la réponse \(Y\) est la hauteur de l’arbre (height_m, en m) et la variable explicative \(X\) est son diamètre à hauteur de poitrine (diameter_cm, en cm). Le nuage de points montre que la relation entre \(X\) et \(Y\) n’est clairement pas linéaire : la hauteur croît rapidement avec le diamètre pour les petits arbres, puis de plus en plus lentement. Au Chapitre 4, on avait contourné le problème en passant à l’échelle log-log. Ce chapitre présente des approches non-paramétriques pour étudier une telle relation, sans postuler de forme fonctionnelle.
arbres <-read.csv("Jeux de données/arbres.csv")D <- arbres$diameter_cmH <- arbres$height_mn <-length(D)ggplot(arbres, aes(diameter_cm, height_m)) +geom_point(alpha =0.6) +labs(x ="Diamètre (cm)", y ="Hauteur (m)") +theme_minimal()
Figure 6.1: Hauteur en fonction du diamètre pour les 200 arbres du jeu de données arbres.
6.1 Estimateur des \(k\) plus proches voisins (\(k\)NN)
6.1.1 Définition
On suppose que la relation entre \(X\) et \(Y\) s’écrit \[Y_i = f(X_i) + \epsilon_i,\] où \(f\) est une fonction inconnue à estimer et \(\epsilon_i\) vérifie \(E[\epsilon_i\mid X_i] = 0\). On suppose \(f\) assez lisse (deux fois dérivable). Sous ces hypothèses, \[f(x) = E[Y\mid X = x].\] On suppose de plus \(X\) continue, de sorte que \(P(X_i = X_{j}) = 0\) si \(i\neq j\).
L’estimateur des \(k\) plus proches voisins (\(k\)NN) est \[\hat f(x) = \frac{1}{k}\sum_{i\in N_k(x)} Y_i,\] où \(N_k(x)\) est l’ensemble des indices des \(k\) plus proches voisins de \(x\) : on pose \(d_i(x) = |X_i - x|\), on ordonne \(d_{(1)}(x) < \cdots < d_{(n)}(x)\), et \(N_k(x)\) contient les indices \(i\) tels que \(d_i(x) \leq d_{(k)}(x)\).
En R : fonction knn.reg de la librairie FNN.
Remarque — Valeurs ex æquo
Les diamètres d’arbres sont mesurés au dixième de centimètre près : plusieurs arbres partagent donc exactement le même diamètre, contrairement à l’hypothèse \(P(X_i = X_{i'}) = 0\). Lorsque des observations sont à égale distance de \(x\), knn.reg en retient un sous-ensemble de façon arbitraire. Avec 200 arbres, l’effet sur \(\hat f\) est négligeable, mais il faut en être conscient lorsque \(X\) est fortement discrétisée.
Remarque — Choix de la distance avec une seule variable explicative
L’estimateur \(k\)NN ne dépend de la distance que par l’ordre qu’elle induit sur les observations : seule l’identité des \(k\) plus proches voisins compte, pas la valeur de \(d_i(x)\). Avec une seule variable explicative, toute distance de la forme \(d_i(x) = \phi(|X_i - x|)\) avec \(\phi\) strictement croissante (\(|X_i - x|\), \((X_i - x)^2\), \(e^{|X_i - x|}\), …) donne exactement le même ensemble \(N_k(x)\) et donc le même \(\hat f\). La question du choix de la distance ne se pose vraiment qu’avec plusieurs variables explicatives, où la façon de combiner les écarts sur chaque variable change les voisins retenus.
6.1.2 Compromis biais-variance et choix de \(k\)
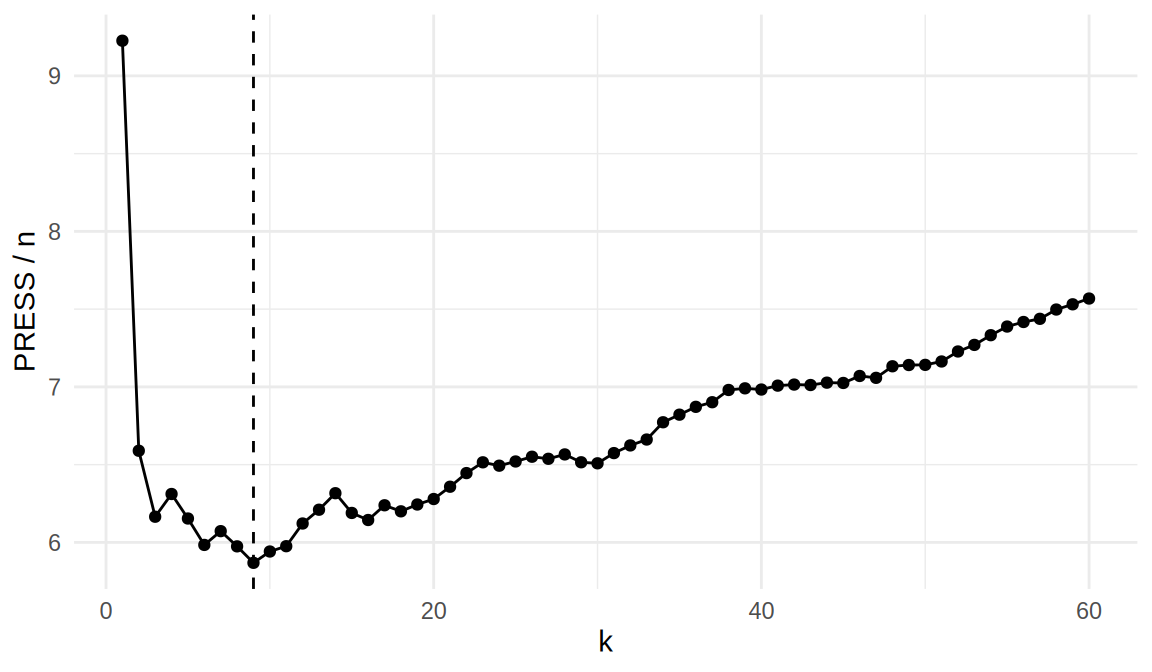
Le comportement de \(\hat f\) dépend fortement de \(k\). Lorsque \(X_i\) est proche de \(x\), un développement de Taylor donne \[E[\hat f(x)] \approx f(x) + f'(x)\,\frac{1}{k}\sum_{i\in N_k(x)}(E[X_i] - x) + \frac{1}{2k}f''(x)\sum_{i\in N_k(x)}(E[X_i] - x)^2.\] Si les \(X_i\) sont symétriquement distribués autour de \(x\), le terme du premier ordre s’annule et \[\mbox{biais}[\hat f(x)] \approx \frac{1}{2k}f''(x)\sum_{i\in N_k(x)}(E[X_i] - x)^2,\] quantité qui croît avec \(k\) (les voisins sont de plus en plus éloignés). D’autre part, si \(Var[\epsilon_i] = \sigma^2\), alors \[Var[\hat f(x)] = \frac{\sigma^2}{k},\] qui décroît avec \(k\). Il faut donc sélectionner le \(k\) qui minimise l’erreur quadratique moyenne \[\mbox{biais}^2[\hat f(x)] + Var[\hat f(x)].\] En pratique, on sélectionne \(k\) par validation croisée : lorsqu’on n’y fournit pas de jeu test, knn.reg calcule le critère PRESS\(= \sum_i (Y_i - \hat f_{-i}(X_i))^2\), qui correspond au LOOCV.
Figure 6.2: Erreur quadratique moyenne LOOCV de l’estimateur \(k\)NN en fonction de \(k\) sur les données arbres.
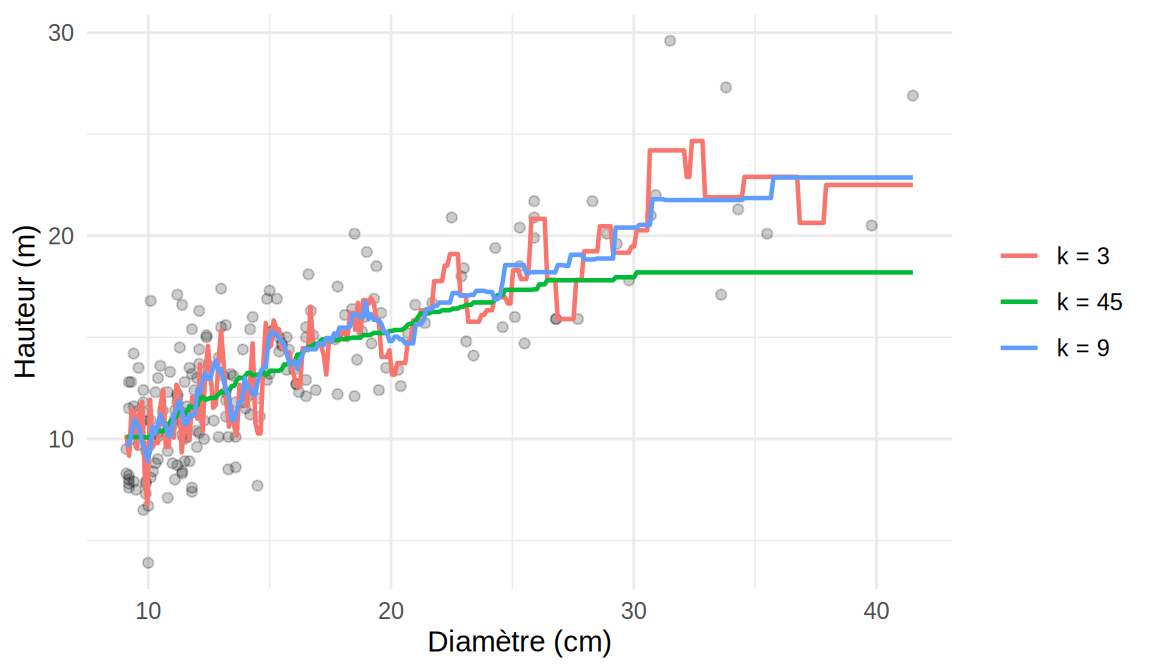
Le critère est très élevé pour \(k = 1\) (variance maximale), chute rapidement, atteint son minimum en \(k_{\min} = 9\) puis remonte lentement lorsque le biais prend le dessus. La Figure 6.3 compare l’estimateur pour trois valeurs de \(k\) : avec \(k = 3\), la courbe suit le bruit des observations ; avec \(k = 45\), elle est lisse mais écrase la croissance rapide des petits diamètres et sous-estime la hauteur des plus gros arbres, qui ont peu de voisins de leur taille.
Figure 6.3: Estimateur \(k\)NN de la hauteur en fonction du diamètre pour \(k = 3\), \(k = k_{\min}\) et \(k = 45\).
6.1.3 Plusieurs variables explicatives et distance de Mahalanobis
Avec deux variables explicatives, le modèle devient \(Y_i = f(X_{i1}, X_{i2}) + \epsilon_i\) et l’estimateur \(k\)NN est identique, seule la définition de la distance change. La distance euclidienne \[d_i(x) = \sqrt{(X_{i1} - x_1)^2 + (X_{i2} - x_2)^2}\] pose problème si les ordres de grandeur des variables diffèrent. Dans arbres, on pourrait vouloir prédire la hauteur à partir du diamètre et de l’âge (age_years, disponible pour 148 arbres) : le diamètre va de 9 à 41 cm alors que l’âge va de 15 à 153 ans, de sorte qu’une différence d’un an pèse autant qu’une différence d’un centimètre et que l’âge domine le calcul des voisins. On pondère alors par l’inverse de la matrice de variance-covariance empirique : \[d_i(x) = \sqrt{\begin{pmatrix} X_{i1}-x_1 \\ X_{i2}-x_2\end{pmatrix}^{\!\top} V^{-1}\begin{pmatrix} X_{i1}-x_1 \\ X_{i2}-x_2\end{pmatrix}},
\qquad V = \begin{pmatrix} s_1^2 & s_{12} \\ s_{12} & s_2^2\end{pmatrix}.\] C’est la distance de Mahalanobis. En notation vectorielle, avec \(\boldsymbol X_i = (X_{i1},\ldots,X_{ip})^\top\), \(\boldsymbol x = (x_1,\ldots,x_p)^\top\) et \(\boldsymbol\Sigma\) la matrice de variance-covariance des variables explicatives (estimée par \(V\)), elle s’écrit \[d_i(\boldsymbol x) = \sqrt{(\boldsymbol X_i - \boldsymbol x)^\top\boldsymbol\Sigma^{-1}(\boldsymbol X_i - \boldsymbol x)},\] ce qui la généralise directement à \(p\) variables continues. Lorsque \(\boldsymbol\Sigma = \boldsymbol I\), on retrouve la distance euclidienne ; lorsque \(\boldsymbol\Sigma\) est diagonale, on retrouve la distance euclidienne sur les variables standardisées. En pratique, on peut transformer les variables par \(V^{-1/2}\) (ou, plus simplement, les standardiser) avant d’appeler knn.reg.
Remarque — Distances au carré
En pratique, on omet la racine carrée et on travaille avec les distances au carré, \((X_i - x)^2\) ou \((\boldsymbol X_i - \boldsymbol x)^\top\boldsymbol\Sigma^{-1}(\boldsymbol X_i - \boldsymbol x)\) : la racine étant strictement croissante, l’ordre des observations, donc \(N_k(x)\) et \(\hat f\), est exactement le même, et on s’épargne un calcul inutile. C’est ce que font les implémentations comme knn.reg.
6.2 Estimateur de noyau (Nadaraya-Watson)
6.2.1 Des voisins aux noyaux
L’estimateur \(k\)NN peut s’écrire \[\hat f(x) = \frac{\sum_{i=1}^n \mathbf{1}_{\{i\in N_k(x)\}}Y_i}{\sum_{i=1}^n \mathbf{1}_{\{i\in N_k(x)\}}}.\] On peut définir le voisinage autrement : \(x\) et \(X_i\) sont voisins si \(|X_i - x| \leq h\), où \(h > 0\) est un paramètre de fenêtre jouant le même rôle que \(k\). On obtient \[\hat f(x) = \frac{\sum_{i=1}^n K\!\left(\frac{X_i - x}{h}\right)Y_i}{\sum_{i=1}^n K\!\left(\frac{X_i - x}{h}\right)} = \sum_{i=1}^n w_i(x)\,Y_i,\] où \(K(u) = \mathbf{1}_{\{|u|<1\}}\) est appelé noyau et \[w_i(x) = \frac{K\!\left(\frac{X_i - x}{h}\right)}{\sum_{j=1}^n K\!\left(\frac{X_j - x}{h}\right)}\] sont des poids positifs de somme 1.
Avec le noyau uniforme, la contribution d’une observation passe brusquement de \(1/A\) à 0 lorsque \(x\) sort de son voisinage : \(\hat f\) est discontinue. L’idée de l’estimateur de Nadaraya-Watson est d’utiliser des poids qui diminuent de façon continue au fur et à mesure que \(x\) s’éloigne de \(X_i\) : on prend par exemple le noyau gaussien\(K(u) = e^{-u^2/2}\), qui donne des poids continus et un estimateur \(\hat f_{NW}\) continu.
En R : locpoly(x=X, y=Y, degree=0, bandwidth=h) de la librairie KernSmooth.
6.2.2 Choix du paramètre de fenêtre \(h\)
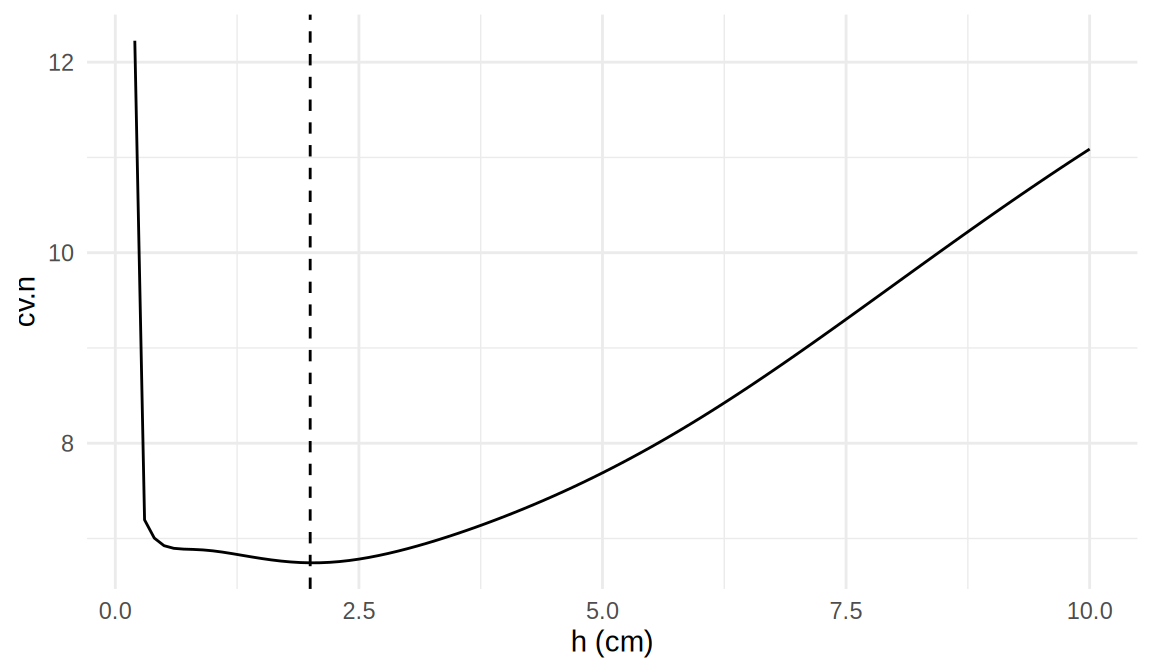
Comme pour \(k\)NN : un \(h\) trop petit produit une courbe très oscillante (variance élevée), un \(h\) trop grand écrase la structure (biais élevé). On choisit \(h\) par validation croisée. En excluant une observation à la fois, on montre que le critère s’écrit \[cv.n = \frac{1}{n}\sum_{i=1}^n\left(\frac{Y_i - \hat f(X_i)}{1 - w_i(X_i)}\right)^2.\]
La formule ci-dessus se programme directement : la matrice W contient les poids \(w_j(X_i)\), de sorte que W %*% H donne les valeurs ajustées et diag(W) les \(w_i(X_i)\).
Figure 6.4: Critère de validation croisée de l’estimateur de Nadaraya-Watson (noyau gaussien) en fonction de la fenêtre \(h\) sur les données arbres.
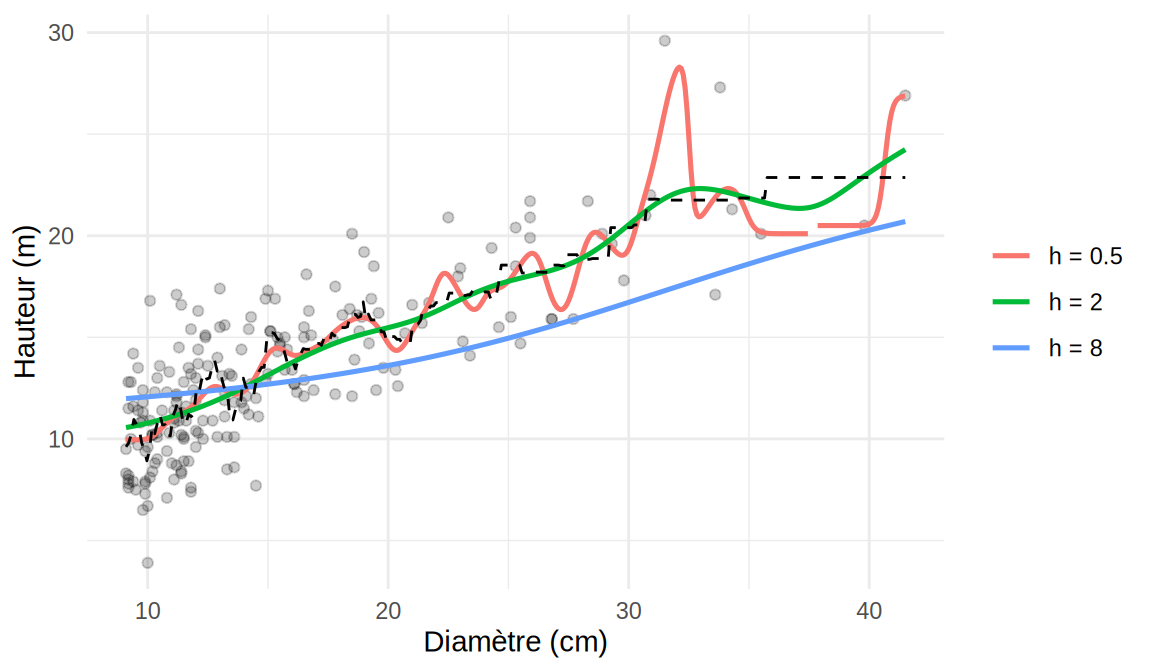
Avec le noyau gaussien, on obtient \(h_{\min} = 2\) cm. La Figure 6.5 montre que l’estimateur de Nadaraya-Watson avec \(h = h_{\min}\) est proche de l’estimateur \(k\)NN avec \(k = k_{\min}\), mais sans ses sauts : les deux méthodes captent la même relation concave.
Figure 6.5: Estimateur de Nadaraya-Watson pour \(h = 0{,}5\), \(h = h_{\min}\) et \(h = 8\) cm, et estimateur \(k\)NN avec \(k = k_{\min}\) (tirets).
Remarque — \(k\)NN et Nadaraya-Watson : quelle est la différence?
Les deux estimateurs reposent sur la même idée : pour estimer \(f(x)\), on fait une moyenne des \(Y_i\) des observations dont le \(X_i\) est proche de \(x\). Ils diffèrent par la façon de définir « proche » et de pondérer.
L’estimateur \(k\)NN fixe le nombre de voisins : il prend toujours les \(k\) observations les plus proches de \(x\), quelle que soit leur distance, et leur donne à chacune le même poids \(1/k\). La taille du voisinage s’adapte donc à la densité des données : il est étroit là où les observations sont nombreuses et large là où elles sont rares. En contrepartie, l’estimateur est une fonction en escalier : il saute chaque fois qu’une observation entre dans le voisinage ou en sort, et la variance \(\sigma^2/k\) est la même partout.
L’estimateur de Nadaraya-Watson fixe la largeur du voisinage par \(h\) : toutes les observations contribuent, avec un poids qui décroît continûment avec la distance \(|X_i - x|/h\). Le nombre effectif de voisins varie donc d’un \(x\) à l’autre : il est grand là où les données sont denses (variance faible) et petit là où elles sont rares (variance élevée, comme pour les gros arbres d’arbres). En contrepartie, l’estimateur est lisse, puisque les poids varient continûment avec \(x\).
Autrement dit, \(k\)NN adapte la fenêtre et garde la variance constante ; Nadaraya-Watson garde la fenêtre et laisse la variance varier. Les deux ont un paramètre de lissage (\(k\) ou \(h\)) que l’on choisit par validation croisée et, pour des valeurs comparables (un \(h\) tel que le voisinage contient environ \(k\) observations), ils donnent des courbes très semblables, comme le montre la Figure 6.5.
6.3 Régression non-paramétrique et classification
Dans arbres, la variable canopy_stratum donne la position de l’arbre dans le couvert : un arbre est dominant ou codominant s’il reçoit la lumière directement, intermédiaire ou opprimé s’il pousse sous le couvert des autres. Posons \(Y_i = 1\) si l’arbre \(i\) est dans la strate inférieure (intermédiaire ou opprimé), ce qui concerne 61 des 200 arbres, et \(Y_i = 0\) sinon. On veut prédire la strate à partir du diamètre \(X_i\). Le modèle est \(g(x) = P(Y = 1\mid X = x)\), qu’on estime par \(k\)NN : \[\hat g(x) = \frac{1}{k}\sum_{i\in N_k(x)}Y_i \in [0,1].\]
Pour choisir \(k\), deux critères de validation croisée :
Taux d’erreur test : on pose \(\hat Y_i = \mathbf{1}_{\{\hat g_{-i}(X_i) > u\}}\) (avec \(u = 1/2\) en pratique) et on minimise \[\frac{1}{n}\sum_{i=1}^n\mathbf{1}_{\{y_i\neq\hat y_i\}}.\]
Aire sous la courbe ROC : on choisit le \(k\) qui maximise l’AUC (voir le Section 2.5), critère qui ne dépend d’aucun seuil.
Exemple — Prédire la strate d’un arbre à partir de son diamètre
On calcule, pour chaque \(k\), les prédictions LOOCV \(\hat g_{-i}(X_i)\), puis le taux d’erreur pour trois seuils \(u\) et l’AUC. Cette dernière se calcule à partir des rangs des \(\hat g_{-i}(X_i)\) (statistique de Mann-Whitney), ce qui évite de tracer la courbe ROC pour chaque \(k\).
res <-rbind(data.frame(critere ="Taux d'erreur (u = 1/2)", k = ks, valeur =taux.erreur(0.5)),data.frame(critere ="AUC", k = ks, valeur = aucs))ggplot(res, aes(k, valeur)) +geom_line() +facet_wrap(~ critere, scales ="free_y") +labs(x ="k", y =NULL) +theme_minimal()
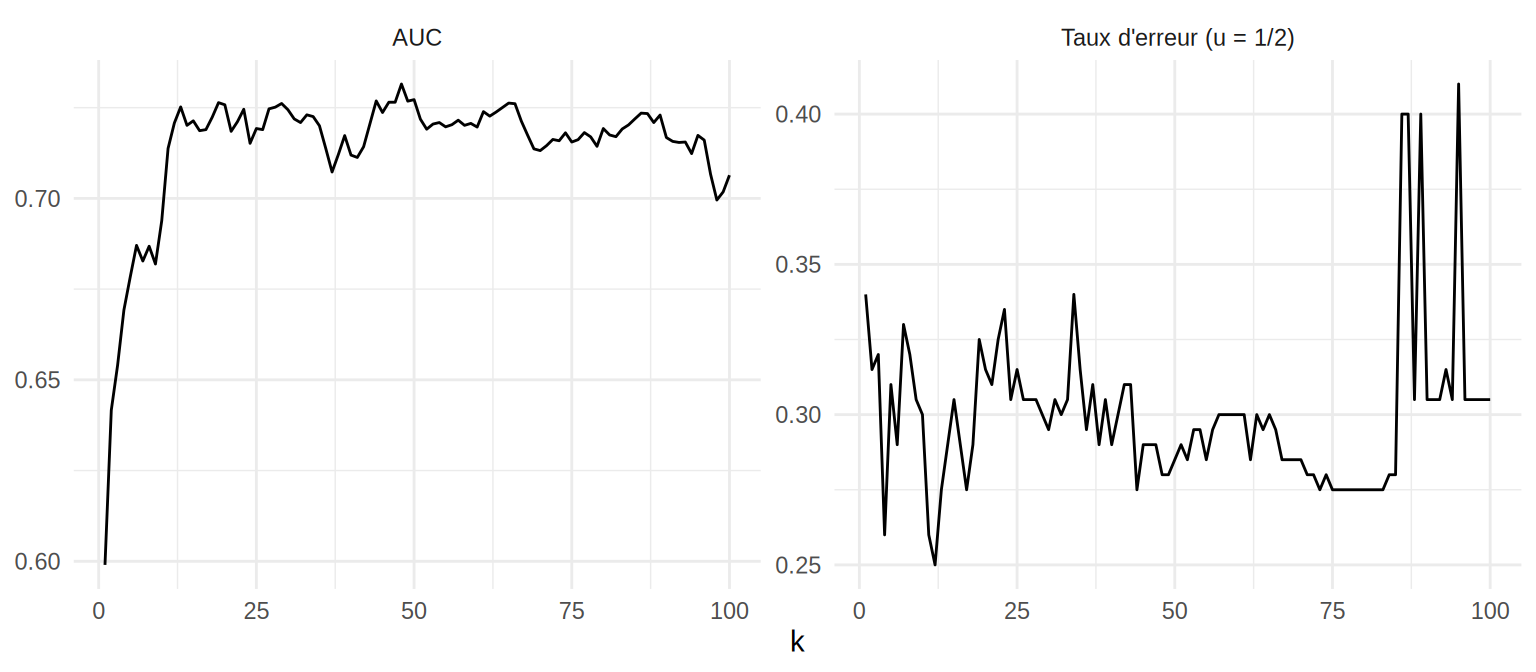
Figure 6.6: Taux d’erreur LOOCV (seuil \(u = 1/2\)) et AUC de l’estimateur \(k\)NN de \(P(\mbox{strate inférieure}\mid \mbox{diamètre})\) en fonction de \(k\).
Avec \(u = 1/2\), le taux d’erreur est minimal en \(k = 12\), mais la courbe est très irrégulière et le résultat dépend du seuil arbitraire \(u\) : avec \(u = 1/4\) on obtient \(k = 32\) et avec \(u = 3/4\), \(k = 9\). L’AUC varie plus régulièrement avec \(k\) : elle augmente rapidement jusqu’à \(k \approx 20\), puis forme un plateau autour de 0,72 jusqu’à \(k \approx 60\), avec un maximum en \(k = 48\). Le diamètre seul ne permet qu’une prédiction modeste de la strate (AUC \(\approx 0{,}73\)) : environ un arbre sur deux de moins de 12 cm est sous le couvert, contre moins d’un sur vingt au-delà de 20 cm, mais entre les deux, la strate dépend surtout des arbres voisins, que le jeu de données ne décrit pas.
Remarque — Ce qu’on cherche à faire ici
Rien n’a changé dans la méthode : \(Y\) est une variable binaire, mais \(f(x) = E[Y\mid X = x]\) reste une fonction de régression, et \(k\)NN l’estime comme avant par la moyenne des \(Y_i\) des \(k\) voisins de \(x\). Simplement, lorsque \(Y\) vaut 0 ou 1, cette moyenne est la proportion de voisins pour lesquels \(Y_i = 1\), et \(E[Y\mid X = x]\) est la probabilité \(P(Y = 1\mid X = x)\). On estime donc une probabilité, exactement comme en régression logistique, mais sans supposer que son logit est linéaire en \(x\) : la courbe \(\hat g\) prend la forme que les données lui donnent. C’est l’analogue non-paramétrique du Chapitre 2.
Une fois \(\hat g\) obtenue, on peut s’en servir de deux façons : pour classer un nouvel arbre dans la strate inférieure si \(\hat g(x) > u\), ou pour ordonner les arbres selon leur probabilité estimée sans fixer de seuil. Le choix de \(k\) joue le même rôle que dans tout le chapitre, celui du paramètre de lissage, et on le fait encore par validation croisée. Ce qui change, c’est le critère : l’erreur quadratique n’est plus naturelle pour une réponse binaire, et on la remplace par une mesure adaptée à l’usage qu’on fera de \(\hat g\), le taux de mauvaise classification si l’objectif est de classer, l’AUC si l’objectif est d’ordonner les individus du plus probable au moins probable, par exemple pour en retenir les meilleurs candidats sans fixer de seuil à l’avance. L’exemple montre que le premier critère est instable et dépend d’un seuil arbitraire, alors que le second ne dépend d’aucun seuil et varie plus régulièrement avec \(k\).