Les chapitres précédents ont présenté deux familles d’outils de sélection de variables :
les tests pour modèles emboîtés (test \(F\) en régression linéaire, différence de déviances pour les GLM) ;
les critères d’information\(AIC\) et \(BIC\), combinés aux procédures pas à pas forward, backward et stepwise, pour les modèles non emboîtés ou lorsque le nombre de sous-modèles (\(2^p\)) est trop grand pour une recherche exhaustive.
La régression régularisée, présentée ci-dessous, offre une troisième approche qui effectue simultanément l’estimation et (pour le lasso) la sélection de variables.
5.2 Régression régularisée
Considérons le modèle de régression \[Y_i = \beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip} + \epsilon_i, \qquad \epsilon_i \sim \mathcal{N}(0,\sigma^2).\] L’estimateur des moindres carrés \(\hat\beta\) est sans biais et de variance minimale parmi les estimateurs sans biais. Cependant, rien ne garantit qu’il possède la plus petite erreur quadratique moyenne : \[E\left[(\beta_j - \hat\beta_j)^2\right] = \mbox{biais}(\hat\beta_j)^2 + Var(\hat\beta_j).\]
La régression régularisée impose une pénalité au critère des moindres carrés : on minimise \[l_\lambda(\beta) = l(\beta) + \lambda\, g(\beta_1,\ldots,\beta_p),\] où \(g\) est une fonction de pénalité connue et \(\lambda \geq 0\) est le coefficient de pénalité. La pénalité réduit la variance des estimateurs au prix d’un biais ; avec un choix judicieux de \(g\) et de \(\lambda\), on diminue l’erreur quadratique moyenne et on obtient des prédictions plus précises. C’est le compromis biais-variance.
Remarque
Remarque.
L’ordonnée à l’origine \(\beta_0\) n’est pas pénalisée. Par ailleurs, les variables explicatives sont généralement standardisées avant l’ajustement, car la pénalité n’est pas invariante à l’échelle des variables.
Exemple — Jeu de données Hitters
Données sur les joueurs des ligues majeures de baseball, tirées de la librairie ISLR(james2021?). Elles proviennent de la collection StatLib de l’université Carnegie Mellon et ont été préparées pour une séance d’affiches de la section Statistical Graphics de l’American Statistical Association en 1988. Le jeu compte 322 joueurs et 20 variables. La réponse est Salary, le salaire annuel au jour d’ouverture de la saison 1987, en milliers de dollars. Les 19 variables explicatives se répartissent en quatre groupes :
les statistiques offensives de la saison 1986 : présences au bâton (AtBat), coups sûrs (Hits), circuits (HmRun), points marqués (Runs), points produits (RBI) et buts sur balles (Walks) ;
les statistiques offensives cumulées sur la carrière : CAtBat, CHits, CHmRun, CRuns, CRBI et CWalks, ainsi que le nombre d’années dans les ligues majeures (Years) ;
les statistiques défensives de la saison 1986 : retraits (PutOuts), assistances (Assists) et erreurs (Errors) ;
trois variables catégorielles à deux modalités : la ligue à la fin de 1986 (League, A pour américaine ou N pour nationale), la division à la fin de 1986 (Division, E pour est ou W pour ouest) et la ligue au début de 1987 (NewLeague).
Le salaire est manquant pour 59 joueurs ; on retire ces joueurs, ce qui laisse \(n = 263\) observations. La fonction model.matrix transforme les trois variables catégorielles en indicatrices (LeagueN, DivisionW et NewLeagueN), d’où une matrice \(X\) à 19 colonnes.
Deux caractéristiques de ces données sont à retenir pour la suite. D’abord, les variables de carrière sont très fortement corrélées entre elles, puisqu’elles croissent toutes avec l’ancienneté du joueur. Cette colinéarité gonfle la variance des estimateurs des moindres carrés, et c’est précisément la situation où la régularisation est utile. Ensuite, la distribution du salaire est fortement asymétrique à droite : la moyenne dépasse nettement la médiane.
Remarque
Remarque.
À cause de cette asymétrie, on modélise souvent \(\log(\texttt{Salary})\) plutôt que Salary. On conserve ici le salaire sur son échelle d’origine, comme dans (james2021?), pour que les erreurs test rapportées dans les exemples soient comparables à celles de cet ouvrage.
5.2.1 Régression ridge
La régression ridge minimise \[l^{(R)}_\lambda(\beta) = \sum_{i=1}^n\left\{Y_i - (\beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip})\right\}^2 + \lambda\sum_{j=1}^p\beta_j^2.\] En écriture matricielle, \(l^{(R)}_\lambda(\beta) = (Y - X\beta)^\top(Y-X\beta) + \lambda\,\beta^\top\tilde I_p\,\beta\), où \(\tilde I_p\) est diagonale de taille \(p+1\) avec un 0 en première position (pas de pénalité sur \(\beta_0\)) et des 1 ailleurs. La solution est explicite : \[\boxed{\hat\beta^{(R)}_\lambda = (X^\top X + \lambda\tilde I_p)^{-1}X^\top Y}\] et on en déduit
\[
\begin{aligned}
E[\hat\beta^{(R)}_\lambda] &= (X^\top X + \lambda\tilde I_p)^{-1}X^\top X\beta \neq \beta,\\
Var[\hat\beta^{(R)}_\lambda] &= \sigma^2(X^\top X + \lambda\tilde I_p)^{-1}X^\top X(X^\top X + \lambda\tilde I_p)^{-1}.
\end{aligned}
\]
L’estimateur est donc biaisé, sauf si \(\lambda = 0\). Lorsque \(\lambda = 0\), \(\hat\beta^{(R)}_\lambda = \hat\beta\) ; lorsque \(\lambda\to\infty\), tous les \(\hat\beta^{(R)}_{j,\lambda}\) (\(j\geq1\)) tendent vers 0 et l’ordonnée à l’origine tend vers \(\bar Y\). On parle d’un phénomène de rétrécissement (shrinkage).
On ajuste la régression ridge avec glmnet(x, y, alpha = 0) sur une grille de 100 valeurs de \(\lambda\) allant de \(10^{10}\) à \(10^{-2}\). La fonction glmnet standardise les variables explicatives avant l’ajustement (argument standardize = TRUE par défaut), mais retourne les coefficients sur l’échelle d’origine des variables.
On retient \(\lambda = e^{5{,}44}\), valeur choisie par validation croisée ; cette méthode est présentée plus bas, à la Section 5.2.5. Cette valeur s’entend au sens de glmnet (voir la remarque qui suit l’exemple).
reg.mc <-lm(Salary ~ ., data = Hitters)coef.mc <-coef(reg.mc)[-1]coef.ridge <-as.vector(coef(reg.ridge, s = lambda.ridge))[-1]knitr::kable(data.frame(Variable =colnames(x),"Moindres carrés"= coef.mc,"Ridge"= coef.ridge,check.names =FALSE),digits =2, row.names =FALSE)
Variable
Moindres carrés
Ridge
AtBat
-1.98
0.04
Hits
7.50
0.98
HmRun
4.33
0.24
Runs
-2.38
1.10
RBI
-1.04
0.87
Walks
6.23
1.76
Years
-3.49
0.43
CAtBat
-0.17
0.01
CHits
0.13
0.06
CHmRun
-0.17
0.44
CRuns
1.45
0.13
CRBI
0.81
0.13
CWalks
-0.81
0.04
LeagueN
62.60
26.12
DivisionW
-116.85
-89.21
PutOuts
0.28
0.19
Assists
0.37
0.04
Errors
-3.36
-1.72
NewLeagueN
-24.76
7.76
La somme des carrés des coefficients (sans l’ordonnée à l’origine) vaut 8 710 pour ridge, contre 18 337 pour les moindres carrés. Aucun coefficient n’est exactement nul : ridge rétrécit les coefficients sans effectuer de sélection.
Le rétrécissement porte sur le vecteur des coefficients standardisés dans son ensemble, et non sur chaque coefficient séparément. En présence de variables corrélées, comme les variables de carrière, un coefficient individuel peut donc augmenter en valeur absolue, voire changer de signe : ridge répartit l’effet entre les variables corrélées plutôt que de laisser des coefficients de signes opposés se compenser.
Pour évaluer la précision de prédiction, on sépare les données en deux moitiés : une pour l’entraînement et une pour le test. Pour que la comparaison soit honnête, \(\lambda\) est choisi par validation croisée sur l’échantillon d’entraînement seulement : les observations test ne doivent servir ni à estimer les coefficients, ni à choisir \(\lambda\).
set.seed(1)entrainement <-sample(nrow(x), nrow(x) /2)test <--entrainementy.test <- y[test]# Modèle nul : on prédit par la moyenne de l'échantillon d'entraînementerr.nul <-mean((mean(y[entrainement]) - y.test)^2)# Moindres carrésmc.ent <-lm(y[entrainement] ~ x[entrainement, ])err.mc <-mean((cbind(1, x[test, ]) %*%coef(mc.ent) - y.test)^2)# Ridge, lambda choisi par validation croisée sur l'entraînement (voir plus bas)set.seed(4300)cv.ridge.ent <-cv.glmnet(x[entrainement, ], y[entrainement],alpha =0, lambda = grille.lambda)ridge.ent <-glmnet(x[entrainement, ], y[entrainement],alpha =0, lambda = grille.lambda)err.ridge <-mean((predict(ridge.ent, s = cv.ridge.ent$lambda.min,newx = x[test, ]) - y.test)^2)c("Modèle nul"= err.nul, "Moindres carrés"= err.mc, "Ridge"= err.ridge)
Sur l’échantillon d’entraînement, la validation croisée retient \(\lambda = e^{5{,}72}\). L’erreur quadratique moyenne test vaut alors 168 593 pour les moindres carrés et 140 082 pour ridge, soit une diminution de 16,9 %. À titre de référence, le modèle nul, qui ignore toutes les variables explicatives, donne 224 670.
5.2.2 Régression lasso
La régression lasso minimise \[l^{(L)}_\lambda(\beta) = \sum_{i=1}^n\left\{Y_i - (\beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip})\right\}^2 + \lambda\sum_{j=1}^p|\beta_j|.\] Il n’existe pas d’expression explicite pour \(\hat\beta^{(L)}_\lambda\), mais des algorithmes d’optimisation efficaces existent (en R : glmnet(x, y, alpha=1)).
La caractéristique clé du lasso : pour les grandes valeurs de \(\lambda\), certains coefficients \(\hat\beta^{(L)}_{j,\lambda}\) deviennent identiquement égaux à 0. Le lasso effectue donc une sélection de variables automatique, intuitive et naturelle. Comme pour ridge : quand \(\lambda\) croît, le biais croît et la variance diminue.
On ajuste le lasso avec glmnet(x, y, alpha = 1) sur la même grille, avec \(\lambda = e^{0{,}98}\), là aussi choisi par validation croisée (Section 5.2.5).
reg.lasso <-glmnet(x, y, alpha =1, lambda = grille.lambda)coef.lasso <-as.vector(coef(reg.lasso, s = lambda.lasso))[-1]names(coef.lasso) <-colnames(x)round(coef.lasso[coef.lasso !=0], 2)
Le lasso annule 6 coefficients, ceux de HmRun, Runs, RBI, CAtBat, CHits et NewLeagueN. Le modèle retenu ne contient plus que 13 variables. Parmi des variables fortement corrélées, comme les statistiques de carrière, le lasso tend à en retenir une seule et à annuler les autres, alors que ridge répartit l’effet entre elles.
On calcule l’erreur test sur la même partition que pour ridge, en choisissant encore \(\lambda\) par validation croisée sur l’échantillon d’entraînement.
L’erreur test du lasso vaut 144 218, contre 140 082 pour ridge et 168 593 pour les moindres carrés.
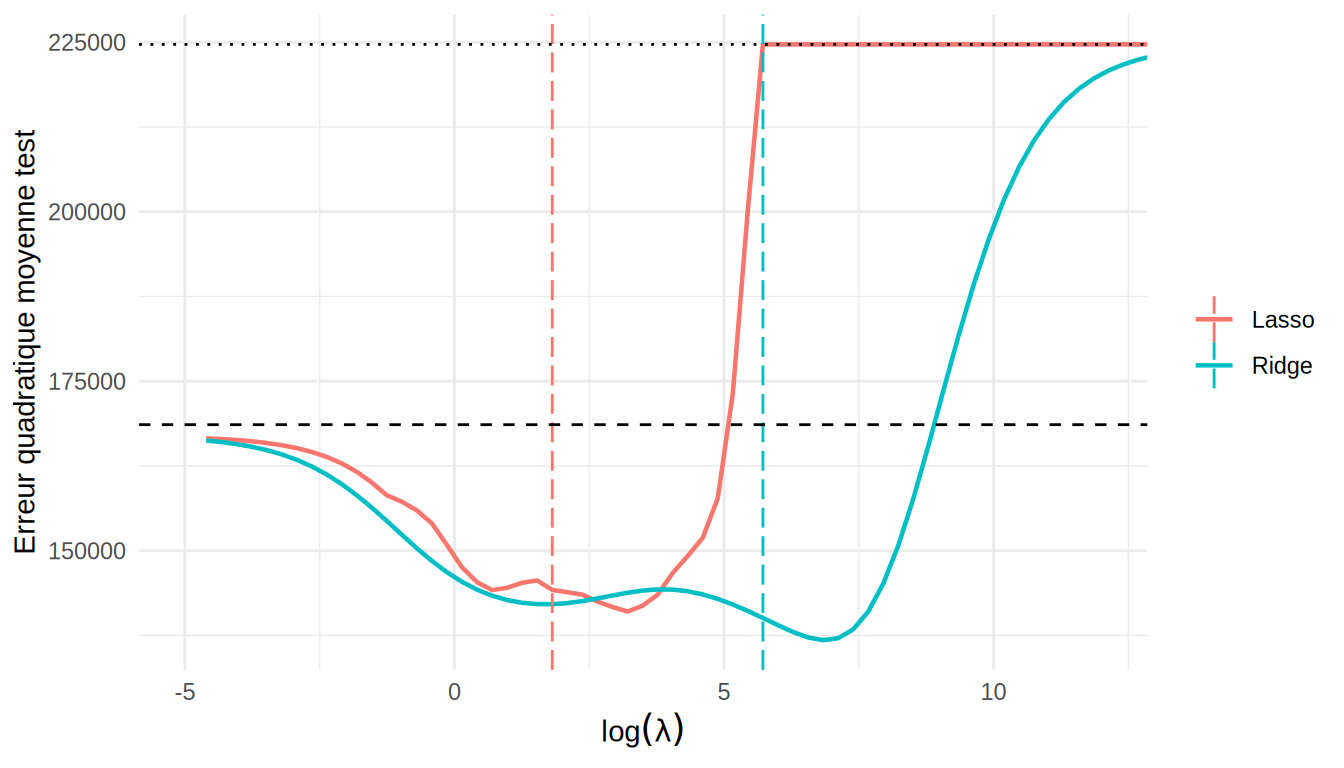
La Figure 5.1 montre l’erreur test en fonction de \(\log\lambda\) pour les deux méthodes. Lorsque \(\lambda\) est petit, les deux estimateurs sont proches des moindres carrés : la variance domine. Lorsque \(\lambda\) est grand, tous les coefficients sont nuls ou presque, et l’erreur rejoint celle du modèle nul : le biais domine. Entre les deux, la courbe en U illustre le compromis biais-variance. Le lasso rejoint le modèle nul pour une valeur finie de \(\lambda\), où tous ses coefficients s’annulent, alors que ridge ne s’en approche qu’asymptotiquement.
Figure 5.1: Erreur quadratique moyenne test en fonction de \(\log\lambda\) pour ridge et le lasso sur les données Hitters. Les lignes verticales indiquent les valeurs de \(\lambda\) choisies par validation croisée sur l’échantillon d’entraînement ; les lignes horizontales donnent l’erreur des moindres carrés (tirets) et celle du modèle nul (pointillés).
5.2.3 Interprétation géométrique
Propriété — Formulation sous contrainte
Pour chaque \(\lambda \geq 0\), il existe une valeur \(s \geq 0\) (qui dépend des données) telle que l’estimateur ridge est solution de
et l’estimateur lasso est solution du même problème sous la contrainte
\[
\sum_{j=1}^p|\beta_j| \leq s.
\]
Une grande valeur de \(\lambda\) correspond à une petite valeur de \(s\).
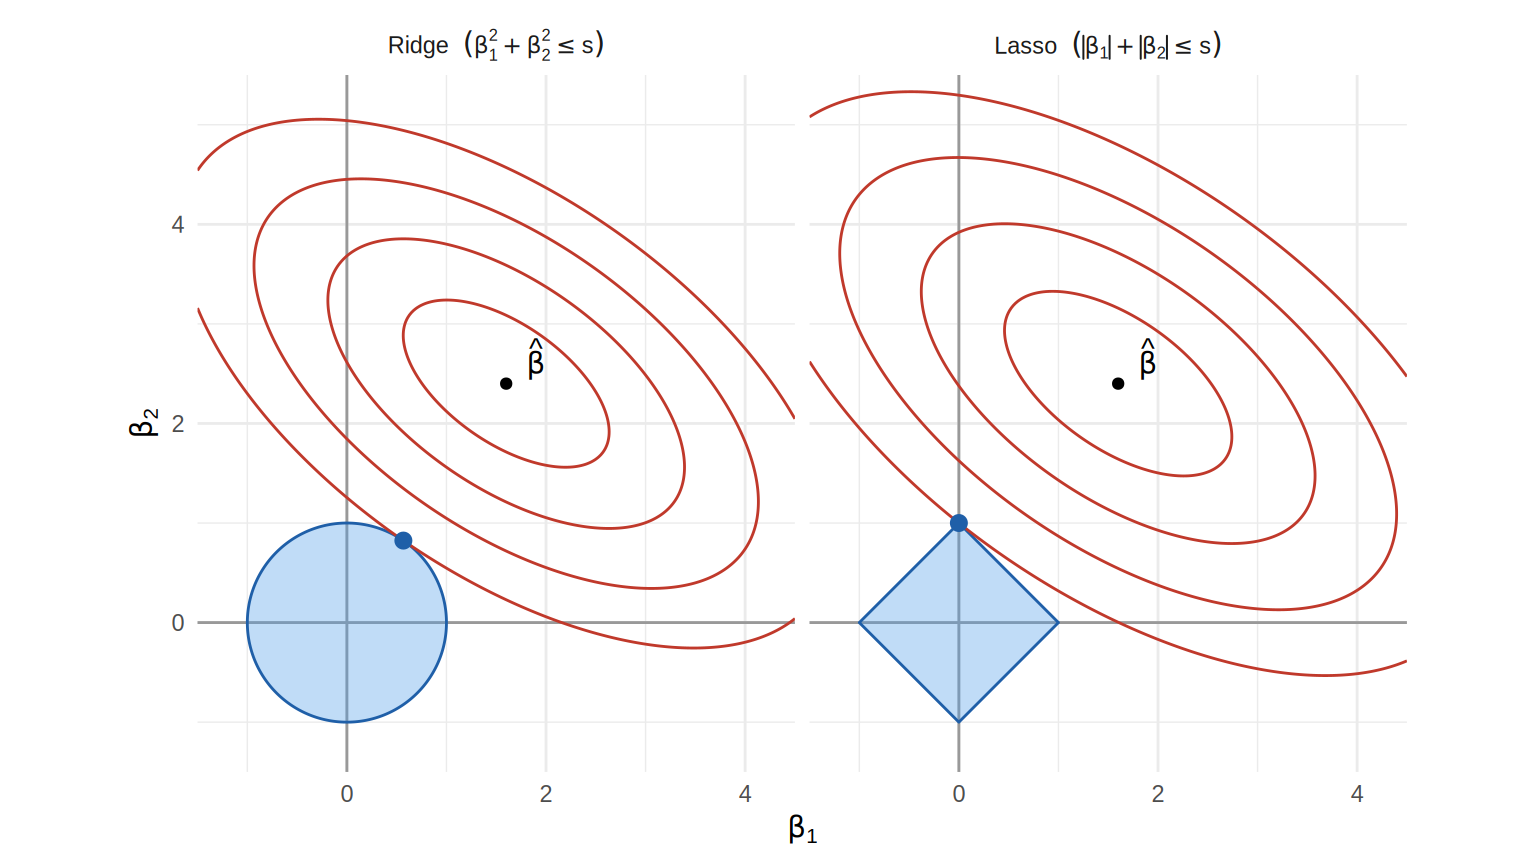
Lorsque les variables explicatives sont centrées, la somme des carrés résiduels s’écrit, à une constante près, \((\beta - \hat\beta)^\top X^\top X(\beta - \hat\beta)\) : ses courbes de niveau sont des ellipses centrées en l’estimateur des moindres carrés \(\hat\beta\). Avec \(p = 2\), on peut donc représenter le problème dans le plan \((\beta_1, \beta_2)\) (Figure 5.2). La région admissible est un disque pour ridge et un losange pour le lasso, et la solution est le point où l’ellipse de plus petit niveau touche la région admissible.
Le losange possède des coins situés sur les axes. Lorsque le contact se fait en un coin, l’un des coefficients est exactement nul. Le disque n’a pas de coin : le contact se fait presque toujours hors des axes, si bien que ridge rétrécit les coefficients sans jamais les annuler. En dimension \(p\), la région du lasso est un polyèdre dont les sommets et les arêtes se trouvent sur des sous-espaces de coordonnées, ce qui explique que plusieurs coefficients puissent être annulés simultanément.
Figure 5.2: Courbes de niveau de la somme des carrés résiduels (ellipses centrées en \(\hat\beta\)) et régions admissibles de ridge (disque) et du lasso (losange). Le point bleu est l’estimateur régularisé : le lasso atteint un coin du losange, où \(\hat\beta_1 = 0\).
5.2.4 Trajectoires des coefficients
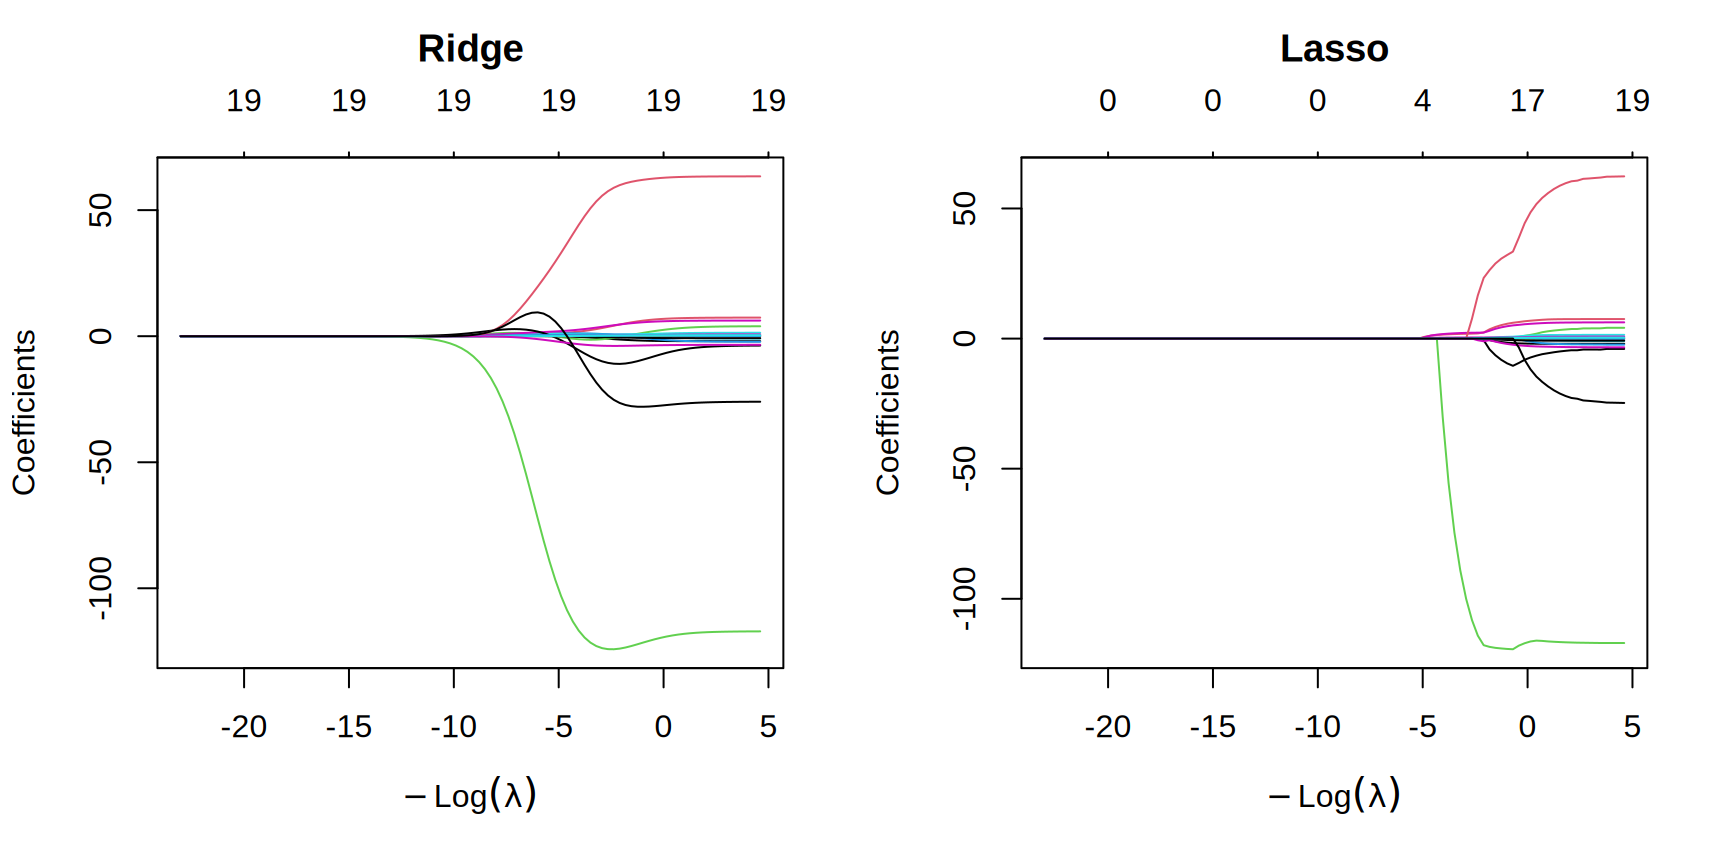
Une autre représentation classique consiste à tracer les estimations \(\hat\beta_{j,\lambda}\) en fonction de \(\log\lambda\) (Figure 5.3). Pour ridge, toutes les trajectoires tendent doucement vers 0 sans jamais l’atteindre : l’axe du haut, qui indique le nombre de coefficients non nuls, reste à 19. Pour le lasso, les trajectoires atteignent 0 l’une après l’autre à mesure que \(\lambda\) augmente, et le nombre de variables retenues diminue.
library(glmnet)grille.lambda <-10^seq(10, -2, length.out =100)reg.ridge <-glmnet(x, y, alpha =0, lambda = grille.lambda)reg.lasso <-glmnet(x, y, alpha =1, lambda = grille.lambda)par(mfrow =c(1, 2))plot(reg.ridge, xvar ="lambda")title("Ridge", line =2.5)plot(reg.lasso, xvar ="lambda")title("Lasso", line =2.5)
Figure 5.3: Trajectoires des coefficients estimés en fonction de \(\log\lambda\) pour les données Hitters. Chaque courbe correspond à une variable explicative ; l’axe du haut donne le nombre de coefficients non nuls.
5.2.5 Sélection du paramètre \(\lambda\)
La méthode la plus intuitive est basée sur le taux d’erreur test, estimé par validation croisée pour une grille de valeurs de \(\lambda\) ; on choisit la valeur qui minimise le taux d’erreur test. C’est ainsi qu’ont été choisies les valeurs de \(\lambda\) utilisées dans les exemples précédents. En R, avec les objets x, y et grille.lambda définis plus haut :
set.seed(4300)cv.ridge <-cv.glmnet(x, y, alpha =0, lambda = grille.lambda)set.seed(4300)cv.lasso <-cv.glmnet(x, y, alpha =1, lambda = grille.lambda)c(Ridge = cv.ridge$lambda.min, Lasso = cv.lasso$lambda.min)
     Ridge      Lasso
231.012970   2.656088
Sur les données Hitters, on obtient \(\lambda = e^{5{,}44}\) pour ridge et \(\lambda = e^{0{,}98}\) pour le lasso.
5.3 Régularisation en régression logistique
Les idées précédentes s’étendent directement aux GLM. En régression logistique, la régularisation est utile pour deux raisons. D’abord, comme en régression linéaire, elle réduit la variance des estimateurs lorsque le nombre de variables explicatives est grand par rapport à l’information disponible (en régression logistique, c’est surtout le nombre d’événements du groupe le plus rare qui compte). Ensuite, elle règle le problème de la séparation : alors que l’estimateur du maximum de vraisemblance n’existe pas en présence de séparation, l’estimateur régularisé existe toujours.
5.3.1 Log-vraisemblance pénalisée
Le critère des moindres carrés est remplacé par moins deux fois la log-vraisemblance. On minimise
avec \(g(\beta_1,\ldots,\beta_p) = \sum_{j=1}^p\beta_j^2\) pour ridge et \(g(\beta_1,\ldots,\beta_p) = \sum_{j=1}^p|\beta_j|\) pour le lasso. Comme la déviance vaut \(D(\boldsymbol\beta) = 2\{\ell_{\text{sat}} - \ell(\boldsymbol\beta)\}\), où \(\ell_{\text{sat}}\) ne dépend pas de \(\boldsymbol\beta\), cela revient à minimiser la déviance pénalisée \(D(\boldsymbol\beta) + \lambda\, g(\beta_1,\ldots,\beta_p)\).
Remarque
Remarque.
En régression linéaire normale, \(-2\,\ell(\boldsymbol\beta) = \sigma^{-2}\sum_{i=1}^n(Y_i - \boldsymbol x_i^\top\boldsymbol\beta)^2 + \text{constante}\). Le critère ci-dessus généralise donc exactement celui de la section précédente, la constante \(\sigma^2\) étant absorbée dans \(\lambda\).
Le cas du lien logit — Log-vraisemblance pénalisée
Avec le lien logit et \(\eta_i = \beta_0 + \beta_1X_{i1} + \cdots + \beta_pX_{ip}\), on minimise
où le terme \(\log\binom{m_i}{y_i}\), qui ne dépend pas de \(\boldsymbol\beta\), a été omis. Pour des données individuelles, \(m_i = 1\).
5.3.2 Estimation
Contrairement au cas linéaire, l’estimateur ridge n’a pas de forme explicite. L’algorithme IRLS s’adapte toutefois directement.
Propriété — IRLS pénalisé (ridge)
Soit \(\boldsymbol\beta^{(t)}\) l’estimation courante, \(\pi_i^{(t)}\) les probabilités correspondantes, \(\boldsymbol W^{(t)} = \text{diag}\left\{m_i\pi_i^{(t)}(1-\pi_i^{(t)})\right\}\) et \(\boldsymbol z^{(t)} = \boldsymbol X\boldsymbol\beta^{(t)} + (\boldsymbol W^{(t)})^{-1}(\boldsymbol y - \boldsymbol\mu^{(t)})\) la réponse de travail. Une itération de Newton-Raphson appliquée à \(l^{(R)}_\lambda\) donne
C’est la formule de l’estimateur ridge linéaire, appliquée à la réponse de travail \(\boldsymbol z^{(t)}\) avec les poids \(\boldsymbol W^{(t)}\).
Pour le lasso, la pénalité n’est pas dérivable en 0 et l’itération de Newton ne s’applique pas telle quelle. La fonction glmnet remplace, à chaque itération, \(-2\,\ell\) par son approximation quadratique (la même somme de carrés pondérés que dans IRLS), puis minimise le problème lasso pondéré qui en résulte par descente de coordonnées.
Propriété — Existence sous séparation
Supposons que les réponses ne soient pas toutes égales. Pour tout \(\lambda > 0\), le critère ridge \(l^{(R)}_\lambda\) possède un unique minimum fini, et le critère lasso \(l^{(L)}_\lambda\) possède au moins un minimum fini, même en présence de séparation complète ou quasi-complète.
L’argument est simple : \(-2\,\ell(\boldsymbol\beta) \geq 0\), donc la pénalité empêche \(\beta_1,\ldots,\beta_p\) de tendre vers l’infini, et \(-2\,\ell\) tend vers l’infini lorsque \(|\beta_0|\to\infty\) avec les autres coefficients bornés, puisque les deux valeurs de la réponse sont observées. Pour ridge, la matrice \(\boldsymbol X^\top\boldsymbol W\boldsymbol X + \lambda\tilde I_p\) est de plus définie positive, ce qui assure l’unicité.
Remarque
Remarque (inférence).
Les estimateurs régularisés sont biaisés, et la sélection effectuée par le lasso rend invalides les erreurs types, valeur-p et intervalles de confiance usuels calculés sur le modèle retenu. C’est pourquoi glmnet ne fournit pas d’erreurs types. La régularisation est d’abord un outil de prédiction et de sélection ; l’inférence après sélection demande des méthodes spécifiques qui dépassent le cadre de ce cours.
Remarque
Remarque (échelle de \(\lambda\) dans glmnet).
Pour family = "binomial", glmnet minimise \(-\frac{1}{n}\ell(\boldsymbol\beta) + \lambda\left\{\frac{1-\alpha}{2}\sum_j\beta_j^2 + \alpha\sum_j|\beta_j|\right\}\). Les valeurs de \(\lambda\) rapportées par glmnet ne sont donc pas sur la même échelle que celles du critère \(l_\lambda\) défini plus haut ; seul l’ordre des valeurs compte pour l’interprétation.
5.3.3 Choix de \(\lambda\)
Comme en régression linéaire, \(\lambda\) se choisit par validation croisée, mais avec une fonction de perte adaptée à une réponse binaire : la déviance binomiale (type.measure = "deviance", valeur par défaut), le taux de mauvaise classification ("class") ou l’aire sous la courbe ROC ("auc"). La fonction cv.glmnet retourne deux valeurs :
lambda.min, qui minimise l’erreur de validation croisée ;
lambda.1se, la plus grande valeur de \(\lambda\) dont l’erreur est à moins d’une erreur type de ce minimum. Elle donne un modèle plus parcimonieux dont la performance n’est pas significativement moins bonne.
On ajuste le modèle avec toutes les interactions entre la classe, le sexe et le groupe d’âge. Ce modèle est pratiquement saturé, et deux cellules ne comptent aucun survivant : les garçons de deuxième classe (0 sur 11) et les filles de troisième classe (0 sur 48). Il y a donc séparation quasi-complète, et le maximum de vraisemblance diverge. La cellule « première classe, homme, enfant » est vide, d’où un coefficient non estimable (NA).
niveaux.classe <-c("Première", "Deuxième", "Troisième")empress <-read.csv("Jeux de données/empress_individus.csv")empress$classe <-factor(empress$classe, levels = niveaux.classe)empress.agr <-read.csv("Jeux de données/empress_agrege.csv")empress.agr$classe <-factor(empress.agr$classe, levels = niveaux.classe)m.sature <-glm(survecu ~ classe * sexe * groupe_age,data = empress, family = binomial)round(summary(m.sature)$coefficients, 2)
Les coefficients associés aux cellules sans survivant sont très grands en valeur absolue, avec des erreurs types démesurées. On ajuste maintenant les versions ridge et lasso, en choisissant \(\lambda\) par validation croisée à 10 plis sur la déviance.
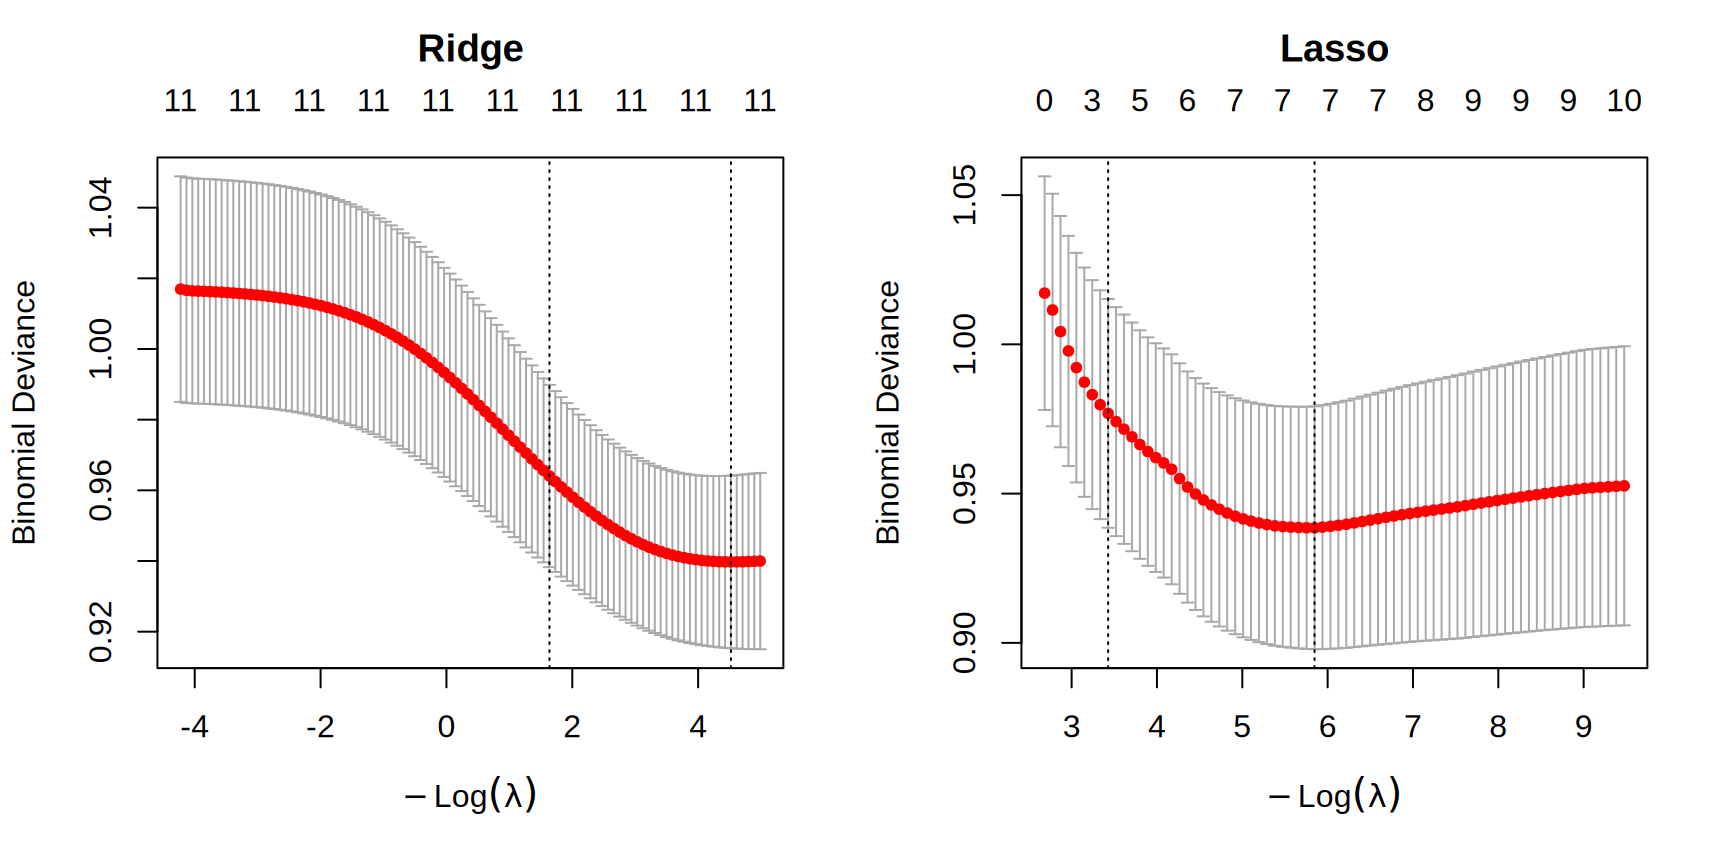
x.emp <-model.matrix(survecu ~ classe * sexe * groupe_age, empress)[, -1]y.emp <- empress$survecuset.seed(4300)cv.ridge.emp <-cv.glmnet(x.emp, y.emp, family ="binomial", alpha =0)cv.lasso.emp <-cv.glmnet(x.emp, y.emp, family ="binomial", alpha =1)par(mfrow =c(1, 2))plot(cv.ridge.emp)title("Ridge", line =2.5)plot(cv.lasso.emp)title("Lasso", line =2.5)
Figure 5.4: Déviance binomiale estimée par validation croisée en fonction de \(\log\lambda\) pour ridge (gauche) et le lasso (droite). Les lignes pointillées indiquent lambda.min et lambda.1se.
Les coefficients régularisés restent finis :
coefs <-cbind(MV =coef(m.sature),Ridge =as.vector(coef(cv.ridge.emp, s ="lambda.min")),Lasso =as.vector(coef(cv.lasso.emp, s ="lambda.min")))round(coefs, 3)
Le maximum de vraisemblance reproduit exactement les proportions observées, y compris les probabilités nulles des deux cellules sans survivant : il prédit qu’aucun passager de ces cellules ne peut survivre, ce qui est peu plausible compte tenu des effectifs. Les estimateurs régularisés rapprochent les probabilités des cellules peu informatives de celles des cellules voisines et donnent des probabilités petites, mais strictement positives.