Chapitre 1 : présentation · imprimable Population, échantillon et variable · L’histogramme · La moyenne et l’écart-type · Les quantiles · Le diagramme en boîte · Diagrammes en pointes de tarte et en bâtons · Les données bivariées
Deux types de méthodes statistiques seront étudiées dans ce cours : les méthodes de la statistique descriptive et les méthodes de la statistique inférentielle.
La statistique descriptive. La statistique descriptive, c’est l’art de résumer un ensemble de données de façon à mettre en évidence l’information qu’elles contiennent. Le but du présent chapitre est de présenter les principaux concepts et les principales méthodes de la statistique descriptive.
La statistique inférentielle. La statistique inférentielle, c’est l’art de tirer des conclusions au sujet d’une population à partir d’un échantillon provenant de cette population. La statistique inférentielle fait appel à la théorie des probabilités. Un bref survol de la théorie des probabilités sera présenté au chapitre 2. Les chapitres 3 à 7 porteront sur les principales méthodes de la statistique inférentielle.
1.2 Population, échantillon et variable statistique
Voici un exemple élémentaire pour illustrer les concepts de population, d’échantillon et de variable statistique.
Exemple 1. Un chercheur étudie une certaine espèce de serpents. Il s’intéresse en particulier au poids des serpents à la naissance. Il obtient les poids de 147 serpents nouveau-nés. Ces poids sont mesurés en grammes. Le tableau 1.1 donne la liste de ces 147 poids.
Dans cet exemple, la population qui nous intéresse est l’ensemble de tous les serpents de l’espèce sous considération. L’échantillon est l’ensemble des 147 serpents obtenus par le chercheur. La variable statistique qui nous intéresse est la variable « poids à la naissance ». Parfois on s’intéressera à plusieurs variables. Dans le présent exemple on pourrait considérer la variable « longueur à la naissance » mesurée, par exemple, en centimètres. On pourrait aussi considérer plusieurs populations. Par exemple, un chercheur pourrait vouloir comparer différentes espèces de serpents.
Tableau 1.1: Les poids (en grammes) de 147 serpents nouveau-nés.
33.90
34.87
34.49
34.16
35.14
34.10
34.41
33.10
35.59
35.20
34.35
33.87
35.18
34.54
35.71
34.74
36.42
34.68
34.05
34.76
35.49
35.44
36.03
34.19
35.49
35.30
34.26
35.36
35.83
33.64
34.83
36.11
35.32
37.37
34.78
36.66
33.91
33.55
34.91
34.17
34.96
34.71
34.31
35.78
34.86
34.19
35.50
32.62
33.20
35.52
34.59
35.32
36.21
35.61
36.14
34.31
34.55
37.61
35.86
33.75
34.77
34.37
33.68
35.70
35.65
35.67
34.20
34.11
35.18
35.07
35.74
36.11
34.99
35.05
34.36
36.00
34.27
35.05
35.97
33.07
34.76
34.23
35.13
34.56
35.54
36.52
35.04
35.50
33.68
34.17
32.99
33.68
35.78
33.40
34.31
34.81
35.53
33.99
34.77
36.37
35.79
33.65
35.10
33.97
36.08
35.03
35.65
35.30
36.27
35.97
33.53
36.68
36.11
34.67
34.04
34.51
35.39
35.25
35.45
34.22
35.07
34.49
34.11
34.69
34.80
33.95
33.31
34.19
36.03
35.44
36.73
35.14
34.03
34.16
33.94
32.83
33.56
36.84
32.96
35.34
35.44
35.57
34.26
34.89
34.34
34.02
35.56
Dans les sections qui vont suivre, nous allons examiner les données du tableau 1.1 et nous allons essayer de mettre en évidence l’information qu’elles contiennent.
Les différents types de variables statistiques
La plupart des variables statistiques qu’on rencontre dans la pratique appartiennent à l’une ou l’autre des quatre catégories suivantes. Nous aurons l’occasion de travailler avec ces différents types de variables tout au long de ce cours.
Variable quantitative continue. Il s’agit d’une variable à valeurs numériques. La variable peut prendre n’importe quelle valeur à l’intérieur d’un intervalle. Voici quelques exemples typiques de variables quantitatives continues : le poids d’un individu, le temps de germination d’une graine de semence, la durée de vie d’un animal, le volume d’une pomme, la hauteur d’un plant.
Variable quantitative discrète. Il s’agit d’une variable à valeurs numériques avec seulement quelques valeurs possibles. Dans la plupart des exemples qu’on rencontre en pratique, ces valeurs possibles sont des nombres entiers. Voici quelques exemples de variables quantitatives discrètes : le nombre de louveteaux dans la portée d’une louve, le nombre de fruits sur un plant, le nombre d’ordinateurs dans une maison unifamiliale.
Variable qualitative ordinale. Il s’agit d’une variable possédant un nombre fini de valeurs possibles. Ces valeurs possibles ne sont pas numériques mais elles sont tout de même ordonnées de façon naturelle. Exemple 1 : le niveau de satisfaction par rapport à un certain produit pourrait être une variable avec valeurs possibles « pas du tout satisfait », « moyennement satisfait », « très satisfait ». Exemple 2 : dans une population d’individus, on pourrait s’intéresser à la variable dont les valeurs possibles seraient « enfant », « adolescent », « adulte » et « personne âgée ».
Variable qualitative nominale. Il s’agit d’une variable possédant un nombre fini de valeurs possibles. Ces valeurs possibles ne sont pas numériques et elles ne sont pas ordonnées de façon naturelle. Voici quelques exemples typiques de variables qualitatives nominales : la nationalité d’un individu, le programme d’étude d’un étudiant de l’Université Laval, le sexe d’une personne.
1.3 L’histogramme
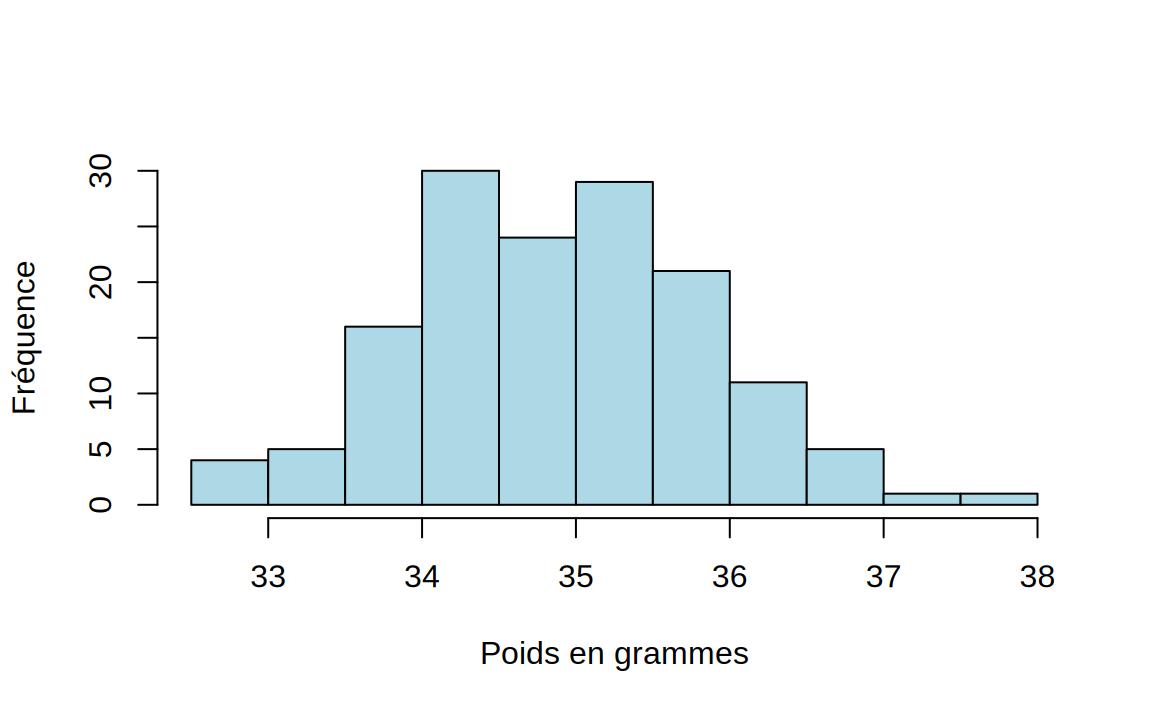
L’histogramme est une représentation graphique qui nous permet de voir la forme de la distribution des données. On l’utilise surtout lorsqu’on est en présence d’une variable quantitative continue. Pour construire l’histogramme, on groupe d’abord les données en classes convenablement choisies. Voici un choix raisonnable de classes, ainsi que les fréquences correspondantes, pour l’exemple des serpents.
Tableau 1.2: Les poids des 147 serpents.
Poids en grammes
Fréquence
(32.5, 33.0]
4
(33.0, 33.5]
5
(33.5, 34.0]
16
(34.0, 34.5]
30
(34.5, 35.0]
24
(35.0, 35.5]
29
(35.5, 36.0]
21
(36.0, 36.5]
11
(36.5, 37.0]
5
(37.0, 37.5]
1
(37.5, 38.0]
1
Les données présentées dans le tableau 1.1 sont parfois appelées les données brutes. Le tableau 1.2 contient quant à lui les données groupées. À partir des données groupées, on obtient l’histogramme de la figure 1.1.
Code R
hist(poids, breaks =seq(32.5, 38, by =0.5), main ="",xlab ="Poids en grammes", ylab ="Fréquence", col ="lightblue")
Figure 1.1: Histogramme des poids des 147 serpents (11 classes).
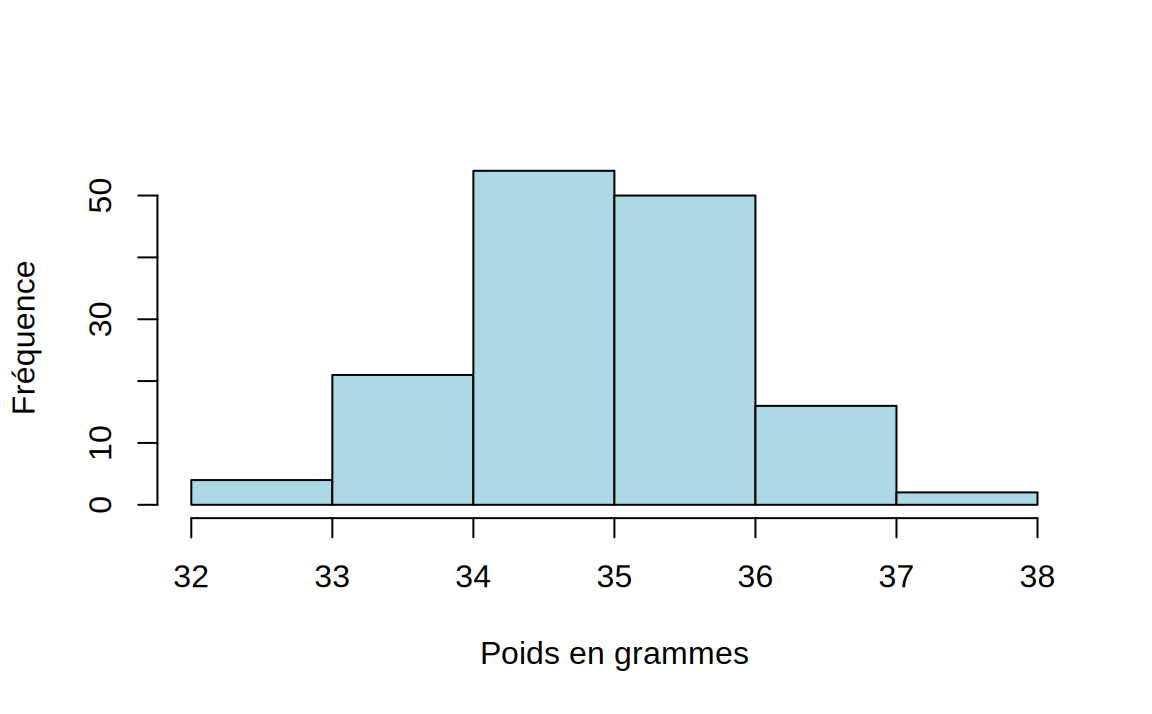
Il est important de noter que le choix des classes est un peu arbitraire. Avec un trop grand nombre de classes on risque d’obtenir un histogramme trop chaotique. Avec un trop petit nombre de classes on risque de ne pas bien voir la forme de la distribution. Avec l’exemple des serpents, on aurait pu grouper les données de la façon suivante :
Tableau 1.3: Les poids des 147 serpents ; seulement 6 classes.
Poids en grammes
Fréquence
(32.0, 33.0]
4
(33.0, 34.0]
21
(34.0, 35.0]
54
(35.0, 36.0]
50
(36.0, 37.0]
16
(37.0, 38.0]
2
On obtient alors l’histogramme suivant :
Code R
hist(poids, breaks =32:38, main ="",xlab ="Poids en grammes", ylab ="Fréquence", col ="lightblue")
Figure 1.2: Histogramme des poids des 147 serpents (6 classes).
Histogramme avec classes inégales
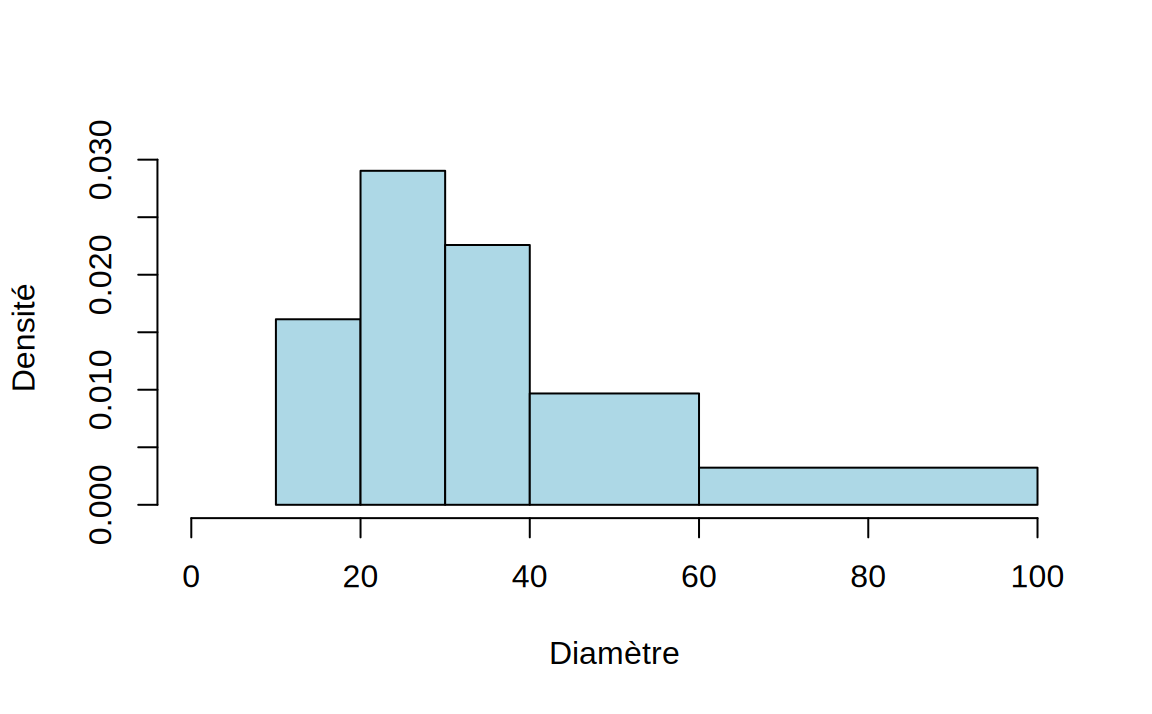
Dans l’exemple des serpents, les classes que nous avons utilisées étaient toutes de la même largeur. Il peut arriver que les observations nous soient présentées sous forme d’un tableau de données groupées dont les classes ne sont pas toutes de la même largeur. Lorsqu’on construit notre histogramme, il faut alors s’assurer que ce sont les surfaces des boîtes (et non leurs hauteurs) qui sont proportionnelles aux fréquences observées. Voici un exemple illustratif.
Exemple 2. Chez Anti-Rouille Métropolitain, on a mesuré les diamètres de 155 gouttelettes d’huile émises par un appareil utilisé pour l’application d’une protection anti-rouille pour véhicules motorisés. Le tableau suivant résume nos observations :
Diamètre des gouttes
Fréquence observée
(10, 20]
25
(20, 30]
45
(30, 40]
35
(40, 60]
30
(60, 100]
20
Ces diamètres sont mesurés en microns. L’histogramme obtenu avec le logiciel R est reproduit à la figure 1.3. L’axe vertical de cet histogramme est différent de celui de l’histogramme des poids des serpents. Avec les serpents, les classes étaient toutes de la même largeur. Le logiciel R produisait alors un histogramme de fréquences absolues : sur l’axe vertical gradué on lisait les fréquences absolues des classes. Dans la figure 1.1, la hauteur de la boîte correspondant à la classe (33.5, 34.0] est donc égale à 16 et c’est ce qu’on peut lire sur l’axe vertical gradué. Dans l’exemple des gouttelettes d’huile, les classes ne sont pas toutes de la même largeur. Le logiciel R produit alors un histogramme de type densité : les surfaces des boîtes sont égales aux fréquences relatives des différentes classes. Prenons par exemple la classe (40, 60]. Cette classe contient 30 observations. La fréquence relative de cette classe est donc \(30/155 = 0.19355\). Dans l’histogramme, la surface de la boîte correspondant à la classe (40, 60] est donc 0.19355. Comme la base de cette boîte rectangulaire mesure \(60 - 40 = 20\), sa hauteur est \(0.19355/20 = 0.0097\) et c’est ce qu’on peut lire sur l’axe vertical gradué.
Code R
bornes <-c(10, 20, 30, 40, 60, 100)freq <-c(25, 45, 35, 30, 20)# On reconstitue un jeu de données compatible avec le tableau# (chaque observation placée au milieu de sa classe) :gouttes <-rep((head(bornes, -1) +tail(bornes, -1)) /2, freq)hist(gouttes, breaks = bornes, main ="", xlab ="Diamètre",ylab ="Densité", col ="lightblue", xlim =c(0, 100))
Figure 1.3: Histogramme de type densité des diamètres de 155 gouttelettes d’huile.
Histogramme des fréquences absolues dessiné à la main
Voici comment on dessine à la main un histogramme de fréquences absolues. Notre tableau des données groupées a l’allure suivante :
Classe
Fréquence
\((c_0, c_1]\)
\(f_1\)
\((c_1, c_2]\)
\(f_2\)
\(\vdots\)
\(\vdots\)
\((c_{\ell-1}, c_\ell]\)
\(f_\ell\)
On suppose ici que les \(\ell\) classes sont toutes de même largeur. Autrement dit on a \[
c_1 - c_0 = c_2 - c_1 = c_3 - c_2 = \cdots = c_\ell - c_{\ell-1}.
\] On dessine l’histogramme de la façon suivante :
On trace un axe horizontal gradué.
Sur cet axe, on indique les valeurs \(c_0, c_1, c_2, \ldots, c_\ell\).
Pour chaque \(j \in \{1, 2, \ldots, \ell\}\), on dessine une boîte rectangulaire dont la base coïncide avec l’intervalle \((c_{j-1}, c_j]\) sur notre axe gradué et dont la hauteur est égale à la fréquence absolue \(f_j\).
Histogramme de type densité dessiné à la main
Pour ce type d’histogramme, il n’est pas nécessaire que les classes soient toutes de la même largeur. On construit d’abord le tableau suivant :
On dessine ensuite l’histogramme de la façon suivante :
On trace un axe horizontal gradué.
Sur cet axe, on indique les valeurs \(c_0, c_1, c_2, \ldots, c_\ell\).
Pour chaque \(j \in \{1, 2, \ldots, \ell\}\), on dessine une boîte rectangulaire dont la base coïncide avec l’intervalle \((c_{j-1}, c_j]\) sur notre axe gradué et dont la surface est égale à la fréquence relative \(f_j/n\). Autrement dit, on dessine une boîte rectangulaire dont la base coïncide avec l’intervalle \((c_{j-1}, c_j]\) sur notre axe gradué et dont la hauteur est égale à \(h_j = \dfrac{f_j/n}{c_j - c_{j-1}}\).
1.4 La moyenne et l’écart-type
Considérons un échantillon de taille \(n\), disons \(x_1, x_2, x_3, \ldots, x_n\). On suppose ici que la variable statistique d’intérêt est de type quantitative. Une statistique est une quantité calculée à partir de l’échantillon. Les deux statistiques les plus importantes sont la moyenne échantillonnale, notée \(\overline{x}\), et l’écart-type échantillonnal, noté \(s\). Ces statistiques sont données par les formules suivantes : \[
\overline{x} = \frac{1}{n} \sum_{i=1}^{n} x_i,
\tag{1.1}\]\[
s = \sqrt{\frac{1}{n-1} \sum_{i=1}^{n} (x_i - \overline{x})^2}.
\tag{1.2}\] La raison pour le dénominateur \(n - 1\) plutôt que \(n\) dans la formule (1.2) sera expliquée à la section 3.3. Dans l’exemple des serpents, on obtient \[
\begin{aligned}
\overline{x} &= \frac{33.90 + 33.10 + 35.71 + \cdots + 35.34 + 35.56}{147} = 34.882 \text{ g}, \\
s &= \sqrt{\frac{(33.90 - 34.882)^2 + (33.10 - 34.882)^2 + \cdots + (35.56 - 34.882)^2}{146}} = 0.956 \text{ g}.
\end{aligned}
\]
Code R
mean(poids)
#> [1] 34.88177
Code R
sd(poids)
#> [1] 0.9560275
On peut interpréter l’écart-type de la façon suivante. Le poids moyen de nos 147 serpents est \(\overline{x} = 34.882\) g. Certains serpents ont un poids qui est très proche de la moyenne \(\overline{x}\). D’autres ont un poids qui est très loin de la moyenne \(\overline{x}\). L’écart-type \(s = 0.956\) g représente la distance typique entre les poids \(x_i\) et la moyenne des poids \(\overline{x}\).
La moyenne \(\overline{x}\) est un exemple de ce qu’on appelle une mesure de tendance centrale. C’est de loin la mesure de tendance centrale la plus utilisée. L’écart-type \(s\) est un exemple de ce qu’on appelle une mesure de dispersion. Malgré le fait que la formule (1.2) soit plutôt compliquée, l’écart-type est de loin la mesure de dispersion la plus utilisée. Une alternative conceptuellement plus simple est l’écart absolu moyen donné par la formule suivante : \[
d = \frac{1}{n} \sum_{i=1}^{n} |x_i - \overline{x}|.
\] Son interprétation est simple. L’écart absolu moyen \(d\) est simplement la moyenne des distances entre les observations \(x_i\) et la moyenne \(\overline{x}\). En pratique, personne n’utilise l’écart absolu moyen \(d\), tout le monde utilise l’écart-type \(s\). La principale raison est que, contrairement à l’écart absolu moyen, l’écart-type possède de belles propriétés mathématiques. Nous y reviendrons aux chapitres 2 et 3. D’un point de vue pratique, il n’y a pas une grande différence entre les deux. Dans l’exemple des serpents, on obtient \[
d = \frac{|33.90 - 34.882| + |33.10 - 34.882| + \cdots + |35.56 - 34.882|}{147} = 0.779 \text{ g}.
\]
Code R
mean(abs(poids -mean(poids)))
#> [1] 0.7793558
Le coefficient de variation
Dans le cas des variables à valeurs positives (poids, longueurs, durées de vie, etc.), le rapport \(s/\overline{x}\) est souvent utilisé pour mesurer la dispersion relative. Ce rapport \(s/\overline{x}\) est appelé le coefficient de variation. Il est parfois dénoté CV. Contrairement à l’écart-type, le coefficient de variation est un nombre sans unité. Il est souvent exprimé en pourcentage.
Voici un exemple illustratif. On mesure les poids de 75 rats de laboratoire. On calcule la moyenne et l’écart-type et on obtient \(\overline{x}_1 = 110\) grammes et \(s_1 = 11\) grammes. On mesure ensuite les poids de 84 lapins, on calcule la moyenne et l’écart-type et on obtient \(\overline{x}_2 = 660\) grammes et \(s_2 = 22\) grammes.
Population
Taille de l’échantillon
Moyenne échantillonnale
Écart-type échantillonnal
Les rats
\(n_1 = 75\)
\(\overline{x}_1 = 110\)
\(s_1 = 11\)
Les lapins
\(n_2 = 84\)
\(\overline{x}_2 = 660\)
\(s_2 = 22\)
Si on compare les écarts-types \(s_1\) et \(s_2\), on conclut qu’il y a dans les poids des lapins deux fois plus de variation que dans les poids des rats. Mais un écart-type de 22 grammes est relativement petit considérant que la moyenne est 660 grammes alors qu’un écart-type de 11 grammes est relativement grand considérant que la moyenne est 110 grammes ! Plutôt que de comparer les écarts-types, il est probablement plus approprié de comparer les coefficients de variation. Ici on obtient \[
\begin{aligned}
CV_1 &= \frac{s_1}{\overline{x}_1} = \frac{11}{110} = 0.100, \text{ c'est-à-dire } 10\,\%, \\
CV_2 &= \frac{s_2}{\overline{x}_2} = \frac{22}{660} = 0.033, \text{ c'est-à-dire } 3.3\,\%.
\end{aligned}
\] Bref, l’écart-type est plus petit chez les rats mais le coefficient de variation est plus petit chez les lapins.
Calcul de \(\overline{x}\) et \(s\) à partir des données groupées
Pour pouvoir utiliser les formules (1.1) et (1.2), il faut avoir accès aux données brutes. Lorsqu’on dispose seulement des données groupées, il est possible de calculer des valeurs approximatives pour \(\overline{x}\) et \(s\), qu’on notera \(\overline{x}^*\) et \(s^*\). Il suffit de faire comme si les \(f_j\) observations de la classe \((c_{j-1}, c_j]\) étaient toutes égales à la valeur \(m_j = (c_{j-1} + c_j)/2\), le milieu de la classe \((c_{j-1}, c_j]\). On obtient ainsi les approximations suivantes : \[
\overline{x} \approx \overline{x}^* = \frac{1}{n} \sum_{j=1}^{\ell} (f_j \times m_j),
\qquad
s \approx s^* = \sqrt{\frac{1}{n-1} \sum_{j=1}^{\ell} \big(f_j \times (m_j - \overline{x}^*)^2\big)}.
\] Pour l’exemple des gouttelettes d’huile, on obtient \[
\begin{aligned}
\overline{x}^* &= \frac{1}{155} \sum_{j=1}^{5} (f_j \times m_j)
= \frac{(25 \times 15) + (45 \times 25) + (35 \times 35) + (30 \times 50) + (20 \times 80)}{155}
= 37.58 \text{ microns}, \\
s^* &= \sqrt{\frac{1}{154} \sum_{j=1}^{5} \big(f_j \times (m_j - \overline{x}^*)^2\big)}
= \sqrt{\frac{1}{154} \Big\{ \big(25 \times (15 - 37.58)^2\big) + \cdots + \big(20 \times (80 - 37.58)^2\big) \Big\}}
= 19.86 \text{ microns}.
\end{aligned}
\]
Comme à la section précédente, on considère un ensemble de \(n\) nombres qu’on note \(x_1, x_2, x_3, \ldots, x_n\) et qu’on appelle nos observations, ou nos données brutes, ou notre échantillon. Fixons \(\gamma\), un nombre entre 0 et 1. Grosso modo, le quantile d’ordre \(\gamma\) de notre échantillon est un nombre qu’on dénote \(q_\gamma\) et qui possède la propriété suivante : \(100\gamma\,\%\) des observations sont plus petites que \(q_\gamma\) (et par conséquent \(100(1-\gamma)\,\%\) des observations sont plus grandes que \(q_\gamma\)). Dans l’exemple des 147 poids de serpents nouveau-nés, le quantile d’ordre 0.4 est donc la valeur, notée \(q_{0.4}\), qui est telle que 40 % de nos 147 poids lui sont inférieurs et 60 % lui sont supérieurs. Le qualificatif grosso modo est important. Si on est en présence d’un échantillon de taille \(n = 7\) et si nos sept observations sont \[
22.3 \quad 17.9 \quad 20.4 \quad 24.6 \quad 19.5 \quad 26.2 \quad 18.7
\] alors comment définit-on \(q_{0.3}\), le quantile d’ordre 0.3 ? On aimerait que \(q_{0.3}\) soit un nombre tel que 30 % des observations lui sont inférieures (et 70 % lui sont supérieures). Il y a plusieurs façons de procéder. Voici l’approche utilisée par la plupart des logiciels de statistique. D’abord, on écrit \(x_{(1)}, x_{(2)}, x_{(3)}, \ldots, x_{(n)}\) pour dénoter nos observations placées en ordre croissant. Donc \(x_{(1)}\) dénote la plus petite observation, \(x_{(2)}\) dénote la deuxième plus petite observation, \(x_{(3)}\) dénote la troisième plus petite observation, etc., et enfin \(x_{(n)}\) dénote la plus grande observation. On a donc \[
x_{(1)} \le x_{(2)} \le x_{(3)} \le \cdots \le x_{(n)}.
\tag{1.3}\] Dans notre exemple avec \(n = 7\), on a \[
(x_1, x_2, x_3, x_4, x_5, x_6, x_7) = (22.3, 17.9, 20.4, 24.6, 19.5, 26.2, 18.7)
\] et on obtient \[
\big(x_{(1)}, x_{(2)}, x_{(3)}, x_{(4)}, x_{(5)}, x_{(6)}, x_{(7)}\big) = (17.9, 18.7, 19.5, 20.4, 22.3, 24.6, 26.2).
\] Le quantile échantillonnal d’ordre \(\gamma\) est défini de la façon suivante : \[
q_\gamma = x_{(1 + (n-1)\gamma)}.
\tag{1.4}\] Dans notre exemple avec \(n = 7\) et \(\gamma = 0.3\), on obtient \[
q_{0.3} = x_{(1 + (7-1) \times 0.3)} = x_{(2.8)}.
\] Petit problème : il faut préciser ce qu’on entend par \(x_{(2.8)}\). La réponse est simple : \(x_{(2.8)}\) est situé à 80 % du chemin entre \(x_{(2)}\) et \(x_{(3)}\) : \[
x_{(2.8)} = x_{(2)} + 0.8 \times (x_{(3)} - x_{(2)}).
\] On obtient donc \[
\begin{aligned}
q_{0.3} &= x_{(1 + (7-1) \times 0.3)} = x_{(2.8)} \\
&= x_{(2)} + 0.8 \times (x_{(3)} - x_{(2)}) \\
&= 18.7 + 0.8 \times (19.5 - 18.7) \\
&= 19.34.
\end{aligned}
\] Dans l’exemple des serpents on a \(n = 147\). Avec \(\gamma = 0.4\) on obtient \[
\begin{aligned}
q_{0.4} &= x_{(1 + (147-1) \times 0.4)} = x_{(59.4)} \\
&= x_{(59)} + 0.4 \times (x_{(60)} - x_{(59)}) \\
&= 34.56 + 0.4 \times (34.59 - 34.56) \\
&= 34.572.
\end{aligned}
\]
AstuceDans R
La définition (1.4) est celle qu’utilise par défaut la fonction quantile() de R (option type = 7).
x <-c(22.3, 17.9, 20.4, 24.6, 19.5, 26.2, 18.7)quantile(x, 0.3)
#>   30%
#> 19.34
quantile(poids, 0.4)
#>    40%
#> 34.572
Centiles, quartiles et médiane
Certains quantiles ont des noms particuliers et des notations particulières. Si \(k\) est un entier entre 0 et 100, le quantile d’ordre \(k/100\) est appelé le \(k\)ecentile. Le terme percentile est synonyme de centile. Par exemple, le quantile d’ordre 0.17, qu’on note \(q_{0.17}\), est aussi appelé le 17e centile. Les quantiles d’ordre 0.25, 0.50 et 0.75, qu’on note respectivement \(q_{0.25}\), \(q_{0.50}\) et \(q_{0.75}\), et qu’on appelle aussi le 25e centile, le 50e centile et le 75e centile, sont également appelés le premier quartile, le deuxième quartile et le troisième quartile et sont souvent dénotés \(Q_1\), \(Q_2\) et \(Q_3\). Le deuxième quartile est aussi appelé la médiane et est souvent dénoté \(m\). Tout comme la moyenne \(\overline{x}\), la médiane \(m\) est une mesure de tendance centrale.
Les quartiles \(Q_1\), \(Q_2\) et \(Q_3\) seront utilisés dans la prochaine section. Examinons-les de plus près. Avec la formule (1.4), on obtient \[
Q_1 = x_{(1 + (n-1)/4)}, \qquad Q_2 = x_{(1 + (n-1)/2)}, \qquad Q_3 = x_{(1 + 3(n-1)/4)}.
\] L’équation ci-dessus pour \(Q_2\) peut être réécrite sous la forme suivante : \[
Q_2 =
\begin{cases}
x_{\left(\frac{n+1}{2}\right)} & \text{si $n$ est impair,} \\[2mm]
\dfrac{x_{\left(\frac{n}{2}\right)} + x_{\left(\frac{n}{2} + 1\right)}}{2} & \text{si $n$ est pair.}
\end{cases}
\] Bref, si \(n\) est impair, la médiane \(Q_2\) est la valeur du milieu dans la liste (1.3) alors que si \(n\) est pair la médiane \(Q_2\) est à mi-chemin entre les deux valeurs du milieu. Dans l’exemple ci-dessus avec \(n = 7\), on obtient \[
Q_2 = x_{\left(\frac{n+1}{2}\right)} = x_{(4)} = 20.4.
\]
Les rangs centiles
Imaginez un grand jeu de données, disons \(x_1, x_2, \ldots, x_n\) avec \(n\) très grand. Les 99 centiles \(q_{0.01}, q_{0.02}, q_{0.03}, \ldots, q_{0.99}\) découpent l’axe des \(x\) en 100 segments. Imaginez qu’on numérote ces 100 segments de 1 à 100 en partant de la gauche. Le rang centile d’une observation est le numéro du segment dans lequel se trouve cette observation. Il ne faut pas confondre centile et rang centile. Dire que le rang centile de l’observation \(x_j\) est égal à \(k\), c’est dire que cette observation \(x_j\) est située quelque part entre le \((k-1)\)e centile et le \(k\)e centile. Dans l’exemple des serpents, le tableau 1.1 nous indique que le premier serpent pesait 33.90 grammes. La formule (1.4) nous permet de voir que \(q_{0.13} = 33.8994\) et \(q_{0.14} = 33.9232\). Le rang centile de l’observation 33.90 est donc égal à 14.
Le minimum et le maximum
La plus petite observation, \(x_{(1)}\), aussi appelée le minimum et parfois dénotée min, peut aussi être vue comme étant le quantile d’ordre 0. En effet, si on prend \(\gamma = 0\) dans l’équation (1.4), alors on obtient \[
q_0 = x_{(1 + (n-1) \times 0)} = x_{(1)}.
\] De même, la plus grande observation, \(x_{(n)}\), aussi appelée le maximum et parfois dénotée max, peut aussi être vue comme étant le quantile d’ordre 1. En effet, si on prend \(\gamma = 1\) dans l’équation (1.4), alors on obtient \[
q_1 = x_{(1 + (n-1) \times 1)} = x_{(1 + (n-1))} = x_{(n)}.
\]
Le résumé à cinq nombres
Le vecteur \((x_{(1)}, Q_1, Q_2, Q_3, x_{(n)})\), aussi dénoté \((q_{0.00}, q_{0.25}, q_{0.50}, q_{0.75}, q_{1.00})\), est souvent appelé le résumé à cinq nombres. Rappelons que \(x_{(1)}\) est simplement la plus petite observation et est souvent dénotée min (pour minimum). De même, \(x_{(n)}\) est simplement la plus grande observation et est souvent dénotée max (pour maximum). Ce résumé à cinq nombres sera utilisé dans la construction du diagramme en boîte dans la prochaine section.
La distance entre le premier quartile \(Q_1\) et le troisième quartile \(Q_3\) est appelée l’écart interquartile et est souvent dénotée EIQ. On a donc \(\text{EIQ} = Q_3 - Q_1\). Tout comme l’écart-type \(s\), l’écart interquartile est une mesure de dispersion.
Les données aberrantes
Grosso modo, une observation qui se trouve très loin du centre de la distribution est appelée une observation aberrante. Le critère suivant est souvent utilisé comme définition d’observation aberrante : l’observation \(x_i\) est dite aberrante \[
\text{si } x_i > Q_3 + (1.5 \times \text{EIQ}) \quad \text{ou si } x_i < Q_1 - (1.5 \times \text{EIQ}).
\]
1.6 Le diagramme en boîte
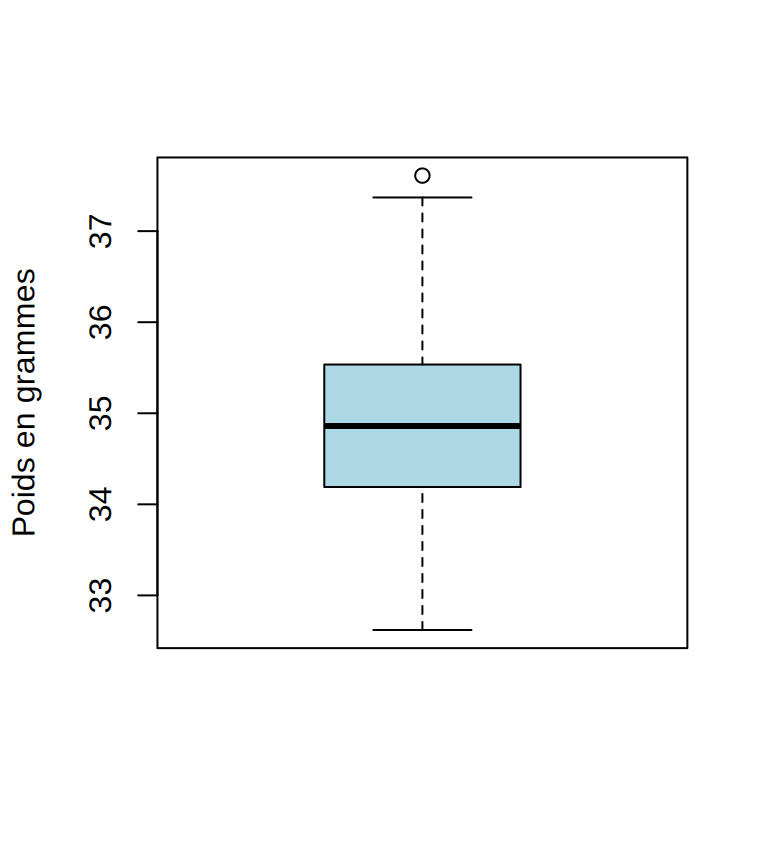
À quelques détails près, le diagramme en boîte (en anglais boxplot) est une simple représentation graphique du résumé à cinq nombres. La figure 1.4 présente le diagramme en boîte pour l’exemple des serpents.
Code R
boxplot(poids, ylab ="Poids en grammes", col ="lightblue")
Figure 1.4: Le diagramme en boîte pour l’exemple des serpents.
Ce diagramme en boîte a été construit de la façon suivante.
On trace un axe vertical gradué.
Sur cet axe vertical, on note la position des valeurs \(x_{(1)}\), \(Q_1\), \(Q_2\), \(Q_3\), \(x_{(n)}\).
À droite de l’axe vertical, on dessine une boîte rectangulaire de hauteur égale à l’écart interquartile EIQ, avec extrémité inférieure située à la hauteur \(Q_1\) et extrémité supérieure située à la hauteur \(Q_3\).
À travers cette boîte, on trace un segment horizontal à la hauteur \(Q_2\).
À partir du centre du côté inférieur de la boîte, on trace un segment vertical, appelé bras inférieur, qui s’étend de la boîte jusqu’à la plus petite observation non aberrante, c’est-à-dire jusqu’au plus petit \(x_i\) satisfaisant \(x_i \ge Q_1 - 1.5\,\text{EIQ}\).
À partir du centre du côté supérieur de la boîte, on trace un segment vertical, appelé bras supérieur, qui s’étend de la boîte jusqu’à la plus grande observation non aberrante, c’est-à-dire jusqu’au plus grand \(x_i\) satisfaisant \(x_i \le Q_3 + 1.5\,\text{EIQ}\).
Les observations aberrantes, s’il y en a, sont alors indiquées par des astérisques ou des points sur le prolongement imaginaire des bras.
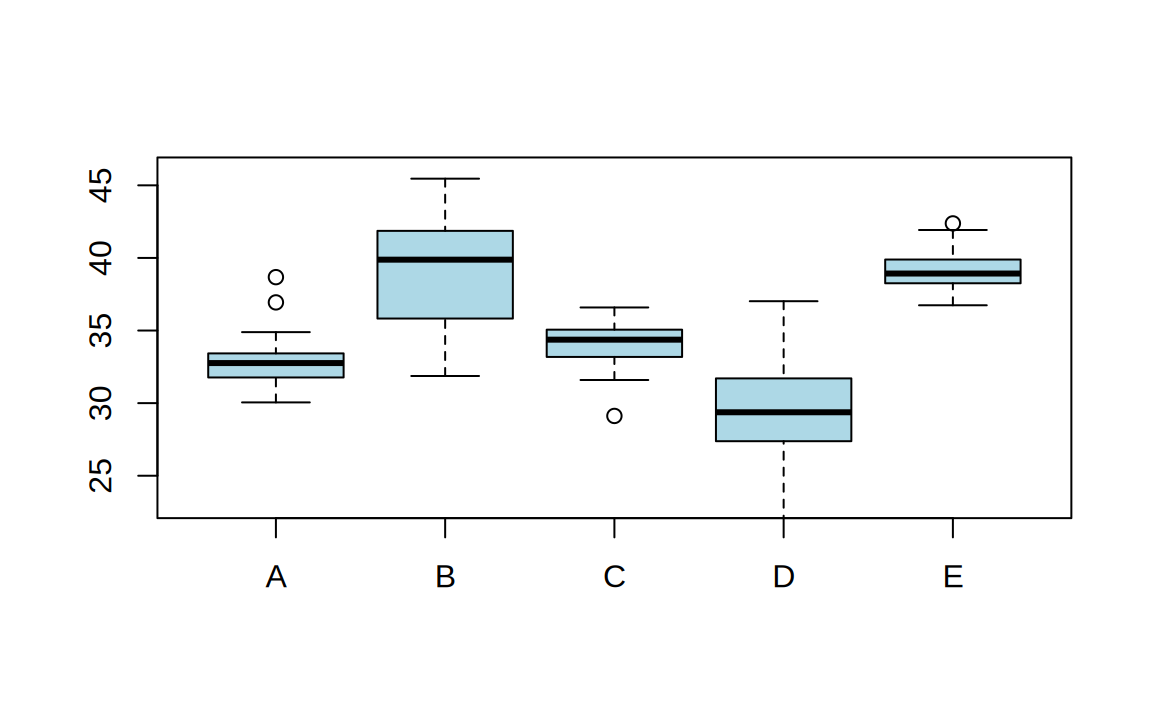
En général, l’histogramme est une meilleure représentation graphique des données que le diagramme en boîte. Cependant, le diagramme en boîte est un outil très utile lorsqu’on veut comparer plusieurs échantillons. Revenons à l’exemple des serpents. Imaginez qu’on veuille comparer les poids à la naissance pour 5 populations de serpents. Une façon simple de faire cette comparaison serait de tracer les diagrammes en boîte juxtaposés. On obtiendrait quelque chose ressemblant peut-être à la figure 1.5.
Code R
set.seed(1920)pop <-list(A =rnorm(40, 33, 1.5), B =rnorm(40, 38, 3.5),C =rnorm(40, 34, 1.5), D =rnorm(40, 30, 3.5),E =rnorm(40, 39, 1.5))boxplot(pop, col ="lightblue", ylim =c(23, 46))
Figure 1.5: Diagrammes en boîte juxtaposés pour cinq populations (données fictives).
À l’aide d’un tel graphe on peut tirer plusieurs conclusions, dont les suivantes : ce sont dans les populations B et E que les poids sont les plus grands et dans la population D qu’ils sont les plus petits ; pour les populations B et D, les poids varient beaucoup plus que pour les trois autres populations.
Petit détail technique
Dans le cas où \(n\) est impair, le logiciel R dessine ses diagrammes en boîte selon la méthode décrite dans la présente section. Toutefois, dans le cas où \(n\) est pair, le logiciel R procède autrement. Plutôt que de tracer la limite inférieure de la boîte à la valeur \(Q_1\), il la trace à l’endroit situé à mi-chemin entre la plus grande observation inférieure à \(Q_1\) et la plus petite observation supérieure à \(Q_1\). De même, plutôt que de tracer la limite supérieure de la boîte à la valeur \(Q_3\), il la trace à l’endroit situé à mi-chemin entre la plus grande observation inférieure à \(Q_3\) et la plus petite observation supérieure à \(Q_3\). Dans l’exemple des serpents, les deux méthodes donnent le même diagramme en boîte. Avec les données 1, 2, 3, 7, 7, 7, 8, 9, 10, 20, 21, 24, les méthodes donnent des diagrammes en boîte différents. La boîte du diagramme produit par la méthode décrite dans la présente section va de \(Q_1 = 6\) à \(Q_3 = 12.5\). La boîte du diagramme en boîte produit par R va de \((3 + 7)/2 = 5\) à \((10 + 20)/2 = 15\).
y <-c(1, 2, 3, 7, 7, 7, 8, 9, 10, 20, 21, 24)quantile(y, c(0.25, 0.75)) # Q1 et Q3 selon (1.4)
#>  25%  75%
#>  6.0 12.5
boxplot.stats(y)$stats # limites utilisées par boxplot()
#> [1] 1.0 5.0 7.5 15.0 24.0
1.7 Diagramme en pointes de tarte et diagramme en bâtons
Les méthodes présentées jusqu’à maintenant sont des méthodes propres aux variables quantitatives. Pour les variables qualitatives, il existe des méthodes plus appropriées. Voici un exemple où la variable d’intérêt est une variable qualitative nominale.
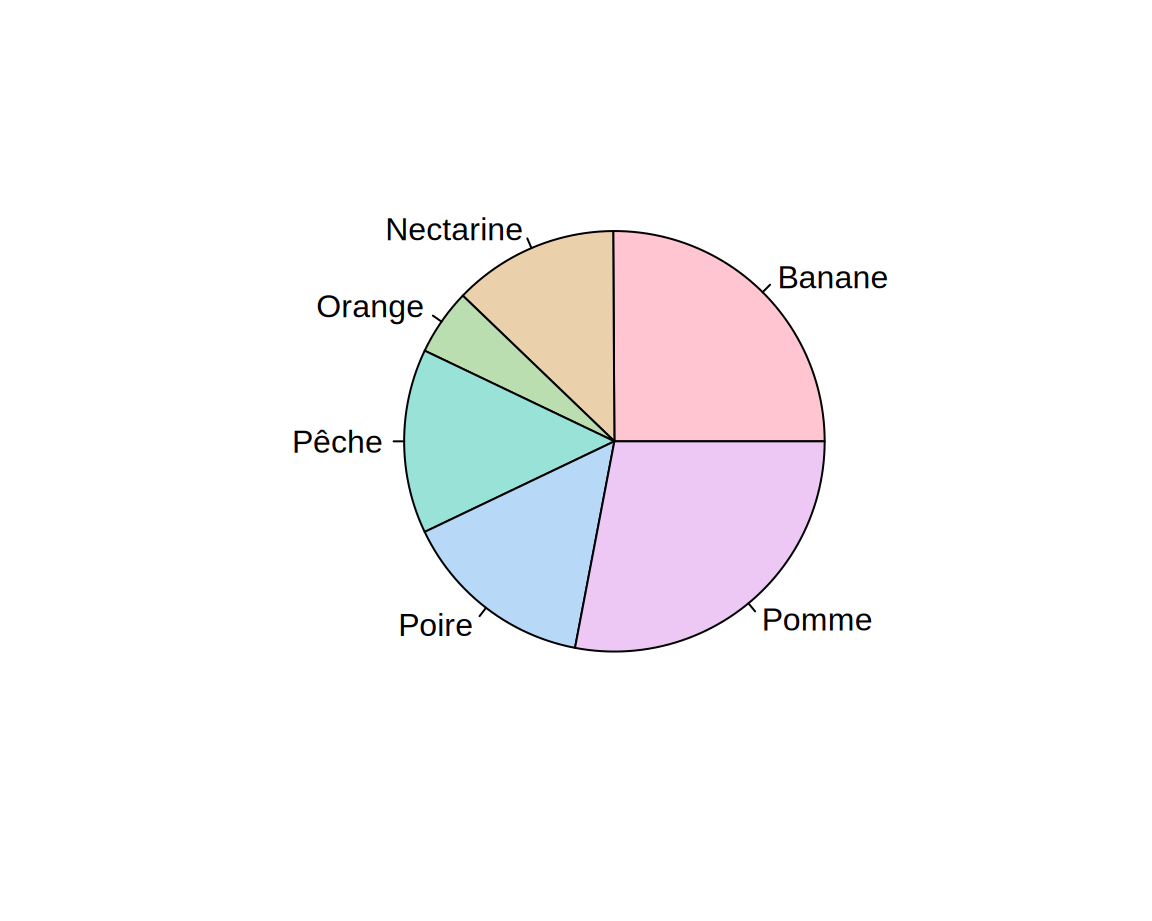
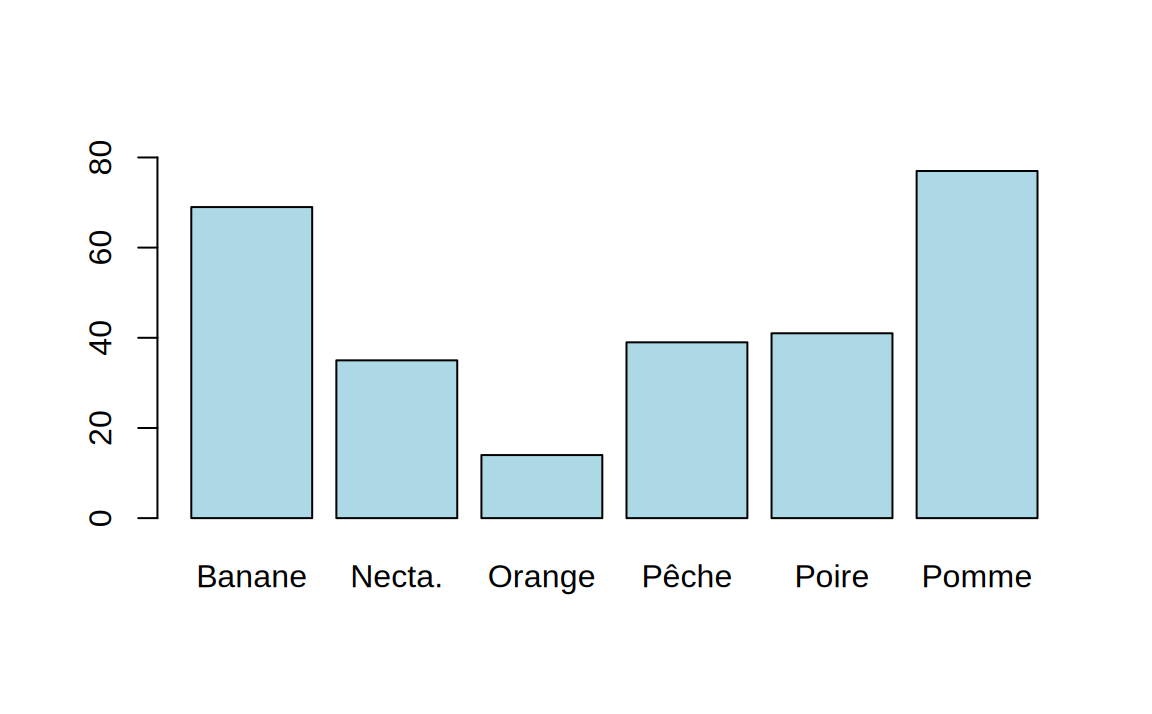
Exemple 3. On a demandé à 275 jeunes écoliers quel était leur fruit préféré parmi les six fruits les plus consommés au Québec : banane, nectarine, orange, pêche, poire, pomme. Voici les résultats de ce petit sondage maison :
Fruit
Fréquence
Banane
69
Nectarine
35
Orange
14
Pêche
39
Poire
41
Pomme
77
On peut représenter graphiquement ces données à l’aide d’un diagramme en camembert, aussi appelé diagramme en pointes de tarte (en anglais pie chart). Dans ce diagramme en pointes de tarte, les surfaces des secteurs (ou pointes de tarte) sont proportionnelles aux fréquences absolues données dans le tableau ci-dessus. Ceci est équivalent à dire que les longueurs des arcs de cercle sont proportionnelles aux fréquences absolues données dans le tableau ci-dessus.
Figure 1.7: Diagramme en bâtons pour l’exemple des fruits.
Le diagramme en bâtons (en anglais bar graph) est tout simplement un histogramme adapté aux variables qualitatives. Sur l’axe vertical on peut lire les fréquences absolues.
1.8 Les données bivariées
Cette section pourrait être étudiée plus tard, en même temps que le chapitre 6.
Il arrive souvent qu’on veuille étudier deux ou plusieurs variables en même temps. Considérons brièvement le cas de deux variables. On considère donc une population avec deux variables d’intérêt qu’on appelle tout simplement la variable \(X\) et la variable \(Y\). On obtient un échantillon aléatoire de taille \(n\) et, pour chacun des \(n\) individus de notre échantillon, on observe les deux variables. Nos données sont donc sous la forme de \(n\) couples qu’on note de la façon suivante : \[
(x_1, y_1), (x_2, y_2), (x_3, y_3), \ldots, (x_n, y_n).
\] On écrit \(\overline{x}\) et \(s_x\) pour la moyenne et l’écart-type de la variable \(X\) et on écrit \(\overline{y}\) et \(s_y\) pour la moyenne et l’écart-type de la variable \(Y\).
Revenons à l’exemple des serpents. Le fichier Serpents.xls disponible sur le site web du cours contient non seulement les poids des serpents mais aussi leurs longueurs. Intuitivement, on s’attend à ce qu’il y ait une association positive entre la variable poids et la variable longueur. Plus un serpent est pesant, plus on s’attend à ce qu’il soit long. Plus un serpent est léger, plus on s’attend à ce qu’il soit court. Pour visualiser cette association, on trace le graphe appelé graphe de dispersion ou diagramme de dispersion (en anglais scatterplot).
Code R
plot(serpents$poids, serpents$longueur,xlab ="Poids en grammes", ylab ="Longueur en centimètres")
AvertissementFigure à compléter
Les longueurs des serpents ne figurent pas dans le texte des notes. Ajoutez une colonne longueur au fichier donnees/serpents.csv (à partir de Serpents.xls) et le diagramme de dispersion sera produit automatiquement.
Pour mesurer le degré d’association linéaire entre deux variables quantitatives, on utilise le coefficient de corrélation. Ce coefficient est dénoté \(r\) et est calculé de la façon suivante : \[
r = \frac{1}{n-1} \sum_{i=1}^{n} \left( \frac{x_i - \overline{x}}{s_x} \right) \left( \frac{y_i - \overline{y}}{s_y} \right).
\tag{1.5}\] Dans l’exemple des serpents, on obtient \(r = 0.707\). Le coefficient de corrélation est toujours un nombre compris entre \(-1\) et \(1\). Il mesure le degré d’association linéaire entre les deux variables. Nous y reviendrons aux chapitres 2 et 6.
1.9 Exercices
Numéro 1. Déterminez la nature (quantitative continue, quantitative discrète, qualitative ordinale ou qualitative nominale) de chacune des variables suivantes.
La moyenne cumulative d’un étudiant de l’Université Laval.
La cote (A+, A, A-, B+, …) qu’un étudiant reçoit dans un cours.
La section (A, B, S) du cours STT-10400 à laquelle un étudiant de génie électrique est inscrit.
Le nombre de fois qu’un étudiant du baccalauréat en agronomie échoue le cours STT-19909 durant son baccalauréat.
Le nombre de louveteaux dans la portée d’une louve.
Le poids d’un loup à la naissance.
La couleur (blanche, jaune, orange, verte, bleue, marron, noire) de la ceinture d’un adepte de karaté Shotokan.
La couleur du feu de circulation en arrivant à l’intersection du Chemin Ste-Foy lorsque vous roulez sur la rue Myrand en direction nord.
Le salaire annuel d’un professeur de cégep.
Le nombre de tomates produites par un plant de tomate durant le mois d’août.
La nature d’une variable statistique.
Numéro 2. On a mesuré les diamètres de 34 prunes. Voici les résultats, en centimètres.
4.03
4.05
3.96
4.09
4.28
4.04
4.18
4.23
4.14
4.12
4.03
3.94
4.02
4.08
4.13
4.04
3.93
4.08
4.37
4.07
4.11
4.03
4.00
3.97
4.01
4.09
4.06
3.92
4.19
3.96
4.48
4.24
4.06
3.98
Calculez la moyenne.
Calculez l’écart-type.
Calculez le coefficient de variation.
Dessinez un histogramme approprié.
Calculez le résumé à cinq nombres.
Dessinez le diagramme en boîte.
Qu’arrive-t-il à la moyenne si les valeurs 4.18, 4.23, 4.14 et 4.12 sont remplacées par les valeurs 4.68, 4.73, 4.64 et 4.62 ?
Qu’arrive-t-il à la médiane si les valeurs 4.18, 4.23, 4.14 et 4.12 sont remplacées par les valeurs 4.68, 4.73, 4.64 et 4.62 ?
Calculez le 30e centile.
Numéro 3. Un biologiste a mesuré les longueurs de 310 perchaudes attrapées dans le Chenal du Moine en août 2006. Le tableau suivant résume ces 310 mesures :
Longueur
Nombre de perchaudes
entre 21.0 et 22.0 cm
50
entre 22.0 et 23.0 cm
90
entre 23.0 et 24.0 cm
70
entre 24.0 et 26.0 cm
60
entre 26.0 et 30.0 cm
40
Représentez ces données à l’aide d’un histogramme.
Calculez une approximation pour la moyenne.
Calculez une approximation pour l’écart-type.
Calculez une approximation pour la médiane.
Calculez une approximation pour la proportion de perchaudes dont la longueur est située entre 25 et 27 cm.
Numéro 4. Le diagramme en boîte suivant représente la distribution des poids (exprimés en livres) des 92 joueurs qui se sont présentés au camp d’entraînement de l’équipe de football du Rouge et Or en juin dernier.
AvertissementFigure à compléter
Le diagramme en boîte de cet exercice (axe de 185 à 245 livres, deux observations aberrantes) n’a pas pu être récupéré à partir du texte des notes.
Les énoncés suivants sont-ils vrais ou faux ?
La somme des poids des 3 joueurs les plus pesants est inférieure à 720 livres.
La moyenne de ces 92 poids est 204 livres.
L’écart interquartile de ces 92 poids est de 15 livres.
[Pour les étudiants qui sont familiers avec la loi normale] La loi normale est un bon modèle pour décrire cette distribution de poids.
Numéro 5. Parmi les 116 étudiants inscrits au cours STT-20694 à l’automne 2006, 21 ont reçu un A, 36 ont reçu un B, 27 ont reçu un C, 18 ont reçu un D et 14 ont reçu un E.
Représentez ces données à l’aide d’un diagramme en pointes de tarte.
Représentez ces données à l’aide d’un diagramme en bâtons.
Numéro 6. On a mesuré la variable \(X\) = longueur (de la tête à la queue) et la variable \(Y\) = étendue (du bout d’une aile à l’autre) de 12 oiseaux d’une certaine espèce. Voici les résultats en mm.
Longueur
156
154
153
153
155
163
157
155
164
158
158
160
Étendue
245
240
240
236
243
247
238
239
248
238
240
244
Tracez le diagramme de dispersion.
Calculez les moyennes \(\overline{x}\) et \(\overline{y}\).
Calculez les écarts-types \(s_x\) et \(s_y\).
Calculez le coefficient de corrélation \(r\).
Sur le diagramme de dispersion, interprétez les résultats obtenus en (b),
et (d).
Numéro 7. On a mesuré les diamètres des troncs de 24 plants choisis au hasard dans un champ de blé d’Inde. Voici, en ordre croissant, nos 24 diamètres en millimètres :
10.5
10.9
11.4
11.8
12.1
12.1
12.5
12.7
12.8
13.1
13.3
13.4
13.7
13.9
14.1
14.3
14.5
14.8
15.3
15.4
15.7
16.2
16.4
17.9
Calculez la moyenne et l’écart-type.
Calculez le coefficient de variation.
Dessinez un histogramme. C’est à vous de choisir des classes raisonnables.
Obtenez le résumé à cinq nombres.
Dessinez le diagramme en boîte.
Calculez le quantile d’ordre 0.35.
Numéro 8. Quatre-vingt-dix jeunes pousses d’une certaine variété d’une espèce de plante ont été obtenues. On a mesuré la longueur de la plus grande feuille sur chacune des pousses. Le tableau suivant résume nos 90 observations :
Longueur de la plus grande feuille, en mm
Nombre de pousses
(25.0, 26.0]
12
(26.0, 27.0]
30
(27.0, 28.0]
20
(28.0, 29.0]
13
(29.0, 30.0]
5
(30.0, 31.0]
7
(31.0, 32.0]
3
Dessinez l’histogramme.
Obtenez l’approximation \(\overline{x}^*\) de la moyenne échantillonnale.
Obtenez l’approximation \(s^*\) de l’écart-type échantillonnal.
Obtenez l’approximation \(Q_2^*\) de la médiane échantillonnale.
Pour quel pourcentage des pousses la longueur de la plus grande feuille excède-t-elle 29 mm ?
Pour quel pourcentage des pousses la longueur de la plus grande feuille est-elle inférieure à 26.5 mm ?
Numéro 9. On a mesuré les diamètres des troncs de 247 plants choisis au hasard dans un champ de blé d’Inde. Les données, exprimées en millimètres, se trouvent dans le fichier Excel diametres-troncs.xls, disponible sur le site web du cours.
Obtenez la moyenne et l’écart-type.
Obtenez le coefficient de variation.
Obtenez un histogramme.
Obtenez le résumé à cinq nombres.
Obtenez le diagramme en boîte.
Obtenez le 80e centile.
Quel est le rang centile du tronc de diamètre 13.8 mm ?
Numéro 10. Un verger compte 1512 pommiers. Le diagramme suivant représente les proportions de chacune des 5 espèces de pommiers de ce verger (Ida Red, Red Delicious, Golden Delicious, Granny Smith, McIntosh).
AvertissementFigure à compléter
Le diagramme en pointes de tarte de cet exercice n’a pas pu être récupéré à partir du texte des notes.
Complétez le tableau suivant :
Espèce de pommes
Fréquence relative
Nombre de pommiers
Ida Red
Red Delicious
Golden Delicious
Granny Smith
McIntosh
Représentez ces données à l’aide d’un diagramme en bâtons.
Numéro 11. Lors d’une journée de pêche sur le lac St-Pierre, un groupe de pêcheurs ont attrapé 9 achigans, 22 barbottes, 13 brochets, 18 dorés et 47 perchaudes. Représentez ces données à l’aide d’un diagramme en pointes de tarte.
Numéro 12. Voici les longueurs, en cm, des 22 barbottes dont il est question au numéro précédent :
32.2
29.5
29.3
31.9
36.9
30.8
40.6
31.9
26.7
37.9
34.4
30.3
32.9
24.4
32.2
28.3
29.2
31.0
30.6
27.3
30.0
27.6
Calculez la moyenne.
Calculez l’écart-type.
Calculez le coefficient de variation.
Dessinez un histogramme approprié.
Calculez le résumé à cinq nombres.
Dessinez le diagramme en boîte.
Numéro 13. Voici les longueurs, en cm, et les poids, en grammes, des 9 achigans dont il est question au numéro 11 :
Longueur
31.5
34.8
31.1
37.5
30.4
32.6
36.0
27.6
36.8
Poids
542
680
653
694
614
596
606
541
743
Tracez le diagramme de dispersion.
Calculez les moyennes \(\overline{x}\) et \(\overline{y}\).
Calculez les écarts-types \(s_x\) et \(s_y\).
Calculez le coefficient de corrélation \(r\).
Sur le diagramme de dispersion, interprétez les résultats obtenus en (b),
et (d).
Numéro 14. En vous inspirant de votre domaine d’études,
donnez trois exemples de variables quantitatives continues ;
donnez trois exemples de variables quantitatives discrètes ;
donnez trois exemples de variables qualitatives ordinales ;
donnez trois exemples de variables qualitatives nominales.
Numéro 15. On a mesuré les diamètres des troncs (en cm) ainsi que les hauteurs (en mètres) de 20 érables à sucre. Ces observations se trouvent dans le fichier Erables.xls disponible sur le site web du cours.
Calculez, à la main, les statistiques descriptives usuelles. Comparez ensuite avec les valeurs que vous obtiendrez avec R-Commander.
Dessinez à la main les histogrammes appropriés. Comparez ensuite avec les histogrammes que vous obtiendrez avec R-Commander.
Dessinez à la main les diagrammes en boîte appropriés. Comparez ensuite avec les diagrammes en boîte que vous obtiendrez avec R-Commander.
Dessinez à la main le diagramme de dispersion. Comparez ensuite avec le diagramme de dispersion que vous obtiendrez avec R-Commander.